에러 로그만 붙여 넣고 "원인이 뭐야?"라고 물으면 생성형 AI는 누구에게나 맞는 일반론을 답합니다. 환경, 증상이 시작된 시각과 직전 변경, 이미 확인한 것, 원하는 답의 형식을 함께 주면 원인 후보가 좁혀지고 바로 실행할 확인 명령까지 받을 수 있습니다. 로그는 필요한 구간만 잘라 민감 정보를 가린 뒤 넣고, 받은 답은 읽기 전용 명령으로 검증한 다음에 조치합니다.
1. 로그만 붙여 넣으면 생기는 일
같은 "502 Bad Gateway"라도 원인은 백엔드 프로세스가 죽었는지, 포트가 바뀌었는지, 방화벽이 막았는지, 타임아웃인지에 따라 전혀 다릅니다. 로그 한 줄에는 이 구분에 필요한 정보가 대부분 빠져 있어서, 모델은 가능한 원인을 모두 나열하는 답을 할 수밖에 없습니다.
| 구분 | 로그만 넣었을 때 | 맥락을 함께 넣었을 때 |
| 원인 후보 | 가능한 원인 5~10개를 비슷한 비중으로 나열 |
환경과 변경 이력에 맞는 후보 2~3개로 좁혀짐 |
| 확인 방법 | "로그를 확인하세요" 같은 일반적인 안내 |
후보마다 바로 실행할 확인 명령 |
| 다음 질문 | 무엇을 더 물어야 할지 모호함 | 명령 결과를 붙여 다시 물으며 범위를 좁혀 감 |
2. 프롬프트의 기본 구조
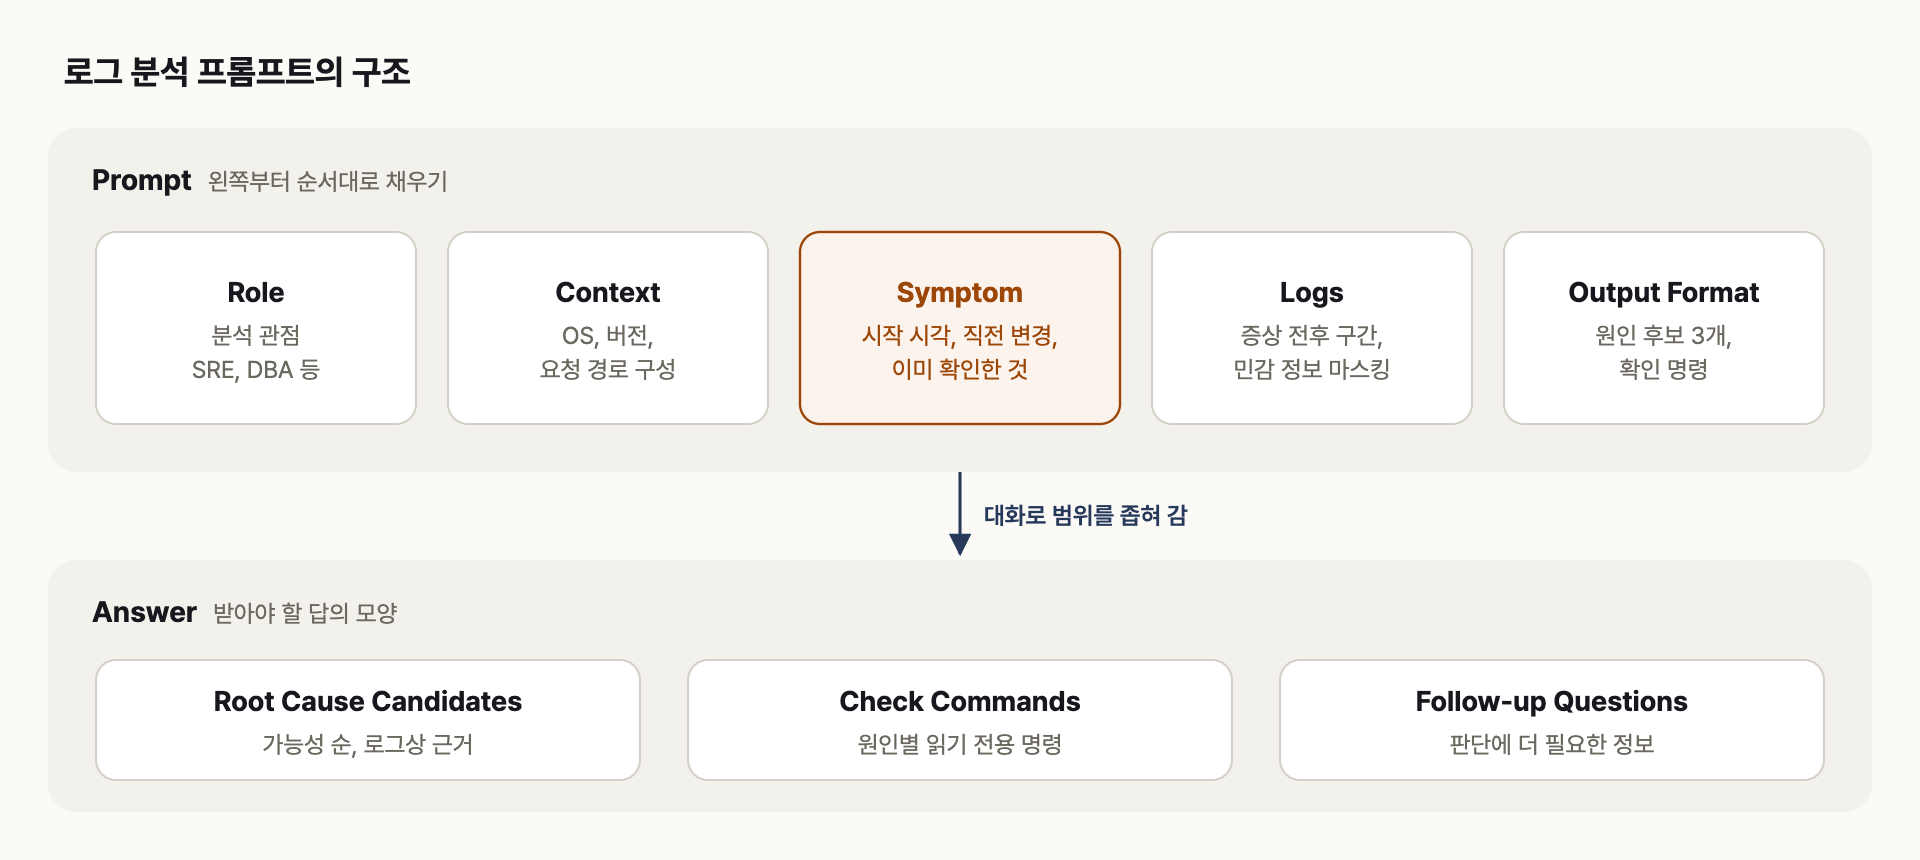
역할, 환경, 증상, 로그, 요청 형식 순서로 채우는 로그 분석 프롬프트의 구조
| 구성 요소 | 넣을 내용 | 예 |
| 역할 | 어떤 관점으로 볼지 | 리눅스 서버와 Nginx를 운영하는 SRE 관점으로 분석 |
| 환경 | OS, 버전, 구성, 네트워크 경로 | Ubuntu 24.04, Nginx 리버스 프록시 → 같은 서버의 8080 앱 |
| 증상 | 언제부터, 어떤 범위로, 직전 변경과 이미 확인한 것 |
14시 배포 직후부터 전체 요청 502, Nginx 재시작은 효과 없음 |
| 로그 | 증상 시각 전후의 필요한 구간 (민감 정보는 마스킹) |
error.log 14:00~14:05, 앱 로그 같은 구간 |
| 요청 형식 | 답을 어떤 모양으로 받을지 | 가능성 높은 순 원인 3개와 근거, 원인별 확인 명령 |
이 중 가장 효과가 큰 것은 증상에 적는 "직전 변경"과 "이미 확인한 것"입니다. 장애는 배포나 설정 변경 직후에 생기는 경우가 많고, 이미 해 본 조치를 알려 주면 모델이 같은 제안을 반복하지 않기 때문입니다.
3. 바로 쓰는 템플릿
[역할]
너는 리눅스 서버와 웹 서비스를 운영하는 SRE야. 추측은 추측이라고 표시해 줘.

[환경]
- OS / 버전:
- 구성: (예: 사용자 → LB → Nginx → 앱:8080 → DB)
- 관련 설정 파일 요약:

[증상]
- 시작 시각:
- 영향 범위: (전체 / 일부 경로 / 일부 사용자)
- 직전 변경: (배포, 설정 변경, 인증서 교체 등)
- 이미 확인한 것:

[로그]
(증상 시각 전후 5~10분, 민감 정보 마스킹)

[요청]
1. 가능성이 높은 순서로 원인 후보 3개와 로그상 근거
2. 원인별로 바로 실행할 확인 명령 (읽기 전용 명령 우선)
3. 원인이 확인된 뒤의 조치 방법과 되돌리는 방법
4. 판단에 더 필요한 정보가 있으면 먼저 질문
요청 4번을 넣어 두면 정보가 부족할 때 모델이 억지로 결론을 내리지 않고 필요한 것을 되묻습니다. 한 번에 정답을 받기보다, 확인 명령의 결과를 다시 붙여 가며 두세 번 대화로 범위를 좁히는 것이 실제로는 더 빠릅니다.
4. 예시 1: Nginx 502 Bad Gateway
배포 직후 모든 요청이 502를 반환하는 상황입니다. Nginx error.log에는 다음과 같은 줄이 반복됩니다.
2026/09/25 14:02:11 [error] 1234#1234: *5678 connect() failed (111: Connection refused)
  while connecting to upstream, client: x.x.x.x, server: app.example.com,
  request: "GET /api/orders HTTP/1.1", upstream: "http://x.x.x.x:8080/api/orders"
템플릿의 환경과 증상에 "Nginx와 앱이 같은 서버, 14시 배포 직후부터 전체 502, Nginx 재시작은 효과 없음"을 적고 이 로그를 넣습니다. "Connection refused"(오류 번호 111)는 대상 포트에서 연결을 받는 프로세스가 없다는 뜻이라서, 좋은 답이라면 네트워크 차단보다 앱 프로세스가 8080에서 떠 있지 않은 쪽을 먼저 의심하고 다음 같은 확인 명령을 제시해야 합니다.
# 8080에서 대기 중인 프로세스가 있는지
sudo ss -ltnp | grep ':8080'

# 앱 서비스 상태와 최근 로그
systemctl status app --no-pager
journalctl -u app --since "2026-09-25 13:55" --until "2026-09-25 14:10" --no-pager
답이 이 방향이 아니라 방화벽 규칙이나 DNS부터 바꾸라고 한다면, 프롬프트에 구성(같은 서버의 8080)이 빠졌거나 모델이 로그의 근거를 제대로 읽지 않은 것입니다. 이때는 "로그의 어떤 부분이 그 근거인지"를 되물으면 잘못된 추론이 드러납니다.
5. 예시 2: Kubernetes CrashLoopBackOff
CrashLoopBackOff는 컨테이너가 계속 비정상 종료되어 kubelet이 재시작 간격을 늘려 가며(10초, 20초, 40초 … 최대 5분) 다시 띄우고 있는 상태입니다. 상태 이름만으로는 원인을 알 수 없으므로, 프롬프트에는 이미 종료된 이전 컨테이너의 정보가 들어가야 합니다.
# 종료 사유와 종료 코드(Last State), 이벤트
kubectl describe pod <pod-name> -n <namespace>

# 직전에 죽은 컨테이너의 로그 (현재 로그만 보면 원인이 없는 경우가 많음)
kubectl logs <pod-name> -n <namespace> -c <container> --previous
describe 결과의 Last State에 Reason: OOMKilled, Exit Code: 137이 있다면 메모리 한도 초과로 강제 종료된 것이고, Reason: Error와 다른 종료 코드라면 애플리케이션 자체 오류이므로 --previous 로그가 핵심 근거가 됩니다. 두 출력을 함께 넣고 "리소스 요청과 한도(resources)도 함께 보고 판단해 줘"라고 요청하면, 한도 조정인지 코드 문제인지를 구분한 답을 받을 수 있습니다.
| 상황 | 프롬프트에 꼭 넣을 것 |
| 웹 서버 5xx | error.log와 앱 로그의 같은 시각 구간, 프록시에서 앱까지의 구성 |
| 컨테이너 재시작 반복 |
kubectl describe pod 결과, --previous 로그, resources 설정 |
| 배포 직후 장애 | 바뀐 설정이나 코드의 diff, 이전 버전에서는 정상이었다는 사실 |
| 간헐적 오류 | 발생 빈도와 시각 패턴, 정상 구간 로그와 비교 |
6. 로그를 넣기 전과 답을 받은 뒤
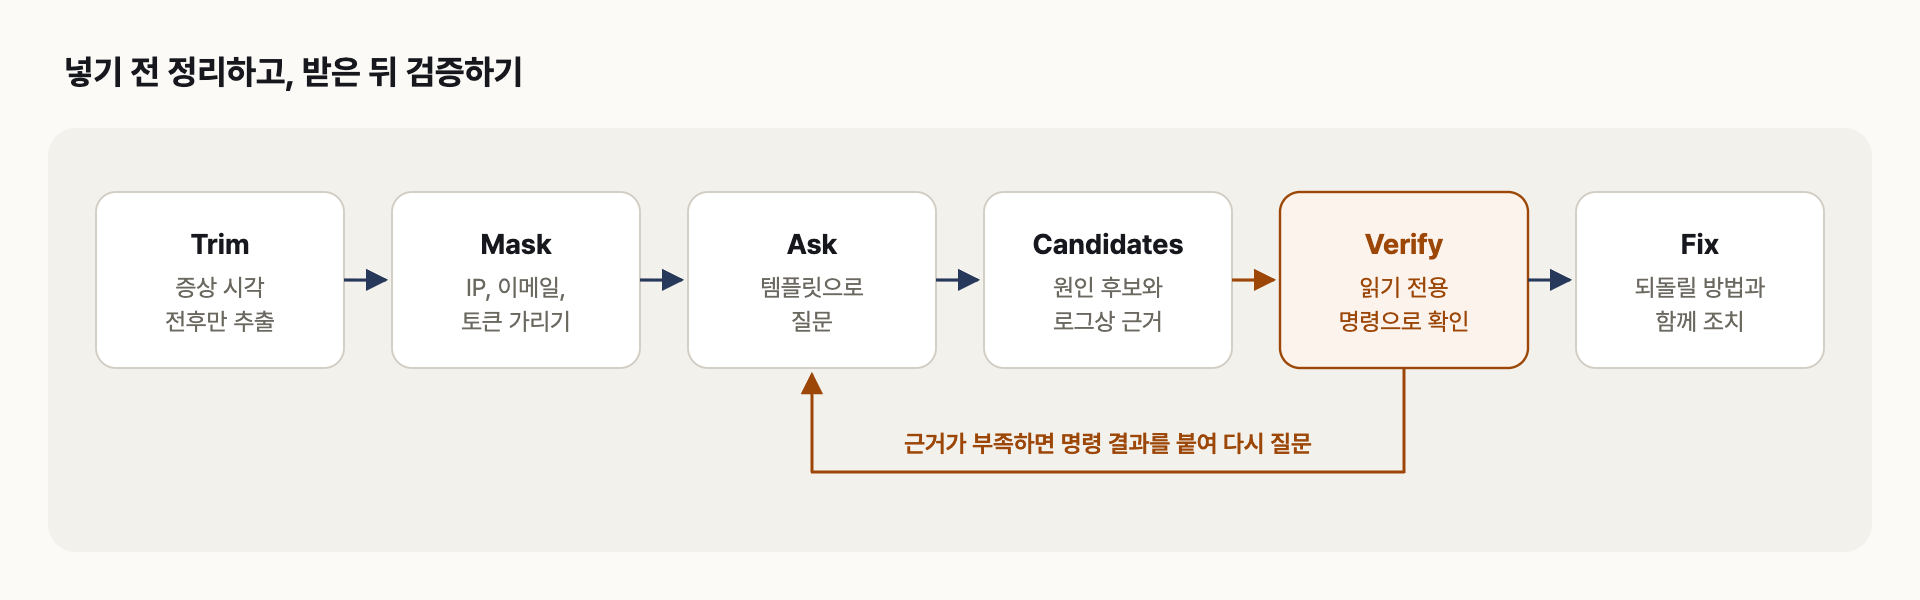
로그를 잘라 마스킹한 뒤 묻고, 받은 원인 후보는 읽기 전용 명령으로 검증한 다음 조치하는 흐름
로그 전체를 붙여 넣으면 컨텍스트 윈도우를 낭비하고 민감 정보가 섞이기 쉽습니다. 증상 시각 전후만 잘라 낸 뒤 IP, 이메일, 토큰을 가리고 넣습니다. 아래 명령은 GNU sed 기준이며, 분석에 필요한 포트 번호와 경로는 남겨 둡니다.
# 증상 시각 전후만 추출 (Nginx error.log는 두 번째 필드가 시각)
awk '$1 == "2026/09/25" && $2 >= "13:55:00" && $2 <= "14:10:00"' \
  /var/log/nginx/error.log > incident.log

# IP, 이메일, 비밀번호·토큰 값 마스킹
sed -E \
  -e 's/([0-9]{1,3}\.){3}[0-9]{1,3}/x.x.x.x/g' \
  -e 's/[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}/user@example.com/g' \
  -e 's/(password|passwd|token|secret|api_?key)=[^ &"]+/\1=****/gI' \
  incident.log > incident-masked.log
자동 마스킹은 정해진 패턴만 가리므로 사내 호스트명이나 고객 이름처럼 형식이 제각각인 값은 붙여 넣기 전에 눈으로 한 번 더 확인합니다. 어떤 정보를 넣으면 안 되는지는 다음 글에서 따로 정리하겠습니다.
| 점검 항목 | 확인 방법 |
| 명령과 옵션이 실제로 있는지 |
--help, man 페이지, 공식 문서로 확인 (없는 옵션을 지어내는 경우가 있음) |
| 원인의 근거 | 답이 로그의 어느 줄을 근거로 했는지 되묻기 |
| 변경 명령 | 재시작, 삭제, 설정 변경은 원인 확인 후 되돌리는 방법과 함께 실행 |
| 버전 차이 | 답의 설정 문법이 내 버전과 맞는지 확인 |
저는 AI가 준 명령을 운영 서버에서 바로 실행하지 않고, 상태를 바꾸지 않는 조회 명령부터 돌려 원인을 확인하는 규칙을 둡니다. 생성형 AI는 그럴듯하지만 틀린 답을 자신 있게 내놓을 수 있고, 운영 환경에서는 잘못된 재시작 한 번이 원래 장애보다 큰 영향을 줄 수 있기 때문입니다.
7. 정리
- 로그와 함께 역할, 환경, 증상(직전 변경과 이미 확인한 것), 원하는 답의 형식을 넣어야 원인 후보가 좁혀집니다.
- 502는 upstream 로그와 앱 상태를, CrashLoopBackOff는 describe의 Last State와 직전 컨테이너의 로그를 함께 넣습니다.
- 로그는 필요한 구간만 잘라 마스킹하고, 받은 답은 읽기 전용 명령으로 검증한 뒤 조치합니다.
참고
'AI > 활용' 카테고리의 다른 글
| [AI] 생성형 AI 업무 활용 시 보안 주의점 정리 (0) | 2026.09.26 |
|---|---|
| [AI] ChatGPT, Gemini, Claude 비교 (0) | 2026.09.25 |
