Kubernetes는 여러 서버를 하나의 클러스터로 묶고, 사용자가 선언한 상태대로 컨테이너를 배치하고 유지하는 플랫폼입니다. 이 글에서는 Control Plane과 Node를 이루는 구성 요소, kubectl apply 한 번이 컨테이너 실행까지 이어지는 흐름을 정리하고, kind로 로컬 Docker 위에 노드 3대짜리 클러스터를 만듭니다.
컨테이너부터 Kubernetes까지 시리즈 6편이자 2부의 첫 글입니다. 이전 글은 [Docker] Docker Compose로 여러 컨테이너 실행 정리이고, 전체 순서는 시리즈 목차에 있습니다.
1. Kubernetes가 필요한 이유
5편의 Compose는 서버 한 대 안에서 여러 컨테이너를 묶어 실행합니다. 서버가 여러 대로 늘어나면 어느 서버에 컨테이너를 둘지, 서버 하나가 꺼졌을 때 그 위의 컨테이너를 어디서 다시 띄울지를 사람이 정해야 합니다. Kubernetes는 이 일을 대신합니다.
Kubernetes에서는 "nginx 컨테이너 3개를 항상 실행"처럼 원하는 상태(desired state)를 선언합니다. 그러면 Kubernetes가 실제 상태를 계속 확인하면서 둘이 다르면 맞춥니다. 에어컨을 24도로 맞춰 두면 실내 온도에 따라 알아서 켜지고 꺼지는 것과 같습니다.
| 항목 | Docker Compose | Kubernetes |
| 범위 | 서버 한 대 | 서버 여러 대를 묶은 클러스터 |
| 실행 단위 | 컨테이너(service) | Pod |
| 장애 대응 | restart 정책으로 같은 서버에서 재시작 | 다른 노드에 다시 배치 |
| 확장 | --scale 옵션으로 수동 조정 | HPA로 부하에 따라 자동 조정 |
| 설정 파일 | compose.yaml 하나 | Deployment, Service 등 리소스마다 YAML |
2. 클러스터 구성
클러스터는 전체를 관리하는 Control Plane과, 실제 컨테이너가 실행되는 Node로 나뉩니다. 회사에 비유하면 Control Plane은 일을 받아 배정하는 본사이고, Node는 배정받은 일을 하는 지점입니다.
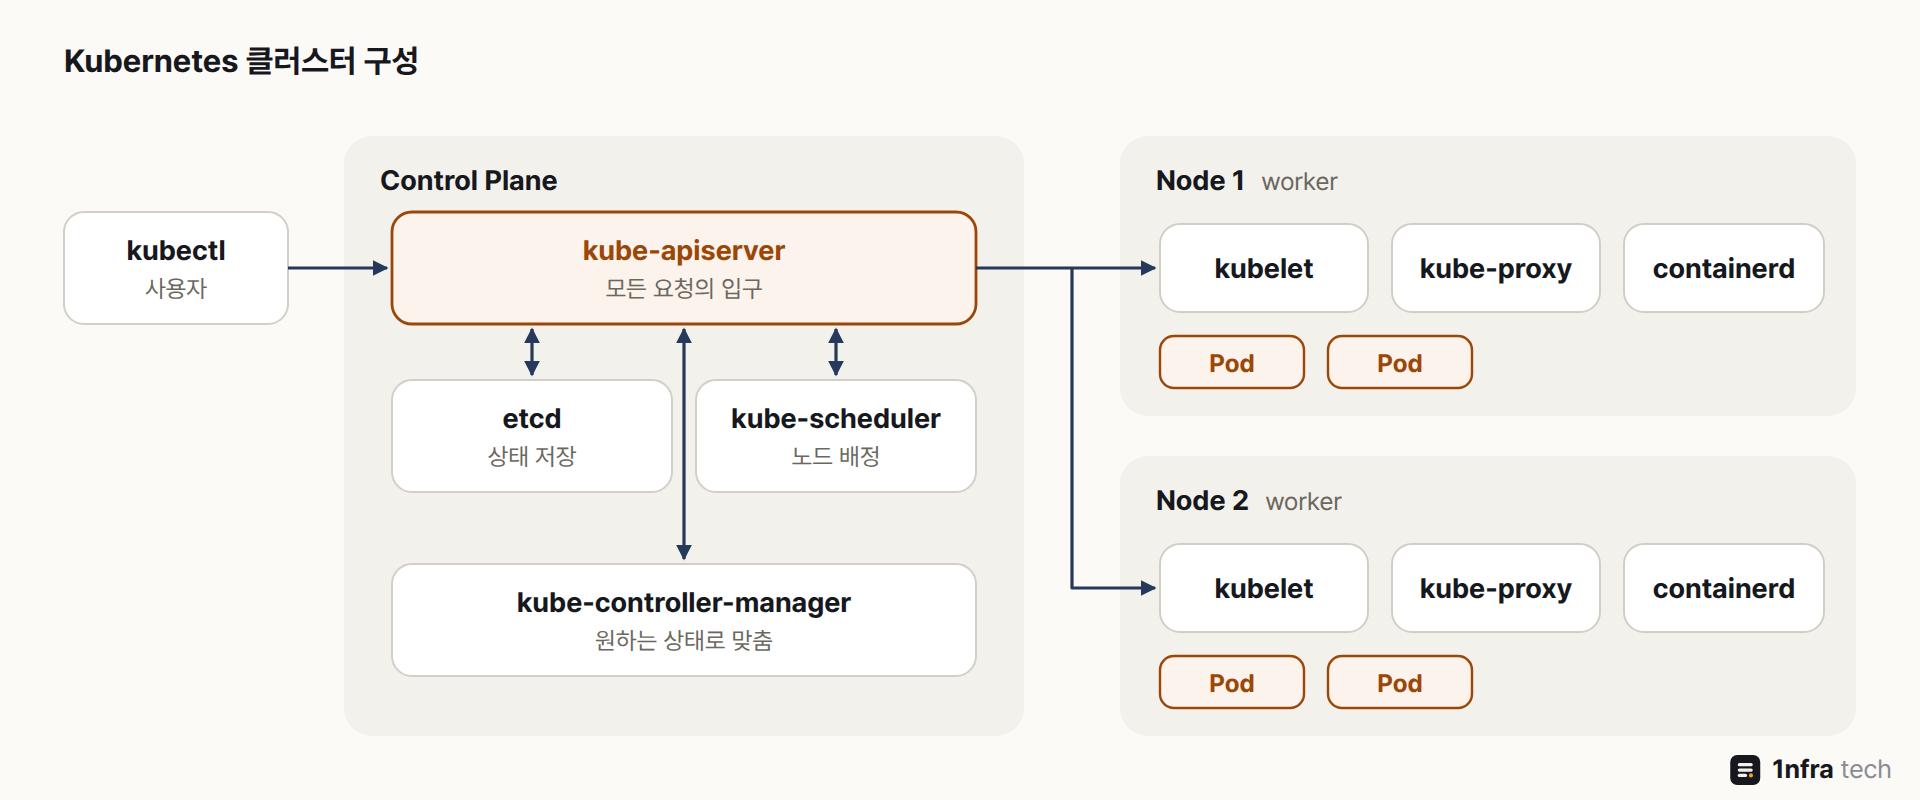
모든 요청은 kube-apiserver를 거치고, 클러스터 상태는 etcd에만 저장됩니다
| 구성 요소 | 위치 | 역할 |
| kube-apiserver | Control Plane | 모든 요청을 받는 입구 인증과 권한을 확인한 뒤 etcd에 읽고 씀 |
| etcd | Control Plane | 클러스터의 모든 상태를 저장하는 key-value 저장소 |
| kube-scheduler | Control Plane | 아직 노드가 정해지지 않은 Pod를 어느 노드에 둘지 결정 |
| kube-controller-manager | Control Plane | Deployment, Node 등 리소스마다 원하는 상태와 실제 상태를 맞추는 컨트롤러 묶음 |
| kubelet | Node | 자기 노드에 배정된 Pod를 실행하고 상태를 보고 |
| kube-proxy | Node | Service로 들어온 트래픽을 Pod로 보내는 규칙(iptables 등)을 관리 |
| 컨테이너 런타임 | Node | 실제로 컨테이너를 실행 1편에서 본 containerd와 runc |
클라우드에서는 로드밸런서나 디스크를 만들어 주는 cloud-controller-manager가 더해집니다. AKS 같은 관리형 서비스는 Control Plane을 클라우드가 운영하므로 사용자는 Node만 관리하면 됩니다. AKS 구성은 [Azure] Azure Kubernetes Service 구성 정리에 정리했습니다.
3. kubectl apply 이후 흐름
구성 요소끼리는 서로 직접 명령하지 않습니다. 모두 kube-apiserver를 지켜보다가(watch) 자기가 처리할 일이 생기면 처리하고 결과를 다시 기록합니다. Pod 3개를 실행하는 Deployment 하나를 만들 때의 흐름은 아래와 같습니다.
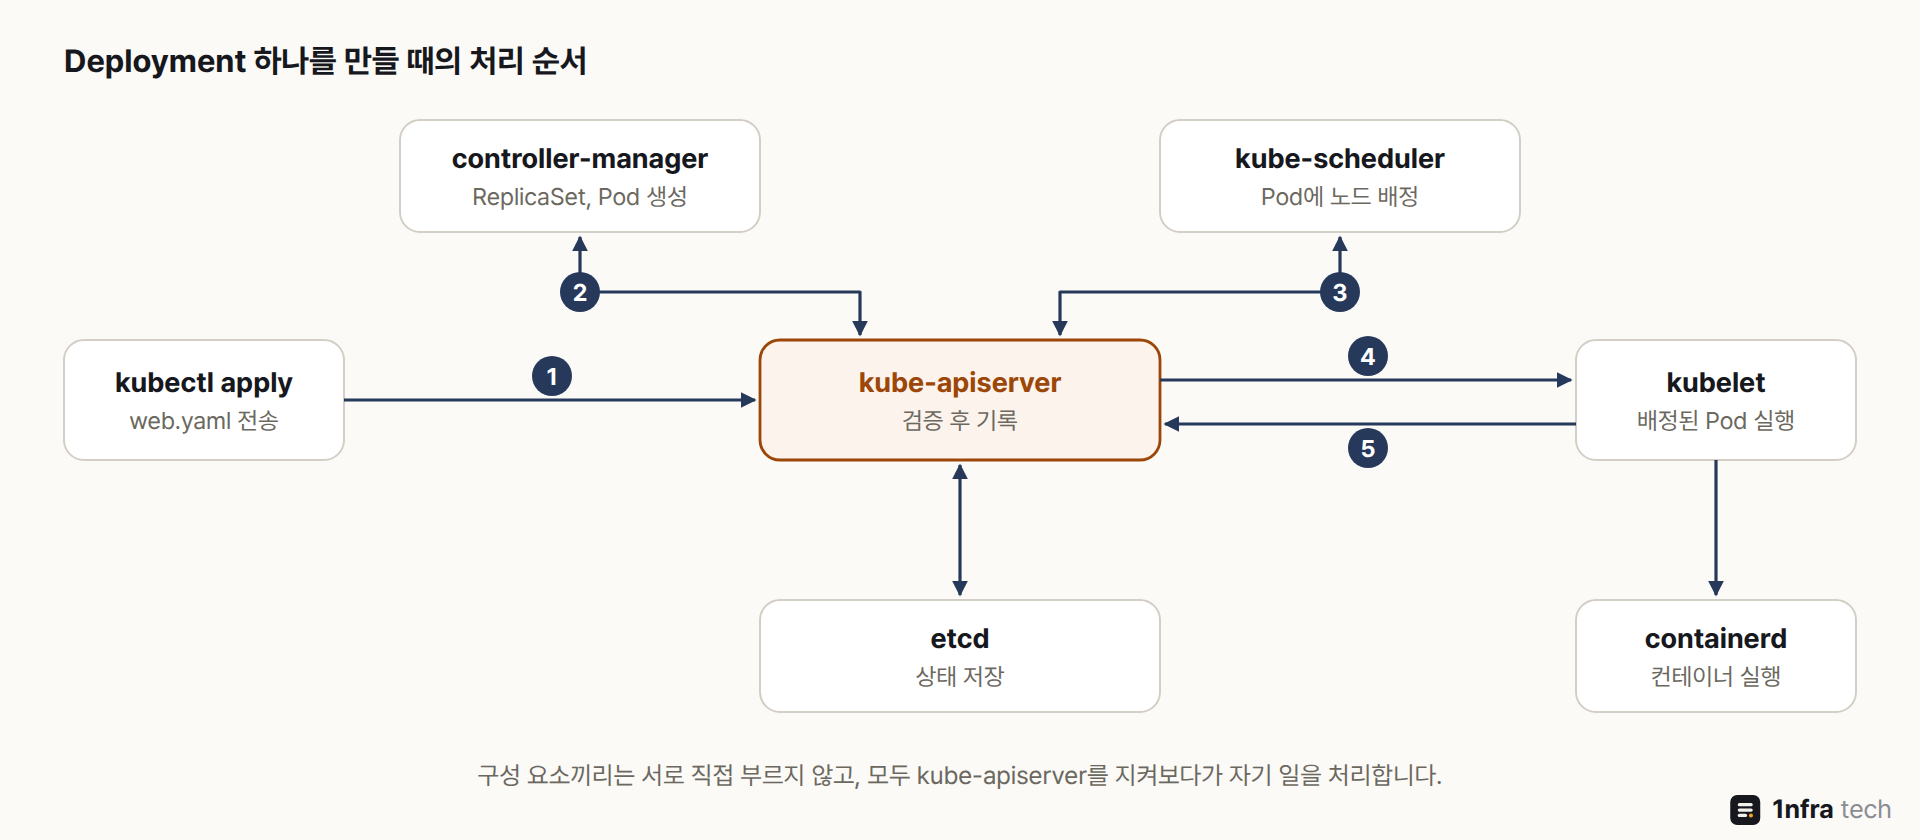
번호 순서대로 처리되며, 모든 기록과 조회는 kube-apiserver를 거칩니다
| 순서 | 처리 |
| 1 | kubectl이 YAML을 kube-apiserver로 보내고, apiserver가 검증한 뒤 etcd에 저장 |
| 2 | controller-manager가 새 Deployment를 보고 ReplicaSet과 Pod 3개를 만듦 |
| 3 | kube-scheduler가 노드가 비어 있는 Pod를 보고 실행할 노드를 정해 기록 |
| 4 | 해당 노드의 kubelet이 자기에게 배정된 Pod를 보고 containerd로 컨테이너 실행 |
| 5 | kubelet이 Pod 상태(Running)를 apiserver에 보고 |
이렇게 모든 상태가 etcd에 모여 있어서, 구성 요소 하나가 잠시 멈춰도 다시 살아나면 etcd의 상태를 보고 이어서 처리합니다. 반대로 etcd를 잃으면 클러스터가 무엇을 실행해야 하는지 알 수 없게 되므로 etcd는 클러스터에서 가장 중요한 데이터입니다.
4. 직접 해 보기
kind(Kubernetes IN Docker)는 Docker 컨테이너 하나를 노드 하나로 써서 로컬에 클러스터를 만드는 도구입니다. 1부에서 쓴 Docker만 있으면 되고, 서버가 여러 대 없어도 여러 노드 구성을 연습할 수 있습니다. 먼저 kind와 kubectl을 설치합니다.
| OS | 설치 방법 |
| macOS | brew install kind kubectl |
| Windows | winget install Kubernetes.kind winget install -e --id Kubernetes.kubectl |
| Linux | kind: kind Quick Start의 릴리스 바이너리 설치 kubectl: Kubernetes 공식 문서의 curl 설치 |
노드 3대(control-plane 1대, worker 2대)를 만드는 설정 파일입니다. extraPortMappings는 8편에서 NodePort로 접속할 수 있도록 호스트의 30080 포트를 노드에 미리 연결해 둔 것이고, 클러스터를 만들 때만 정할 수 있습니다.
# kind-config.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
nodes:
- role: control-plane
  extraPortMappings:
  - containerPort: 30080
    hostPort: 30080
- role: worker
- role: worker
클러스터를 만들고 노드를 확인합니다.
kind create cluster --config kind-config.yaml
kubectl get nodes
kind-control-plane, kind-worker, kind-worker2 세 노드가 Ready로 나오고 VERSION은 v1.37.0입니다. 이름을 따로 주지 않으면 클러스터 이름은 kind가 되고, kubectl의 접속 대상(context)은 kind-kind로 자동 설정됩니다.
2장의 구성 요소가 실제로 어디서 실행되는지 확인합니다.
kubectl get pods -n kube-system -o wideetcd, kube-apiserver, kube-controller-manager, kube-scheduler는 이름 뒤에 -kind-control-plane이 붙어 control-plane 노드에만 하나씩 있습니다. kubelet이 노드의 /etc/kubernetes/manifests 폴더에 있는 YAML을 읽어 직접 띄우는 static Pod입니다. kube-proxy와 kindnet(kind의 기본 네트워크 플러그인)은 노드마다 하나씩 3개가 있고, kubelet과 containerd는 Pod가 아니라 노드 안의 프로세스라서 목록에 나오지 않습니다.
docker ps를 실행하면 kind-control-plane, kind-worker, kind-worker2 컨테이너 3개가 보입니다. 노드가 서버가 아니라 Docker 컨테이너라는 점만 다르고, 안에서 도는 구성 요소는 실제 서버로 만든 클러스터와 같습니다. 이 클러스터는 11편까지 계속 쓰고, 지울 때는 kind delete cluster를 실행합니다.
5. 운영 시 주의점
| 항목 | 조치 |
| etcd 백업 | 클러스터 상태가 모두 etcd에 있으므로 etcdctl snapshot save로 주기적으로 백업 관리형 서비스는 클라우드가 관리 |
| Control Plane 이중화 | etcd는 과반수가 살아 있어야 동작 3대면 1대, 5대면 2대 장애까지 견딤 |
| kubectl 버전 | 클러스터와 마이너 버전 1 차이까지만 지원 v1.37 kubectl은 v1.36~v1.38 클러스터에서 사용 |
| cgroup v1 | v1.35부터 kubelet이 cgroup v1 호스트에서 기본적으로 시작하지 않음 노드 OS는 cgroup v2로 준비 |
| kind 용도 | 학습과 테스트용 운영 클러스터는 kubeadm으로 직접 구성하거나 AKS 같은 관리형 서비스 사용 |
6. 정리
- Kubernetes는 원하는 상태를 선언하면 여러 서버에 컨테이너를 배치하고, 실제 상태가 달라지면 다시 맞춥니다.
- Control Plane은 apiserver, etcd, scheduler, controller-manager로, Node는 kubelet, kube-proxy, 컨테이너 런타임으로 이루어집니다.
- 모든 구성 요소는 apiserver를 통해서만 상태를 읽고 쓰고, 그 상태는 etcd에 저장되므로 etcd 백업이 가장 중요합니다.
다음 글 7편에서는 클러스터에 앱을 올리는 단위인 Pod와, Pod의 개수와 버전을 관리하는 ReplicaSet, Deployment를 다룹니다.
참고
'DevOps > Kubernetes' 카테고리의 다른 글
| [Kubernetes] ConfigMap과 Secret 정리 (0) | 2026.09.28 |
|---|---|
| [Kubernetes] Service와 Ingress, Gateway API 정리 (0) | 2026.09.28 |
| [Kubernetes] Pod, ReplicaSet, Deployment 정리 (0) | 2026.09.28 |
| [Kubernetes] 토큰 만료 후 워커 노드 추가 (0) | 2021.11.02 |
| [Kubernetes] Dashboard 설치하고 토큰으로 접속 (0) | 2021.07.05 |
