AKS에서 GPU 워크로드를 돌리려면 GPU VM 크기로 별도 노드풀을 만들고, GPU를 쿠버네티스 자원(nvidia.com/gpu)으로 보이게 하는 NVIDIA 드라이버와 디바이스 플러그인을 갖춰야 합니다. AKS는 드라이버만 설치하는 기본 방식, 드라이버부터 디바이스 플러그인과 메트릭 수집까지 맡는 관리형 GPU 노드풀(미리 보기), 모두 직접 설치하는 방식을 제공합니다. VM 크기, 테인트, 설치 방식, MIG 설정은 노드풀을 만들 때 정해져서 나중에 바꿀 수 없으므로 처음에 설계를 끝내야 합니다.
1. GPU가 파드까지 전달되는 구조
GPU VM으로 노드를 만들었다고 해서 파드가 바로 GPU를 쓸 수 있는 것은 아닙니다. OS가 GPU를 인식하려면 NVIDIA 드라이버가 필요하고, 쿠버네티스 스케줄러가 GPU를 자원으로 인식하려면 디바이스 플러그인이 노드의 GPU를 kubelet에 nvidia.com/gpu라는 자원으로 등록해야 합니다. 파드는 이 자원을 요청해서 GPU를 받습니다.
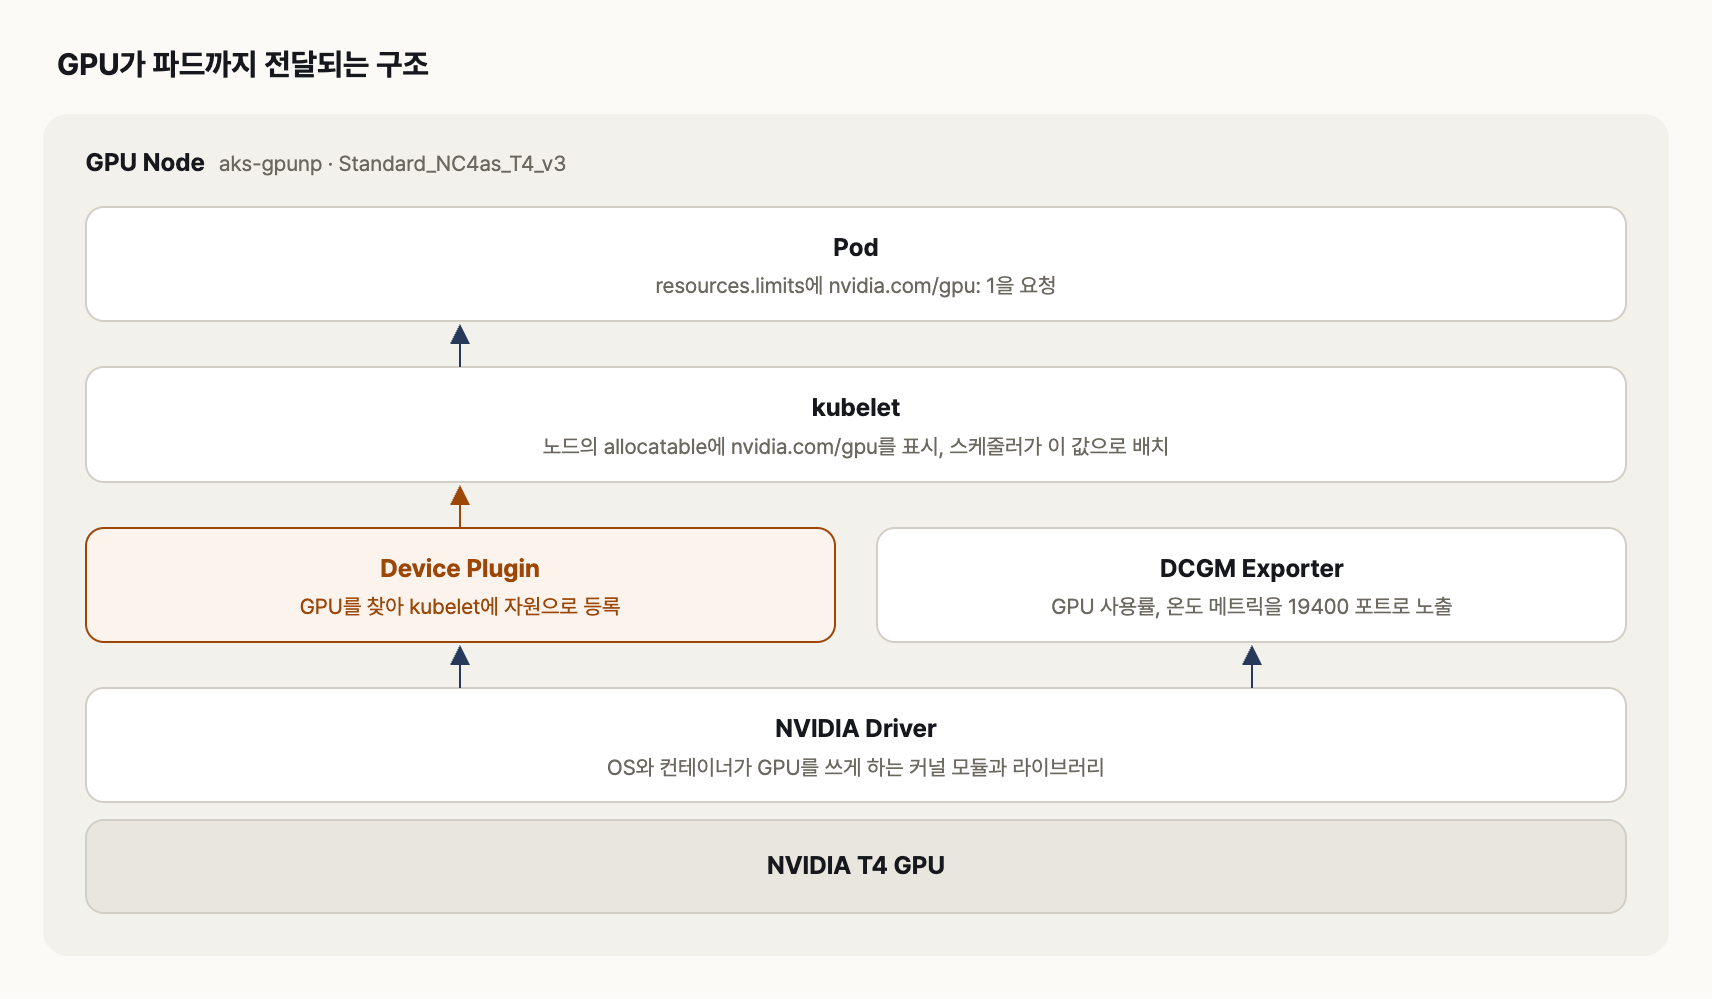
드라이버 위에서 디바이스 플러그인이 GPU를 등록해야 파드가 nvidia.com/gpu를 요청할 수 있습니다
| 구성 요소 | 역할 |
| NVIDIA Driver | OS와 컨테이너가 GPU 하드웨어를 쓰게 하는 커널 모듈과 라이브러리 |
| Device Plugin | GPU를 kubelet에 nvidia.com/gpu 자원으로 등록, 이것이 없으면 파드가 GPU를 요청할 수 없음 |
| DCGM Exporter | GPU 사용률, 온도 같은 메트릭을 Prometheus 형식으로 19400 포트에 노출 |
| GPU Health | Node Problem Detector가 디바이스 플러그인과 DCGM 이상을 노드 상태로 표시 |
GPU 자체의 메모리 용량과 모델 크기의 관계는 LLM 추론 GPU 메모리 계산 정리에서 다루었습니다. 이 글은 그 GPU를 AKS에서 파드에 연결하는 방법에 집중합니다.
2. 설치 방식 세 가지
AKS 문서는 GPU 소프트웨어를 누가 설치하고 관리하는지에 따라 세 가지 방식을 설명합니다. 노드풀을 만들 때 옵션을 따로 주지 않으면 드라이버만 설치하는 방식이 적용됩니다.
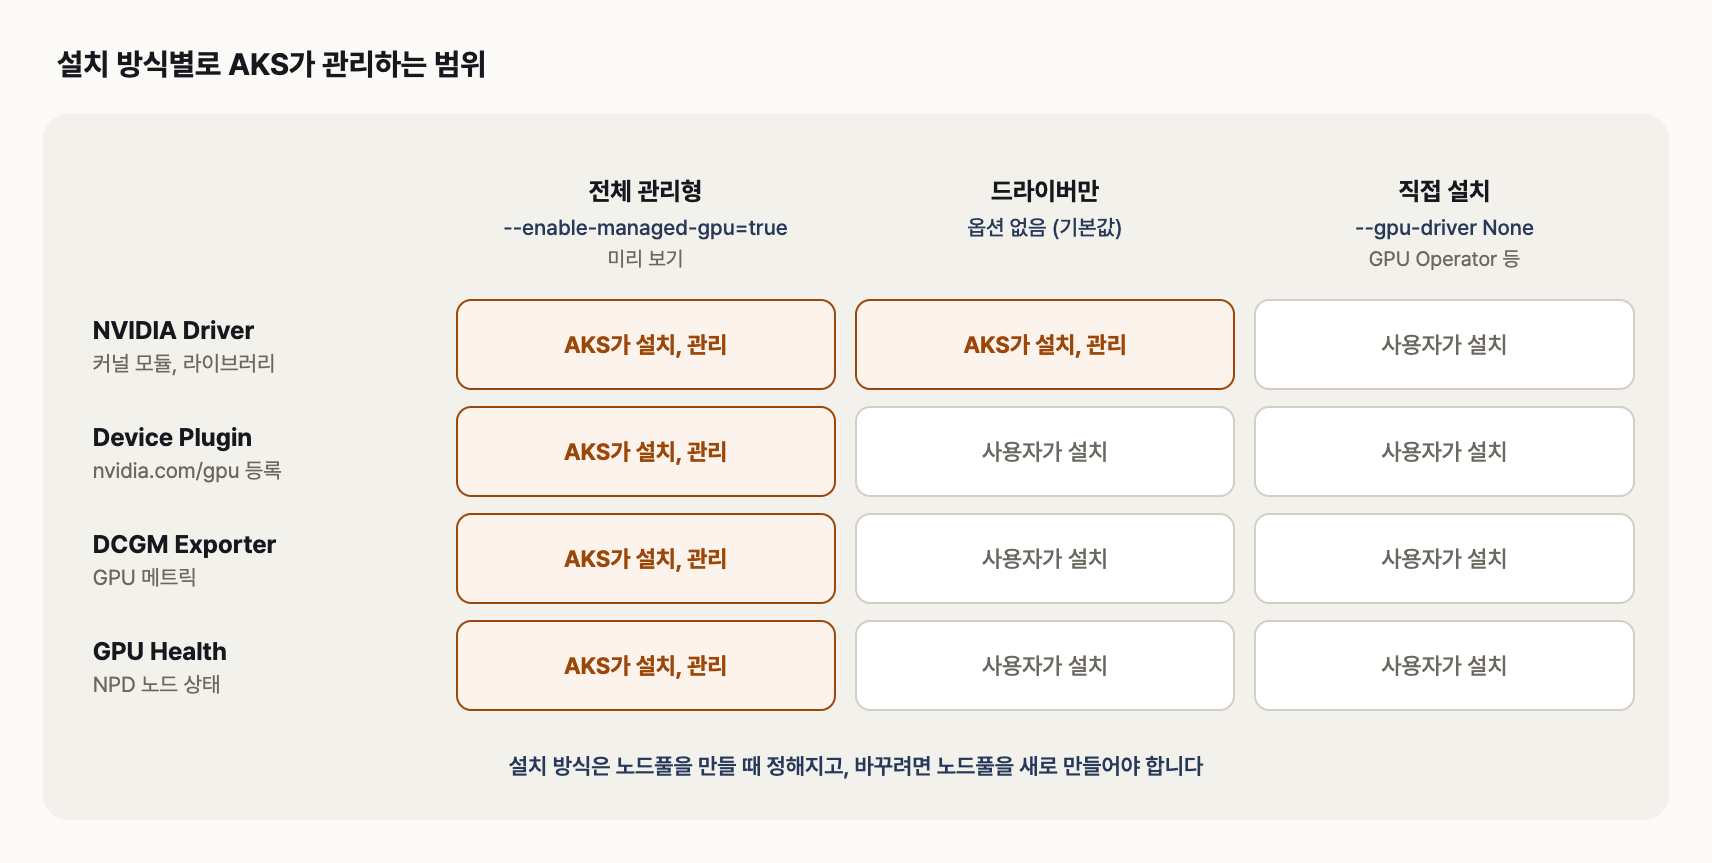
관리형은 네 가지를 모두, 기본 방식은 드라이버만 AKS가 맡습니다
| 방식 | 특징과 주의점 |
| 전체 관리형 | --enable-managed-gpu=true, 미리 보기 기능이라 aks-preview 확장과 기능 플래그 등록이 필요함, 직접 만든 노드풀에서는 클러스터 오토스케일러를 지원하지 않음 |
| 드라이버만 (기본값) |
드라이버는 AKS가 관리, 디바이스 플러그인은 직접 배포해야 nvidia.com/gpu가 보임 |
| 직접 설치 | --gpu-driver None, 드라이버까지 설치하지 않음, NVIDIA GPU Operator로 전체를 관리할 때 사용 |
Microsoft는 대부분의 경우 관리형 GPU 노드풀을 권장합니다. 다만 저는 운영 환경에는 기본 방식에 디바이스 플러그인을 직접 배포하는 구성을 쓰고, 관리형은 개발 클러스터에서 먼저 써 보겠습니다. 관리형은 아직 미리 보기라 지원 범위가 정식 기능과 다르고, 직접 만든 관리형 노드풀에서는 오토스케일러를 쓸 수 없어, 노드 자동 프로비저닝(NAP)을 쓰지 않는 클러스터에서는 GPU 노드를 0대까지 줄였다가 늘리는 비용 절감 구성을 할 수 없기 때문입니다.
3. GPU 노드풀 만들기
GPU 노드풀은 기존 클러스터에 사용자 노드풀로 추가합니다. 아래는 AKS 문서의 기본 방식 예시이고, 이름은 예시 값입니다.
az aks nodepool add \
    --resource-group myResourceGroup \
    --cluster-name myAKSCluster \
    --name gpunp \
    --node-count 1 \
    --node-vm-size Standard_NC4as_T4_v3 \
    --node-taints sku=gpu:NoSchedule \
    --enable-cluster-autoscaler \
    --min-count 1 \
    --max-count 3
| 항목 | 의미와 선택 이유 |
| VM 크기 | --node-vm-size, GPU VM 크기, AKS 문서는 최소 Standard_NC4as_T4_v3를 권장하고 AMD GPU인 NVv4 시리즈는 지원하지 않음 |
| 테인트 | --node-taints, 일반 파드가 비싼 GPU 노드에 들어오지 못하게 막음 |
| 최소 노드 수 | --min-count, 사용자 노드풀은 0까지 가능, GPU 작업이 없을 때 노드를 0대로 줄여 비용을 아낄 수 있음 |
| OS | --os-sku, 생략하면 Ubuntu, AzureLinux도 가능하지만 Azure Linux GPU 노드풀은 자동 보안 패치가 적용되지 않음 |
GPU 관련 옵션이 실제로 어떻게 정의되어 있는지 Azure CLI 2.90.0 도움말에서 확인했습니다.
h=$(az aks nodepool add --help)
echo "$h" | grep -A2 -- '--gpu-driver ' | tr -s ' '
echo "$h" | grep -A1 -- '--gpu-instance-profile ' | tr -s ' '
echo "$h" | grep -A3 -- '--min-count ' | tr -s ' '
--gpu-driver : Whether to install driver for GPU node pool. Possible
values are "Install" or "None". Default is "Install".
Allowed values: Install, None.
--gpu-instance-profile : GPU instance profile to partition multi-gpu Nvidia GPUs.
Allowed values: MIG1g, MIG2g, MIG3g, MIG4g, MIG7g.
--min-count : Minimum nodes count used for autoscaler, when "--enable-
cluster-autoscaler" specified. Please specify the value
in the range of [0, 1000] for user nodepool, and [1,1000]
for system nodepool.
--gpu-driver의 기본값이 Install이라 옵션을 주지 않으면 드라이버가 설치되고, 사용자 노드풀은 min-count를 0으로 둘 수 있다는 점을 확인할 수 있습니다. 관리형 방식의 --enable-managed-gpu와 --gpu-mig-strategy는 기본 CLI에는 없고 aks-preview 확장에 들어 있습니다.
만들 때 정해지는 값
GPU 노드풀에서 가장 주의할 점은 나중에 바꿀 수 없는 값이 많다는 것입니다. 기존 노드풀의 VM 크기를 GPU로 바꾸는 것도 지원하지 않습니다.
| 값 | 바꾸려면 |
| VM 크기, 테인트 | 새 노드풀을 만들고 워크로드를 옮김 |
| 드라이버 설치 여부 | 새 노드풀을 만듦, 업그레이드나 업데이트로는 바뀌지 않음 |
| 관리형 여부, MIG 전략 | 새 노드풀을 만듦 |
| MIG 프로필 | 새 노드풀을 만듦 |
| 오토스케일러 범위 | 언제든 변경 가능 |
그래서 저는 GPU 노드풀을 만들기 전에 어떤 방식으로 설치할지, MIG로 나눌지, 어떤 테인트를 쓸지를 먼저 정해 둡니다. 잘못 만들면 노드풀을 새로 만들고 워크로드를 옮기는 작업을 해야 하기 때문입니다.
4. 디바이스 플러그인 배포
기본 방식은 드라이버만 설치되므로 디바이스 플러그인을 DaemonSet으로 배포해야 nvidia.com/gpu가 노드에 나타납니다. 아래는 AKS 문서에 실린 NVIDIA 디바이스 플러그인 매니페스트에서 주석만 뺀 것입니다. GPU 노드에 테인트를 걸었기 때문에 DaemonSet에도 같은 톨러레이션이 들어 있어야 GPU 노드에서 실행됩니다.
kubectl create namespace gpu-resourcesapiVersion: apps/v1
kind: DaemonSet
metadata:
name: nvidia-device-plugin-daemonset
namespace: gpu-resources
spec:
selector:
matchLabels:
name: nvidia-device-plugin-ds
updateStrategy:
type: RollingUpdate
template:
metadata:
labels:
name: nvidia-device-plugin-ds
spec:
tolerations:
- key: "sku"
operator: "Equal"
value: "gpu"
effect: "NoSchedule"
priorityClassName: "system-node-critical"
containers:
- image: nvcr.io/nvidia/k8s-device-plugin:v0.18.0
name: nvidia-device-plugin-ctr
env:
- name: FAIL_ON_INIT_ERROR
value: "false"
securityContext:
allowPrivilegeEscalation: false
capabilities:
drop: ["ALL"]
volumeMounts:
- name: device-plugin
mountPath: /var/lib/kubelet/device-plugins
volumes:
- name: device-plugin
hostPath:
path: /var/lib/kubelet/device-plugins
배포한 뒤 kubectl describe node로 GPU 노드를 보면 Capacity 항목에 nvidia.com/gpu가 표시됩니다. 이 값이 보이지 않으면 파드가 GPU를 요청해도 배치되지 않으므로, 저는 GPU 노드풀을 만든 직후 이 값부터 확인합니다.
5. 파드에서 GPU 쓰기
GPU를 쓰는 파드에는 두 가지가 필요합니다. GPU 노드의 테인트를 허용하는 톨러레이션과 resources.limits의 nvidia.com/gpu입니다.
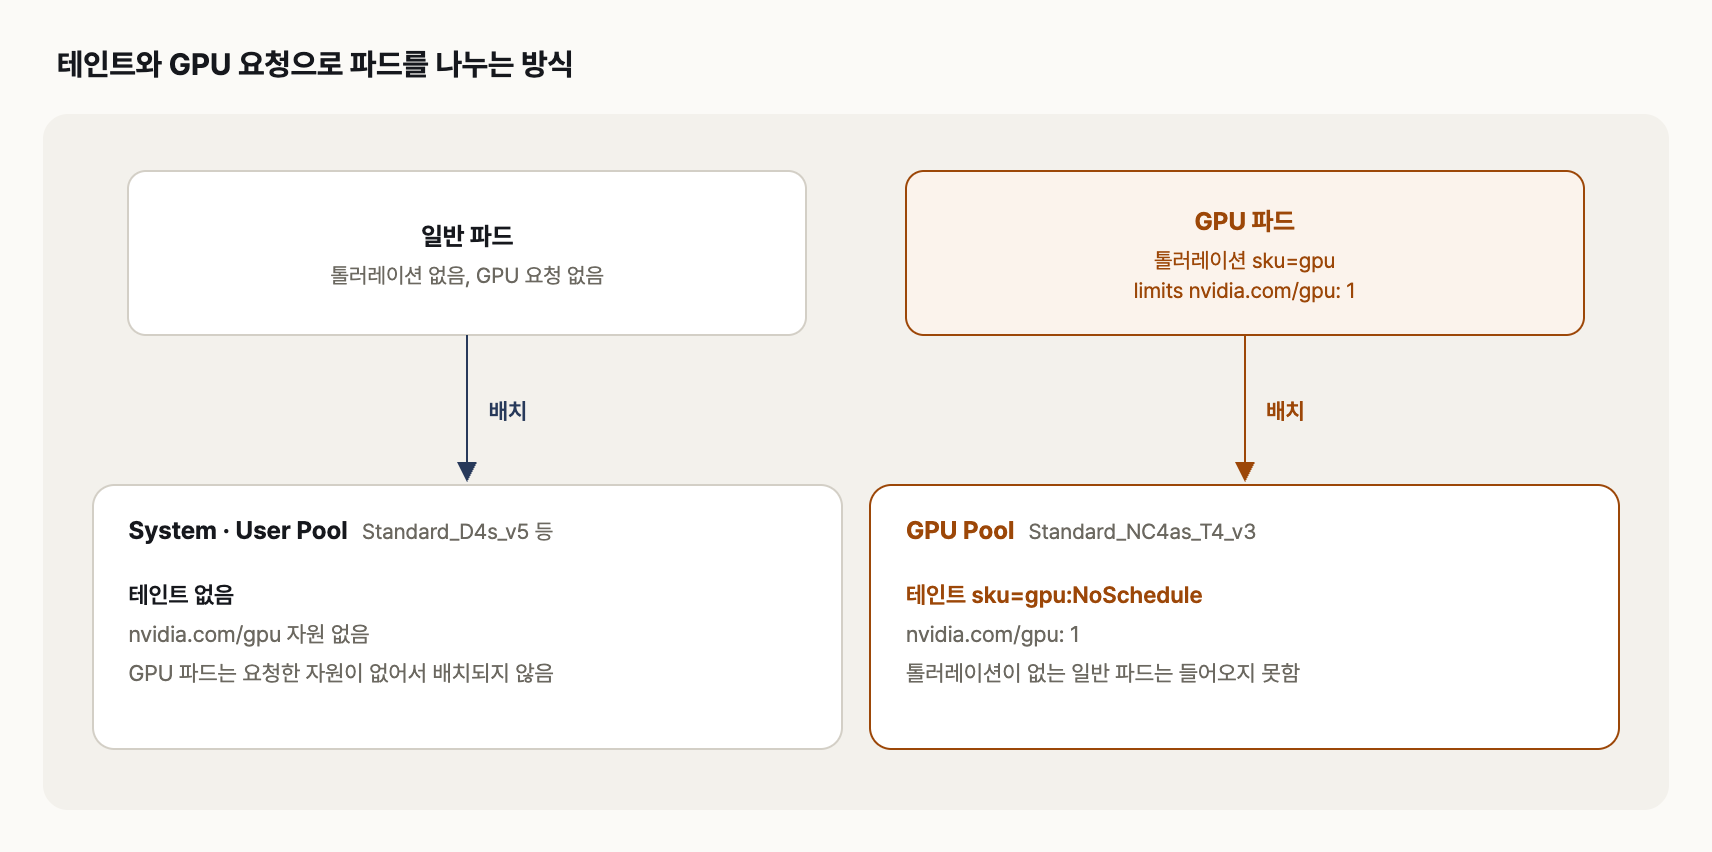
톨러레이션은 GPU 노드에 들어갈 수 있게 허용할 뿐이고, GPU 요청이 파드를 GPU 노드로 보냅니다
둘의 역할은 다릅니다. 톨러레이션은 테인트가 걸린 노드에 들어가는 것을 허용할 뿐 그 노드로 보내지는 않습니다. 파드를 GPU 노드로 보내는 것은 nvidia.com/gpu 요청입니다. 이 자원은 GPU 노드에만 있기 때문입니다. 반대로 톨러레이션만 있고 GPU 요청이 없는 파드는 일반 노드에 배치될 수도 있고, GPU 노드에 배치되더라도 GPU를 자원으로 할당받지 못합니다. 아래 예시는 nodeSelector로 GPU 노드풀을 한 번 더 지정했습니다.
apiVersion: v1
kind: Pod
metadata:
  name: gpu-test
spec:
  restartPolicy: Never
  nodeSelector:
    agentpool: gpunp
  tolerations:
  - key: "sku"
    operator: "Equal"
    value: "gpu"
    effect: "NoSchedule"
  containers:
  - name: gpu-test
    image: mcr.microsoft.com/azuredocs/samples-tf-mnist-demo:gpu
    command: ["nvidia-smi"]
    resources:
      limits:
        nvidia.com/gpu: 1
GPU 매니페스트는 자원 이름과 들여쓰기가 길어서 오타가 나기 쉽습니다. 그래서 저는 배포 전에 kubeconform으로 스키마를 검사합니다. 위 파드와 디바이스 플러그인, 그리고 resources를 resource로 잘못 적은 파드를 함께 검사했습니다.
./kubeconform -strict -summary \
  -schema-location 'schemas/{{.ResourceKind}}{{.KindSuffix}}.json' \
  nvidia-device-plugin-ds.yaml gpu-test.yaml gpu-test-bad.yaml | fold -s -w 86
gpu-test-bad.yaml - Pod gpu-test-bad is invalid: problem validating schema. Check
JSON formatting: jsonschema validation failed with
'file:///srv/aks-gpu/schemas/pod-v1.json#' - at '/spec/containers/0': additional
properties 'resource' not allowed
Summary: 3 resources found in 3 files - Valid: 2, Invalid: 1, Errors: 0, Skipped: 0
-strict 옵션을 주면 스키마에 없는 필드를 오류로 잡습니다. 클러스터에 접속하지 않고도 이런 실수를 배포 전에 잡을 수 있어서, 저는 GPU 매니페스트를 CI 단계에서 이렇게 검사합니다.
6. GPU를 나눠 쓰는 MIG
MIG(Multi-Instance GPU)는 GPU 한 장을 연산 유닛과 메모리가 분리된 최대 7개 인스턴스로 나누는 기능입니다. AKS에서는 A100, H100, H200 계열 VM 크기에서 지원합니다. 작은 모델 여러 개를 격리해서 돌릴 때 GPU 한 장을 통째로 주는 것보다 효율이 좋습니다.
| MIG 프로필 | Standard_ND96asr_v4 기준 |
| MIG1g | 1g.5gb 인스턴스 7개 |
| MIG2g | 2g.10gb 인스턴스 3개 |
| MIG3g | 3g.20gb 인스턴스 2개 |
| MIG4g | 4g.20gb 인스턴스 1개 |
| MIG7g | 7g.40gb 인스턴스 1개 |
프로필은 --gpu-instance-profile로 노드풀을 만들 때 지정하고 나중에 바꿀 수 없습니다. 파드에 보이는 방식은 MIG 전략으로 정합니다. Single은 모든 인스턴스를 nvidia.com/gpu로 똑같이 보여 주고, Mixed는 nvidia.com/mig-1g.10gb처럼 프로필별 자원 이름으로 보여 줍니다. 저는 한 노드풀에 한 가지 프로필만 쓴다면 기존 매니페스트를 그대로 쓸 수 있는 Single을 고릅니다.
7. 운영 전에 확인할 것
| 항목 | 확인하는 이유 |
| 지역과 할당량 | GPU VM은 지역별 제공 여부가 다르고 구독의 VM 패밀리별 vCPU 할당량이 부족하면 노드가 만들어지지 않음 |
| CUDA 호환 | 컨테이너 이미지의 CUDA 버전이 노드 드라이버보다 높으면 드라이버 버전 부족 오류가 남 |
| 노드 수 0 | 사용자 노드풀은 min-count 0이 가능하지만 첫 파드는 노드가 뜰 때까지 대기함 |
| OS 이미지 | Flatcar와 Azure Linux OS Guard는 NVIDIA GPU를 지원하지 않음 |
| 메트릭 | 관리형이 아니면 DCGM Exporter를 직접 배포해야 GPU 사용률을 볼 수 있음 |
8. 정리
- 파드가 GPU를 쓰려면 드라이버와 디바이스 플러그인이 모두 있어야 하고, 파드는 nvidia.com/gpu를 요청합니다.
- 기본값은 드라이버만 설치하는 방식이라 디바이스 플러그인을 직접 배포해야 합니다.
- 관리형 GPU 노드풀은 설치 부담을 줄이지만 미리 보기이고, 직접 만든 노드풀에서는 오토스케일러를 쓸 수 없습니다.
- GPU 노드에는 테인트를 걸고, GPU 파드에는 톨러레이션과 GPU 요청을 함께 넣습니다.
- VM 크기, 테인트, 설치 방식, MIG 설정은 만들 때 정해지므로 노드풀을 만들기 전에 설계를 끝냅니다.
참고
'Cloud > Azure' 카테고리의 다른 글
| [Azure] Entra ID, RBAC, Managed Identity 정리 (0) | 2026.09.27 |
|---|---|
| [Azure] Azure Backup과 Site Recovery 정리 (0) | 2026.09.26 |
| [Azure] Azure Storage 중복성 비교 (0) | 2026.09.26 |
| [Azure] Azure Storage 종류 정리 (0) | 2026.09.26 |
| [Azure] Private Link Service 정리 (0) | 2026.09.25 |
