LLM 추론에 필요한 GPU 메모리는 모델 가중치, KV 캐시, 계산 중에 잠깐 쓰는 공간으로 나뉩니다. 가중치는 모델을 올리는 순간 크기가 정해지지만, KV 캐시는 요청에 들어 있는 토큰 수에 비례해서 요청이 길어지고 동시 요청이 많아질수록 계속 커집니다. 그래서 GPU를 고를 때는 모델이 들어가는지만 보지 말고, 가중치를 올리고 남은 메모리에 토큰을 몇 개나 저장할 수 있는지까지 계산해야 합니다.
1. 추론 메모리의 구성
GPU 개념 정리 글에서는 70B 모델의 가중치 메모리만 계산하고, 실제로는 KV 캐시와 실행 공간이 더 필요하다고 적었습니다. 이번 글에서는 그 나머지를 계산해서, GPU 한 장에 어떤 모델을 몇 개의 요청과 함께 올릴 수 있는지 어림하는 방법을 정리합니다.
| 구성 | 크기를 정하는 값과 특징 |
| 모델 가중치 | 파라미터 수와 정밀도, 모델을 올리면 크기가 고정됨 |
| KV 캐시 | 토큰 수, 레이어 수, KV 헤드 수, 정밀도, 요청 길이와 동시 요청 수에 비례해 늘어남 |
| 실행 공간 | 계산 중간값(활성값), CUDA 그래프 등, 서빙 프레임워크가 시작할 때 측정해 확보함 |
예시 모델은 설정값이 공개된 Llama 3.1 8B와 70B를 사용했습니다. 숫자는 두 모델의 config.json 값으로 직접 계산했고, KV 캐시 크기는 PyTorch로 실제 캐시를 만들어 크기를 확인했습니다. 계산을 단순하게 하려고 크기는 GB(10억 바이트)로 통일했습니다. vLLM 로그는 GiB 단위로 표시하므로 같은 값이 약 7% 작게 보입니다.
2. 가중치 메모리
가중치 메모리는 파라미터 수에 파라미터 하나의 바이트를 곱해서 구합니다. 파라미터 수는 모델 이름의 8B, 70B로 어림할 수도 있지만, 저는 설정값으로 정확한 수를 셉니다. 이름의 숫자는 반올림한 값이라 큰 모델일수록 수 GB씩 차이가 나기 때문입니다.
먼저 두 모델의 config.json에서 메모리 계산에 필요한 값만 옮겼습니다.
# Llama 3.1 config.json에서 메모리 계산에 필요한 값만 옮김
LLAMA31_8B = dict(hidden_size=4096, intermediate_size=14336, num_hidden_layers=32,
                  num_attention_heads=32, num_key_value_heads=8, head_dim=128,
                  vocab_size=128256, tie_word_embeddings=False)
LLAMA31_70B = dict(hidden_size=8192, intermediate_size=28672, num_hidden_layers=80,
                   num_attention_heads=64, num_key_value_heads=8, head_dim=128,
                   vocab_size=128256, tie_word_embeddings=False)
transformers로 모델을 meta 장치에 만들면 실제 메모리를 잡지 않고 모양만 생성하므로, 70B 모델도 GPU 없는 환경에서 파라미터 수를 셀 수 있습니다.
import torch
from transformers import LlamaConfig, LlamaForCausalLM
from configs import LLAMA31_8B, LLAMA31_70B

for name, cfg in [("Llama 3.1 8B", LLAMA31_8B), ("Llama 3.1 70B", LLAMA31_70B)]:
    with torch.device("meta"):          # 실제 메모리를 잡지 않고 모양만 생성
        model = LlamaForCausalLM(LlamaConfig(**cfg))
    n = sum(p.numel() for p in model.parameters())
    print(f"{name:14s} params={n:,}  "
          f"BF16={n*2/1e9:6.1f} GB  FP8={n*1/1e9:6.1f} GB  INT4={n*0.5/1e9:6.1f} GB")
python3 count_params.pyLlama 3.1 8B params=8,030,261,248 BF16= 16.1 GB FP8= 8.0 GB INT4= 4.0 GB
Llama 3.1 70B params=70,553,706,496 BF16= 141.1 GB FP8= 70.6 GB INT4= 35.3 GB
70B 모델은 BF16으로 141GB라서 80GB GPU 두 장에 올리면 가중치만으로 대부분이 찹니다. INT4는 계산상 35GB이지만 실제 양자화 모델은 방식에 따라 스케일 값 등을 함께 저장하고 일부 층을 16비트로 남기기도 해서 이보다 조금 큽니다. 저는 양자화 모델을 쓸 때 계산값 대신 내려받은 파일의 실제 크기를 기준으로 잡습니다.
3. KV 캐시
KV 캐시가 필요한 이유
LLM은 답을 토큰 하나씩 만들고, 새 토큰을 만들 때마다 앞에 있는 모든 토큰의 Key와 Value 값을 참고합니다. 이 값을 매번 다시 계산하지 않도록 저장해 두는 공간이 KV 캐시입니다. 입력을 한 번에 처리하는 단계와 토큰을 하나씩 만드는 단계는 LLM 토큰과 컨텍스트 윈도우 개념 정리에서 다루었습니다.
KV 캐시는 토큰마다 레이어마다 쌓입니다. 그래서 요청에 들어 있는 입력과 출력 토큰이 많을수록, 동시에 처리하는 요청이 많을수록 커집니다. 가중치와 달리 운영 중에 크기가 변한다는 점이 인프라 관점에서 가장 중요합니다.
토큰 하나의 크기
토큰 하나의 KV 캐시 크기는 K와 V 두 개, 레이어 수, KV 헤드 수, 헤드 하나의 차원(head_dim), 값 하나의 바이트를 곱해서 구합니다.
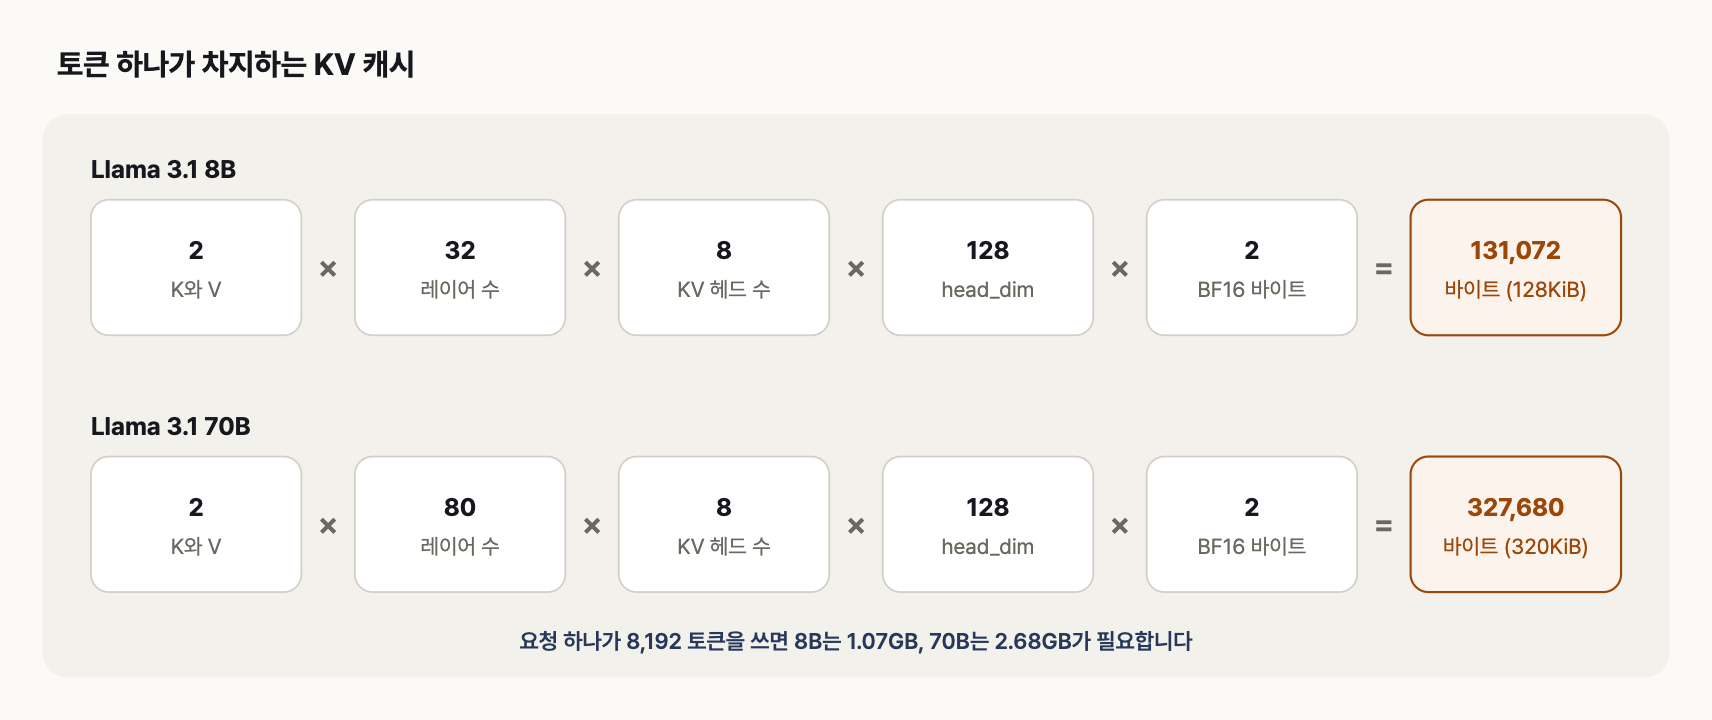
두 모델 모두 KV 헤드가 8개이고, 레이어 수 차이만큼 70B의 토큰당 KV 캐시가 커집니다
여기서 헤드 수는 어텐션 헤드 수가 아니라 KV 헤드 수를 씁니다. Llama 3.1 8B는 어텐션 헤드가 32개이지만 KV 헤드는 8개라서, 헤드 4개가 KV 한 벌을 함께 씁니다. 이런 방식을 GQA(Grouped-Query Attention)라고 하고, KV 캐시가 헤드마다 KV를 둘 때의 4분의 1로 줄어듭니다. 그래서 저는 모델을 비교할 때 파라미터 수와 함께 config.json의 num_key_value_heads를 꼭 확인합니다.
실제 캐시로 확인
공식이 맞는지 PyTorch로 실제 KV 캐시를 만들어 확인했습니다. 8B 모델 전체는 CPU 메모리에 올리기 부담스러워서, KV 캐시 모양을 정하는 레이어 수, KV 헤드 수, head_dim만 8B와 같게 두고 나머지 크기를 줄인 모델을 썼습니다. 가중치는 무작위라서 답은 의미가 없지만, 캐시의 모양과 크기는 실제 8B와 같습니다.
import torch
from transformers import LlamaConfig, LlamaForCausalLM
from configs import LLAMA31_8B

# KV 캐시 모양을 결정하는 값(레이어, KV 헤드, head_dim)만 8B와 같게 두고
# 나머지는 줄여서 CPU 메모리에 올릴 수 있게 만든 모델 (가중치는 무작위)
cfg = dict(LLAMA31_8B, hidden_size=512, intermediate_size=1024, vocab_size=1000)
model = LlamaForCausalLM(LlamaConfig(**cfg)).to(torch.bfloat16).eval()

for n_tokens in (1000, 4000):
    ids = torch.randint(0, 1000, (1, n_tokens))
    with torch.no_grad():
        out = model(ids, use_cache=True)
    cache = out.past_key_values
    total = sum(l.keys.numel() * l.keys.element_size() +
                l.values.numel() * l.values.element_size() for l in cache.layers)
    k = cache.layers[0].keys
    print(f"tokens={n_tokens} layers={len(cache.layers)} key={tuple(k.shape)} "
          f"total={total:,} per_token={total // n_tokens:,}")

L, H, D = cfg["num_hidden_layers"], cfg["num_key_value_heads"], cfg["head_dim"]
print(f"formula: 2 x {L} x {H} x {D} x 2 bytes = {2*L*H*D*2:,} bytes per token")
python3 measure_kv.pytokens=1000 layers=32 key=(1, 8, 1000, 128) total=131,072,000 per_token=131,072
tokens=4000 layers=32 key=(1, 8, 4000, 128) total=524,288,000 per_token=131,072
formula: 2 x 32 x 8 x 128 x 2 bytes = 131,072 bytes per token
토큰당 크기가 공식과 같은 131,072바이트로 나왔고, 토큰을 4배로 늘리니 캐시도 정확히 4배가 되었습니다. KV 캐시는 토큰 수에 정비례한다는 뜻입니다.
이 값을 요청 하나에 대입해 보면 크기가 체감됩니다. 8B 모델도 128K 토큰을 꽉 채운 요청 하나는 KV 캐시만 17.2GB로, 가중치 16.1GB보다 큽니다. 컨텍스트 윈도우가 긴 모델을 고를 때 긴 입력을 실제로 받을지부터 정해야 하는 이유입니다.
4. 동시에 처리할 수 있는 요청 수
vLLM 같은 서빙 프레임워크는 GPU 메모리 중 gpu_memory_utilization 비율만큼을 쓰고, 그 안에서 가중치와 실행 공간을 뺀 나머지를 KV 캐시로 미리 잡습니다. vLLM 최근 버전의 기본값은 0.92이고 이전 버전은 0.9였습니다. 실행 공간은 시작할 때 실제로 모델을 한 번 돌려서 측정합니다.
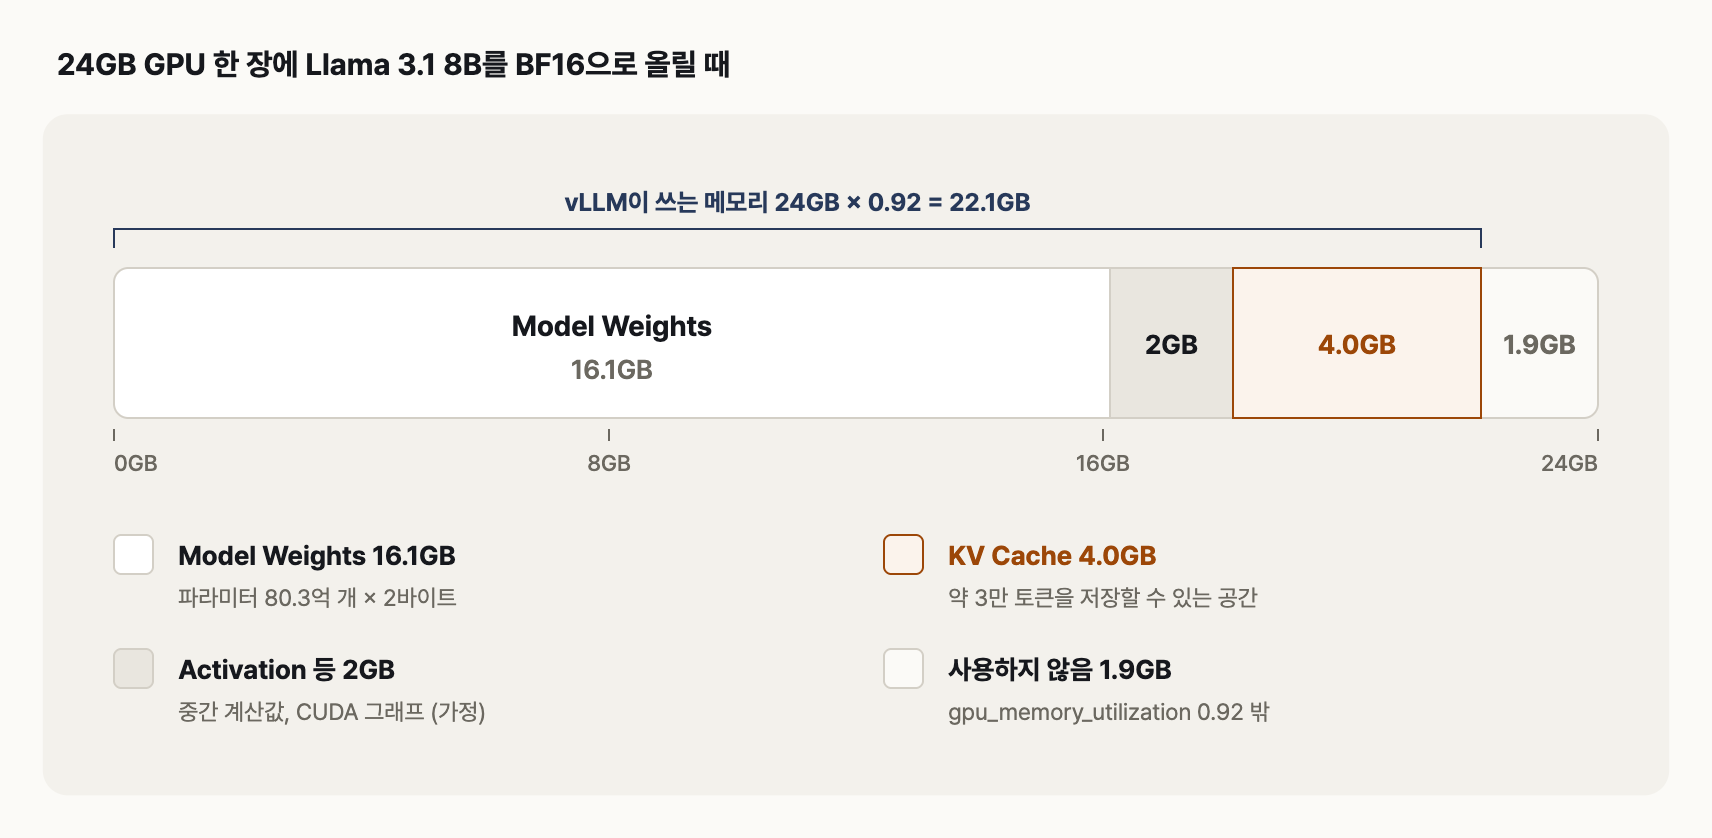
가중치 16.1GB를 올리고 나면 KV 캐시로 쓸 수 있는 공간은 4GB 정도만 남습니다
이 계산을 여러 GPU 구성에 적용하는 스크립트를 만들었습니다. 실행 공간은 GPU 한 장에 2GB로 가정했습니다. 실제 값은 모델과 설정마다 달라서, 운영에서는 vLLM 시작 로그로 확인해야 합니다.
from configs import LLAMA31_8B, LLAMA31_70B

GB = 1e9
BYTES = {"bf16": 2, "fp8": 1, "int4": 0.5}
PARAMS = {"8B": 8_030_261_248, "70B": 70_553_706_496}   # count_params.py 결과
CFG = {"8B": LLAMA31_8B, "70B": LLAMA31_70B}


def kv_bytes_per_token(cfg, kv_dtype="bf16"):
    # K와 V 2개 x 레이어 수 x KV 헤드 수 x head_dim x 값 하나의 바이트
    return (2 * cfg["num_hidden_layers"] * cfg["num_key_value_heads"]
            * cfg["head_dim"] * BYTES[kv_dtype])


def plan(model, w_dtype, gpus, gpu_gb, ctx, kv_dtype="bf16",
         util=0.92, reserve_gb=2.0):
    usable = gpus * gpu_gb * util                  # vLLM이 쓰도록 허용된 메모리
    weights = PARAMS[model] * BYTES[w_dtype] / GB
    reserve = gpus * reserve_gb                    # 활성값, CUDA 그래프 등 (가정)
    kv_gb = usable - weights - reserve
    per_tok = kv_bytes_per_token(CFG[model], kv_dtype)
    tokens = max(kv_gb, 0) * GB / per_tok
    print(f"{model:>3} {w_dtype:4} {gpus}x{gpu_gb:.0f}GB  weights {weights:5.1f}  "
          f"KV {kv_gb:5.1f}  tokens {tokens:>7,.0f}  "
          f"ctx {ctx:>7,}  req {tokens / ctx:4.1f}")


if __name__ == "__main__":
    for m in ("8B", "70B"):
        b = kv_bytes_per_token(CFG[m])
        print(f"{m:>3} KV per token: {b:,.0f} bytes, "
              f"8K ctx {b * 8192 / GB:.2f} GB, 128K ctx {b * 131072 / GB:.1f} GB")
    mha = dict(LLAMA31_8B, num_key_value_heads=32)   # GQA 없이 헤드마다 KV를 둘 때
    print(f" 8B without GQA: {kv_bytes_per_token(mha):,.0f} bytes per token")
    print()
    plan("8B", "bf16", 1, 24, 8192)
    plan("8B", "bf16", 1, 24, 131072)
    plan("8B", "bf16", 1, 80, 131072)
    plan("70B", "bf16", 2, 80, 8192)
    plan("70B", "bf16", 4, 80, 8192)
    plan("70B", "fp8", 2, 80, 8192)
    plan("70B", "fp8", 2, 80, 8192, kv_dtype="fp8")   # KV 캐시도 FP8
    plan("70B", "int4", 1, 80, 8192)
python3 vram_calc.py 8B KV per token: 131,072 bytes, 8K ctx 1.07 GB, 128K ctx 17.2 GB
70B KV per token: 327,680 bytes, 8K ctx 2.68 GB, 128K ctx 42.9 GB
8B without GQA: 524,288 bytes per token
8B bf16 1x24GB weights 16.1 KV 4.0 tokens 30,666 ctx 8,192 req 3.7
8B bf16 1x24GB weights 16.1 KV 4.0 tokens 30,666 ctx 131,072 req 0.2
8B bf16 1x80GB weights 16.1 KV 55.5 tokens 423,733 ctx 131,072 req 3.2
70B bf16 2x80GB weights 141.1 KV 2.1 tokens 6,386 ctx 8,192 req 0.8
70B bf16 4x80GB weights 141.1 KV 145.3 tokens 443,398 ctx 8,192 req 54.1
70B fp8 2x80GB weights 70.6 KV 72.6 tokens 221,699 ctx 8,192 req 27.1
70B fp8 2x80GB weights 70.6 KV 72.6 tokens 443,398 ctx 8,192 req 54.1
70B int4 1x80GB weights 35.3 KV 36.3 tokens 110,849 ctx 8,192 req 13.5
req는 모든 요청이 ctx 길이를 꽉 채운다고 가정했을 때 동시에 처리할 수 있는 요청 수입니다. 결과를 구성별로 정리하면 아래와 같습니다.
| 구성 | 결과와 해석 |
| 8B BF16 24GB 1장 |
약 3만 토큰, 8K 요청 3~4개, 128K 요청은 하나도 담지 못함 |
| 8B BF16 80GB 1장 |
약 42만 토큰, 128K 요청 3개 |
| 70B BF16 80GB 2장 |
약 6천 토큰, 가중치가 거의 다 차지해서 8K 요청 하나도 부족함 |
| 70B BF16 80GB 4장 |
약 44만 토큰, 8K 요청 54개 |
| 70B FP8 80GB 2장 |
약 22만 토큰, KV 캐시도 FP8로 저장하면 44만 토큰 |
| 70B INT4 80GB 1장 |
약 11만 토큰, 8K 요청 13개 |
두 가지를 함께 봐야 합니다. 첫째, 이 요청 수는 최악의 경우입니다. vLLM은 요청이 실제로 쓴 토큰만큼만 KV 캐시 블록을 할당하므로, 평균 요청이 최대 길이보다 짧으면 더 많은 요청을 동시에 처리합니다. 둘째, 담을 수 있는 토큰이 최대 길이 하나보다 적으면 vLLM은 아예 시작하지 않습니다. 소스 코드를 보면 이때 필요한 KV 캐시와 사용 가능한 KV 캐시를 비교한 오류를 내고, 가능한 최대 길이를 추정해서 함께 알려 줍니다.
실제 서버에서는 vLLM 시작 로그의 두 줄로 계산을 확인합니다. "Available KV cache memory"는 KV 캐시로 잡은 메모리이고, "GPU KV cache size"는 저장할 수 있는 토큰 수와 최대 길이 기준 동시 요청 수(Maximum concurrency)입니다. 저는 계산값과 로그 값의 차이가 크면 같은 GPU를 쓰는 다른 프로세스가 있는지부터 봅니다. gpu_memory_utilization은 GPU 전체 메모리 기준 비율이라 다른 프로세스가 메모리를 쓰고 있으면 시작이 실패하기 때문입니다.
5. 메모리가 부족할 때 조정하는 값
계산 결과가 목표 동시 요청 수보다 적으면 아래 값을 조정합니다. vLLM 문서의 Conserving Memory 항목도 이 중 대부분을 안내합니다.
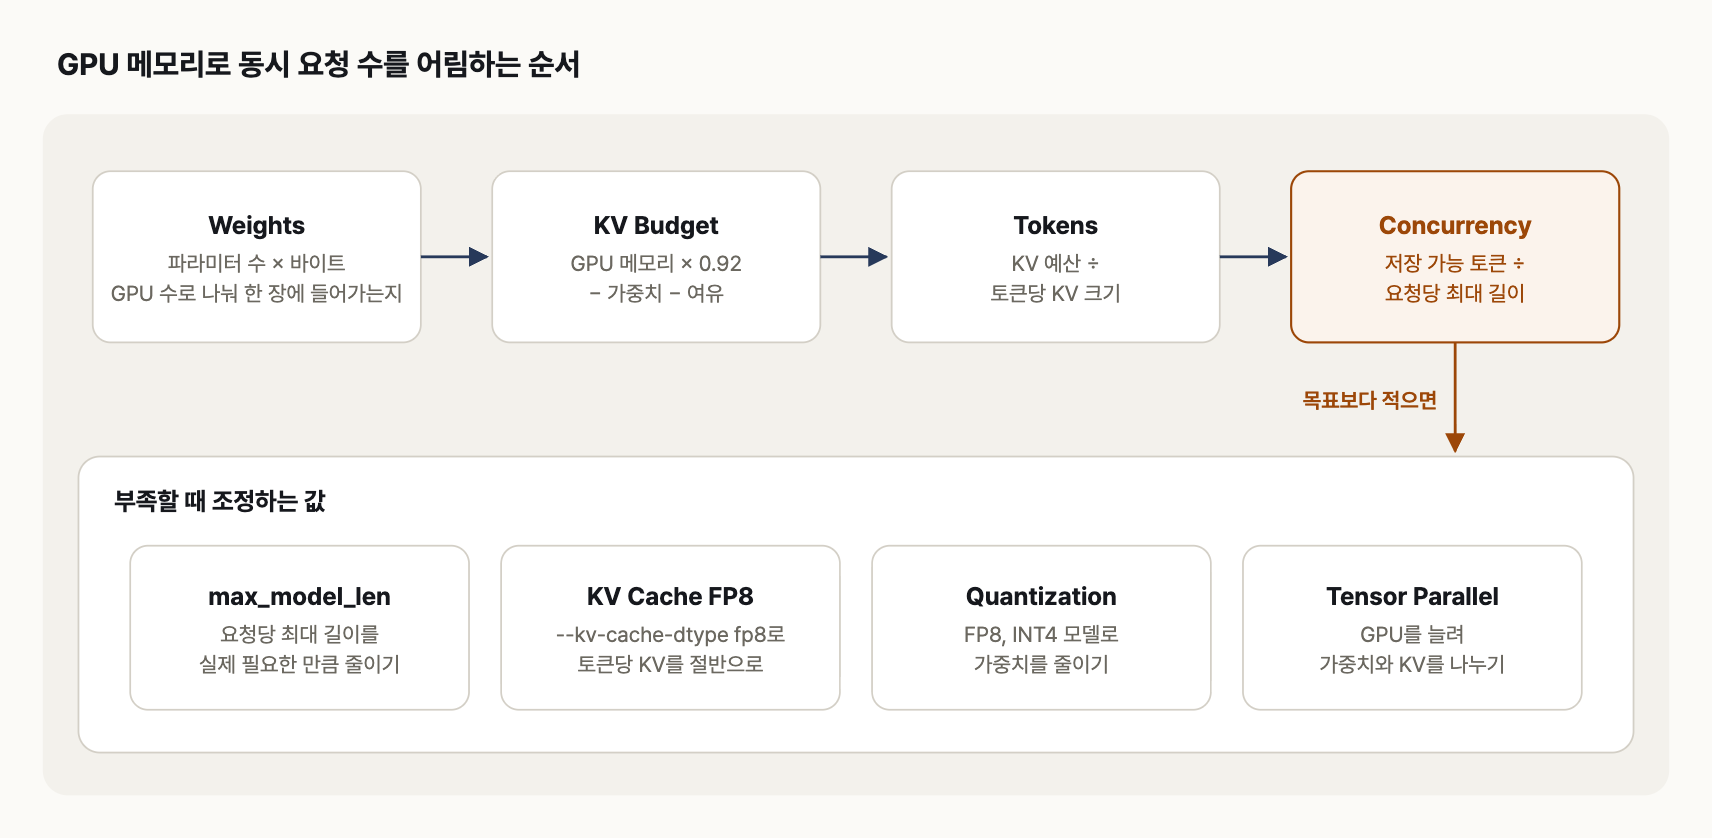
비용이 적게 드는 조정부터 순서대로 검토합니다
| 조정 | 효과와 주의점 |
| 최대 길이 | --max-model-len으로 요청당 최대 토큰을 줄임, 설정보다 긴 요청은 처리하지 못함 |
| KV 정밀도 | --kv-cache-dtype fp8로 토큰당 KV 캐시를 절반으로 줄임, 답 품질을 평가한 뒤 적용 |
| 양자화 모델 | FP8, INT4 모델로 가중치를 절반 이하로 줄임, 품질 저하를 평가 세트로 확인 |
| GPU 추가 | --tensor-parallel-size로 여러 GPU에 나눔, GPU 간 연결 대역폭이 속도에 영향 |
| 동시 요청 제한 | --max-num-seqs로 한 번에 처리하는 요청 수를 제한함, CUDA 그래프 등 실행 공간이 줄어듦 |
저는 최대 길이를 가장 먼저 봅니다. 모델이 128K를 지원해도 실제 서비스 요청은 대부분 그보다 훨씬 짧은 경우가 많아서, 실제 요청 길이 분포에 맞춰 줄이면 비용 없이 동시 요청 수를 늘릴 수 있기 때문입니다. 양자화와 KV 캐시 FP8은 메모리를 크게 줄이지만 답 품질이 달라질 수 있어서 평가 세트로 비교한 뒤 적용합니다.
6. 정리
- 추론 메모리는 가중치, KV 캐시, 실행 공간으로 나뉘고, 운영 중에 커지는 것은 KV 캐시입니다.
- 가중치는 파라미터 수 × 정밀도 바이트로, KV 캐시는 2 × 레이어 × KV 헤드 × head_dim × 바이트 × 토큰 수로 계산합니다.
- KV 헤드 수는 어텐션 헤드 수와 다를 수 있으니 config.json의 num_key_value_heads를 확인합니다.
- 동시 요청 수는 KV 캐시 예산을 요청당 최대 토큰의 KV 크기로 나눠 어림하고, vLLM 시작 로그로 확인합니다.
- 부족하면 최대 길이, KV 캐시 정밀도, 양자화, GPU 추가 순으로 검토합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [NVIDIA] NVLink와 NVSwitch 차이 정리 (0) | 2026.09.26 |
|---|---|
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (1) | 2026.09.26 |
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] GPU 노드에서 랙까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] AI 인프라 전력·냉각·네트워크 정리 (1) | 2026.09.26 |
