Kubernetes는 Pod가 CPU와 메모리를 얼마나 쓸지 알아야 노드에 알맞게 배치하고, 한 Pod가 노드 자원을 다 쓰지 못하게 막을 수 있습니다. 이 글에서는 requests와 limits의 차이, 한도를 넘었을 때의 동작, QoS 클래스를 정리하고, 부하에 따라 Pod 수를 조절하는 HPA를 kind에서 직접 확인합니다.
컨테이너부터 Kubernetes까지 시리즈 11편입니다. 이전 글은 [Kubernetes] Volume, PV, PVC, StorageClass 정리이고, 전체 순서는 시리즈 목차에 있습니다.
1. requests와 limits
컨테이너마다 resources.requests와 resources.limits를 정할 수 있습니다. requests는 "최소 이만큼은 필요하다"는 예약이고, scheduler는 노드의 남은 예약 가능량과 requests를 비교해 Pod를 배치합니다. limits는 "이 이상은 쓰지 못한다"는 상한이고, 1편에서 본 cgroup으로 노드에서 강제됩니다. 식당 예약에 비유하면 requests는 예약한 좌석 수, limits는 가게가 허용하는 최대 인원입니다.
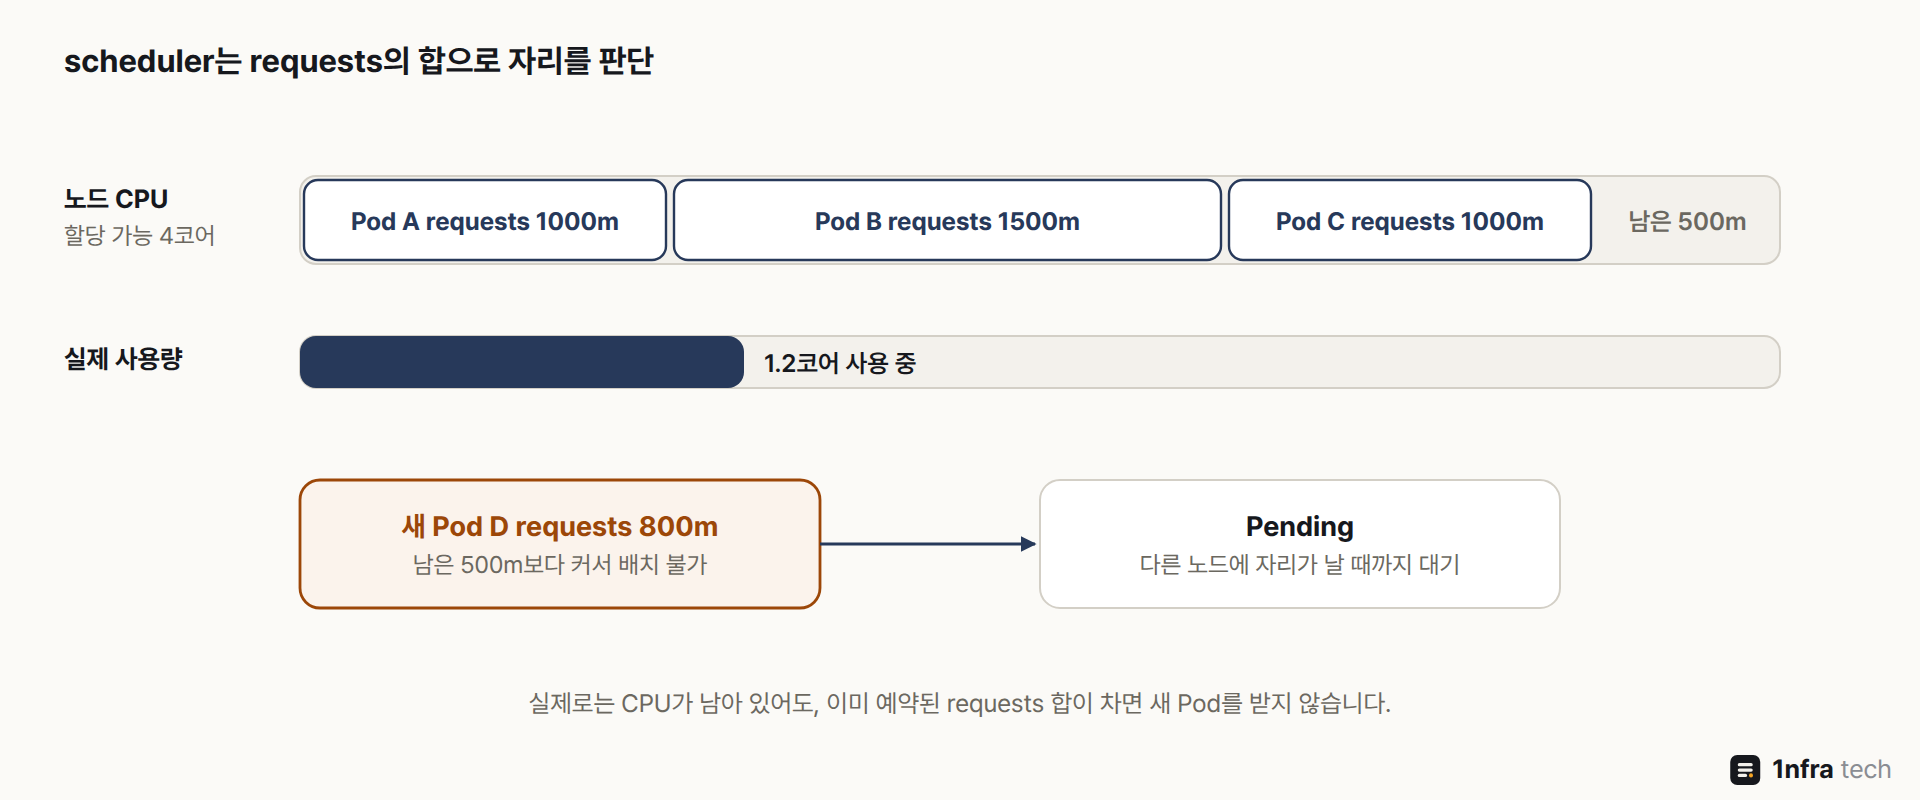
scheduler는 실제 사용량이 아니라 requests의 합으로 노드에 자리가 있는지 판단합니다
| 자원 | 단위 | limits를 넘으면 |
| CPU | 1 = 코어 1개 100m = 0.1코어 |
더 쓰지 못하게 속도를 늦춤(throttling) 컨테이너는 계속 실행 |
| 메모리 | Mi, Gi(1Mi = 1024×1024바이트) | 커널이 컨테이너 프로세스를 강제 종료(OOMKilled, 종료 코드 137) restartPolicy에 따라 재시작 |
CPU는 나눠 쓸 수 있는 자원이라 한도를 넘으면 느려지기만 하지만, 메모리는 돌려받을 수 없어서 한도를 넘으면 프로세스가 종료됩니다. 그래서 메모리 limits는 앱이 실제로 쓰는 최대치보다 여유 있게 잡아야 합니다. requests와 limits는 v1.35부터 GA가 된 in-place resize로 Pod를 다시 만들지 않고 바꿀 수도 있습니다.
2. QoS 클래스
노드의 메모리가 부족해지면 kubelet은 Pod를 골라 내보냅니다(eviction). 이때 순서를 정하는 기준이 requests와 limits 설정으로 정해지는 QoS 클래스입니다.
| 클래스 | 조건 | 메모리 부족 시 |
| Guaranteed | 모든 컨테이너가 CPU와 메모리의 requests와 limits를 같은 값으로 설정 | 가장 마지막에 내보냄 |
| Burstable | requests나 limits가 일부만 있거나 두 값이 다름 | 중간 |
| BestEffort | requests와 limits가 모두 없음 | 가장 먼저 내보냄 |
3. HPA
HorizontalPodAutoscaler(HPA)는 Pod들의 평균 사용량을 보고 Deployment의 replicas를 바꿉니다. 사용량은 metrics-server가 각 노드의 kubelet에서 모아 Metrics API로 제공하고, HPA 컨트롤러가 기본 15초마다 이 값을 읽어 필요한 Pod 수를 계산합니다.
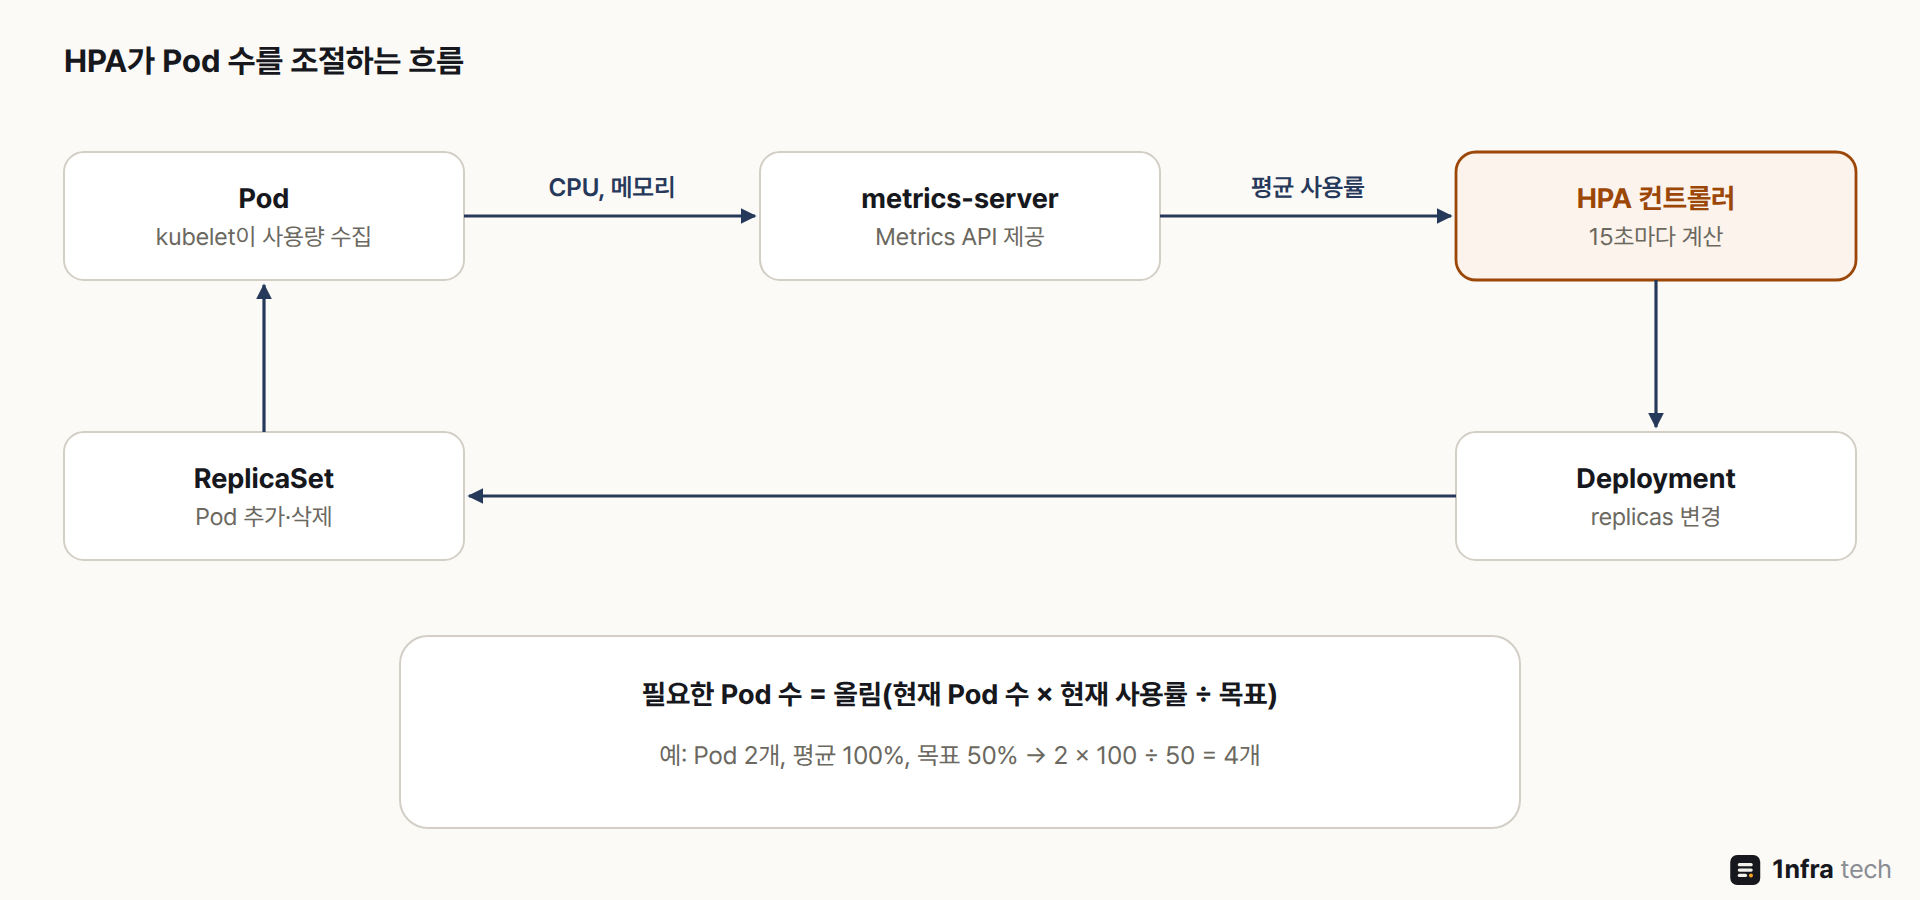
목표가 50%인데 평균이 100%면 Pod 수를 2배로, 25%면 절반으로 맞춥니다
CPU 목표를 50%로 정하면 이 50%는 노드 CPU가 아니라 requests 대비 비율입니다. 그래서 requests가 없는 Pod는 CPU 기준 HPA를 쓸 수 없습니다. 계산 결과가 현재와 10% 이내로 차이 나면 조정하지 않고, 줄일 때는 기본 5분 동안의 계산값 중 가장 큰 값을 따라서 부하가 잠깐 줄었다고 바로 Pod를 줄이지 않습니다.
4. 직접 해 보기
kind에는 metrics-server가 없어서 먼저 설치합니다. kind의 kubelet은 자체 서명 인증서를 쓰므로, 인증서 검증을 건너뛰는 --kubelet-insecure-tls 옵션을 추가합니다. 이 옵션은 테스트용입니다.
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml
kubectl patch deployment metrics-server -n kube-system --type=json \
  -p '[{"op":"add","path":"/spec/template/spec/containers/0/args/-","value":"--kubelet-insecure-tls"}]'
kubectl top nodes
1분 정도 지나면 top 명령이 노드별 CPU와 메모리 사용량을 보여 줍니다. 이제 Kubernetes 공식 문서의 HPA 예제를 씁니다. 요청을 받을 때마다 CPU를 쓰는 php-apache 앱으로, 컨테이너마다 requests cpu 200m, limits cpu 500m이 설정된 Deployment와 Service가 함께 만들어집니다.
kubectl apply -f https://k8s.io/examples/application/php-apache.yaml
kubectl autoscale deployment php-apache --cpu=50% --min=1 --max=5
목표 50%는 requests 200m의 절반인 100m입니다. kubectl get hpa를 실행하면 처음 1분쯤은 TARGETS가 cpu: <unknown>/50%로 나오다가, metrics-server가 값을 모으면 cpu: 0%/50%로 바뀝니다. 다른 터미널에서 부하를 줍니다.
kubectl run load --rm -it --restart=Never --image=busybox:1.38 -- \
  sh -c 'while sleep 0.01; do wget -q -O- http://php-apache; done'
kubectl get hpa php-apache --watchCPU 사용률이 50%를 넘으면 REPLICAS가 늘어나고, Pod가 늘어날수록 한 Pod의 사용률이 내려가 목표 근처에서 멈춥니다. 부하를 멈추면(Ctrl+C) 약 5분 뒤에 1개로 돌아옵니다. kubectl describe hpa php-apache의 Events에서 몇 개로 바꿨고 이유가 무엇인지 볼 수 있습니다.
5. 운영 시 주의점
| 항목 | 조치 |
| requests 누락 | scheduler가 사용량을 모른 채 배치해 노드가 과밀해지고, BestEffort라 가장 먼저 내보내짐 모든 컨테이너에 requests 설정 |
| 메모리 limits | 너무 낮으면 OOMKilled가 반복됨 kubectl top으로 실제 사용량을 보고 여유 있게 설정 |
| CPU limits | 낮게 잡으면 노드가 한가해도 throttling으로 응답이 느려짐 응답 시간이 중요하면 limits를 넉넉히 두거나 requests 위주로 관리 |
| 네임스페이스 기본값 | LimitRange로 기본 requests와 limits를, ResourceQuota로 네임스페이스 전체 총량을 제한 |
| HPA와 replicas | YAML의 replicas가 apply할 때마다 HPA가 정한 값을 덮어씀 HPA를 쓰는 Deployment는 YAML에서 replicas를 빼고 관리 |
| HPA 최소값 | min 1이면 그 Pod가 재시작되는 동안 서비스가 끊김 운영 서비스는 min 2 이상 |
6. 정리
- requests는 scheduler가 배치할 때 쓰는 예약량이고, limits는 cgroup으로 강제되는 상한입니다.
- CPU는 한도를 넘으면 느려지고 메모리는 한도를 넘으면 OOMKilled로 종료되며, 설정에 따라 QoS 클래스와 eviction 순서가 정해집니다.
- HPA는 metrics-server의 값을 requests 대비 비율로 계산해 replicas를 조절하므로, requests 설정이 HPA의 전제 조건입니다.
6편부터 이어 온 kind 클러스터는 실습이 끝나면 kind delete cluster로 지웁니다.
참고
'DevOps > Kubernetes' 카테고리의 다른 글
| [Kubernetes] Volume, PV, PVC, StorageClass 정리 (0) | 2026.09.28 |
|---|---|
| [Kubernetes] ConfigMap과 Secret 정리 (0) | 2026.09.28 |
| [Kubernetes] Service와 Ingress, Gateway API 정리 (0) | 2026.09.28 |
| [Kubernetes] Pod, ReplicaSet, Deployment 정리 (0) | 2026.09.28 |
| [Kubernetes] 클러스터 구조 정리 (0) | 2026.09.28 |
