제 홈랩의 VM은 ESXi 호스트 2대에서 한때 약 68대까지 늘었고, 정리를 거쳐 지금은 24대입니다. 하이퍼바이저는 지원이 끝났고, 서비스 VM의 절반 이상이 지원이 종료된 OS를 썼으며, 실제로 쓰는 자원은 할당량의 4분의 1에도 못 미쳤습니다. 그래서 서비스 VM을 컨테이너로 바꿔 Kubernetes 클러스터로 옮기기로 했습니다. 이 글에서는 현재 인프라 상태와 문제점, Kubernetes를 고른 이유, 옮기기 전에 정리한 것과 이전 계획을 다룹니다. 홈랩 재구성 시리즈의 1편입니다.
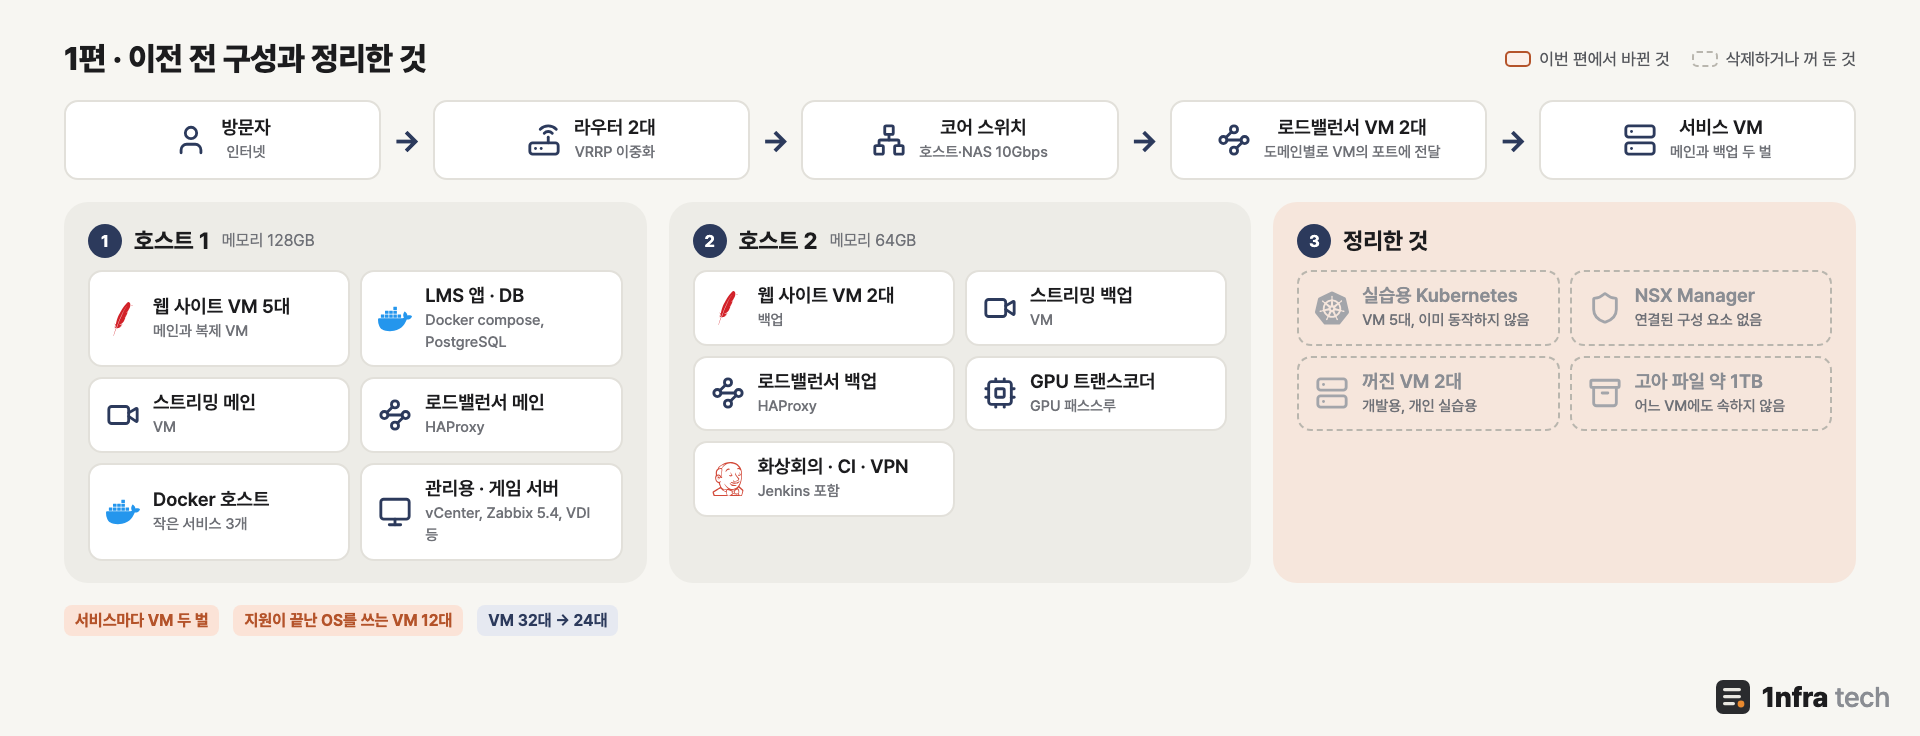
1편을 마친 시점의 구성입니다. 요청은 로드밸런서 VM을 거쳐 서비스마다 따로 있는 VM으로 갔고, 쓰지 않는 VM과 파일부터 정리했습니다
1. 현재 홈랩 구성
물리 서버는 ESXi 호스트 2대이고 vCenter 1대로 관리합니다. 두 호스트는 클러스터(DRS, HA)로 묶지 않고 따로 운영합니다.
| 구분 | 구성 |
| 호스트 | 2소켓 서버 2대, 메모리 128GB와 64GB |
| 네트워크 | 서비스망과 관리망 분리, 호스트 사이 10Gbps |
| 스토리지 | 호스트별 로컬 SSD와 HDD, NAS의 NFS 볼륨 |
| 관리용 VM (7대) | vCenter, 모니터링 2대, 네트워크 장비 관리, VDI, VPN, CI 서버 |
| 서비스용 VM (17대) | 웹 사이트 7대, LMS 앱과 DB 2대, 스트리밍과 인코딩 3대, 화상회의, 게임 서버, 로드밸런서 2대, Docker 호스트 |
웹 사이트와 스트리밍, 로드밸런서는 대부분 메인 VM과 백업 VM으로 구성되어 있습니다. 서비스 하나를 이중화하려면 VM을 하나 더 만들고 설정을 똑같이 맞춰야 합니다.
2. 지금 구성의 문제
| 문제 | 내용 |
| 하이퍼바이저 | vSphere 7 일반 지원 종료(2025년 10월 2일) |
| OS | 리눅스 VM 12대와 Windows 10 1대가 지원 종료(EOS) |
| 자원 | DB를 뺀 서비스 VM 16대에 vCPU 31개, 메모리 52GB 할당, 실제 사용은 CPU 약 1.8GHz, 메모리 약 12GB |
| 트래픽 | 웹 VM 한 대에서 14일간 쌓인 로그 512만 줄이 모두 상태 확인 요청 |
| 쌓인 것 | 쓰지 않는 VM, 어느 VM에도 속하지 않은 파일 약 1TB |
가장 큰 문제는 자원 낭비입니다. 작은 웹 서비스마다 VM을 하나씩 주다 보니, 자원 대부분을 서비스가 아니라 VM마다 실행되는 OS가 썼습니다. 이 구조에서는 지원이 끝난 OS를 계속 쓰게 됩니다. VM이 많으면 업그레이드가 밀리고, 밀린 VM은 한꺼번에 지원이 끝납니다.
3. 왜 Kubernetes로 옮기나
| 방법 | 장점과 한계 |
| VM마다 OS 업그레이드 | 구성 변화가 적음 / 12대의 앱 호환성을 하나씩 확인해야 하고, 몇 년 뒤 반복됨 |
| 하이퍼바이저만 교체 | 지원 종료는 해결 / VM 수, 오래된 OS, 남는 자원은 그대로 |
| 서비스를 컨테이너로 | 관리할 OS가 노드 몇 대로 줄고 배포 상태가 Git에 남음 / 구축하고 익히는 데 시간이 듦 |
세 번째를 골랐습니다. OS 관리 대상이 노드 몇 대로 줄고, VM 두 벌로 하던 이중화를 Pod 복제 수로 대신할 수 있습니다. 하이퍼바이저를 나중에 바꾸더라도 노드 VM 몇 대만 옮기면 됩니다. Proxmox로 옮길 때 확인할 사항은 따로 쓴 글(VMware ESXi와 Proxmox VE 비교, 이전 전 확인할 것)에 정리했습니다.
4. 옮기기 전에 정리한 것
이전 규모를 줄이고 새 노드 자리를 만들기 위해, 쓰지 않는 것부터 지웠습니다. 어느 VM에도 속하지 않은 파일은 데이터스토어 전체 파일 목록에서 각 VM 설정에 적힌 파일을 빼서 찾았습니다.
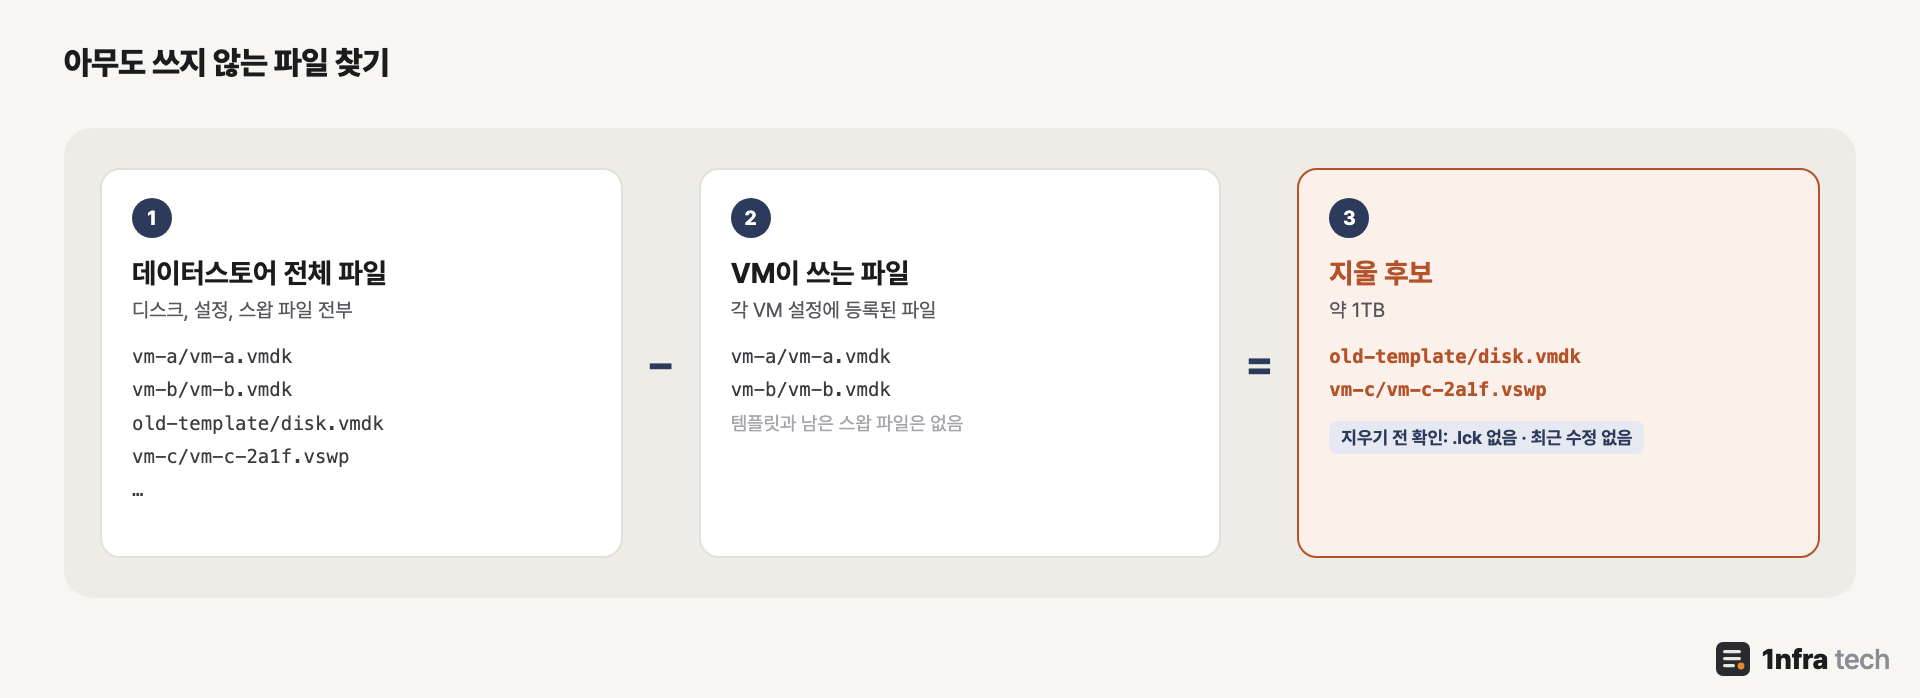
데이터스토어 전체 파일에서 VM이 쓰는 파일을 빼면 아무도 쓰지 않는 파일이 남습니다
지우기 전에는 잠금 파일(.lck)과 최근 수정 기록이 모두 없는지 확인합니다. vCenter에 없는 디스크라도 최근에 수정되었다면 다른 곳에서 쓰는 중일 수 있습니다.
| 대상 | 정리한 것 |
| 로컬 SSD | 쓰지 않는 템플릿과 VM 폴더, 약 280GB |
| NAS | 쓰지 않는 VM 폴더와 스왑 파일, 약 315GB |
| 콘텐츠 라이브러리 | 연결이 끊긴 라이브러리, 11.8GB |
| VM | 개발·실습용 VM, 실습용 Kubernetes VM 5대, 쓰지 않는 네트워크 가상화 관리 VM |
NAS에 스냅샷을 설정해 두었다면 NFS 볼륨에서 지운 데이터가 스냅샷에 남아 있으므로, 여유 공간은 보관 기간이 지난 뒤에 확인합니다.
| 항목 | 정리 전 → 정리 후 |
| VM 수 | 32대 → 24대 |
| 호스트 1 메모리 사용률 | 83% → 61% |
| 호스트 1 로컬 SSD 여유 | 138GB → 315GB |
호스트 1의 비어 있던 로컬 SSD 하나는 새 클러스터 노드의 디스크로 씁니다.
5. 이전 계획
옮기기 쉬운 서비스부터 옮기고, 위험이 큰 것은 VM으로 남깁니다.
| 구분 | 대상 |
| 옮김 | 웹 사이트, LMS 앱, 인코딩 서버, Docker 호스트의 컨테이너 |
| 나중에 | 게임 서버, 스트리밍, 화상회의 (UDP 미디어 포트와 공인 IP 처리가 까다로움) |
| VM 유지 | 관리용 VM, LMS DB (NAS 스토리지에 둔 DB는 위험하다고 판단) |
| 대체 | 로드밸런서 VM 2대는 Gateway API와 MetalLB로 대체 |
다음 글에서는 클러스터 설계와 노드 배치, 구성 요소를 고른 기준을 정리하겠습니다.
6. 정리
- ESXi 호스트 2대와 VM 24대로, 대부분의 웹 사이트와 스트리밍, 로드밸런서를 메인 VM과 백업 VM으로 운영하는 구조였습니다.
- vSphere 7 지원 종료, EOS OS를 쓰는 VM, 할당량의 4분의 1에 못 미치는 실제 사용량이 문제였습니다.
- 서비스를 컨테이너로 옮겨 OS 관리 대상을 노드 몇 대로 줄이기로 했습니다.
- 쓰지 않는 VM과 파일을 지워 VM을 32대에서 24대로 줄이고 새 노드 자리를 마련했습니다.
참고
'Project > 홈랩' 카테고리의 다른 글
| [홈랩] 웹 서비스 VM을 Kubernetes로 옮기고 검증하기 (3편) (0) | 2026.10.28 |
|---|---|
| [홈랩] 홈랩 Kubernetes 클러스터 설계와 노드 배치 (2편) (0) | 2026.10.28 |
| [홈랩] 홈 네트워크 구축 V2 (0) | 2020.11.04 |
| ESXi 7.0 설치하고 Ubuntu VM에 전공 동아리 홈페이지 호스팅 (0) | 2020.08.24 |
| [홈랩] 홈 네트워크 구축 V1 (0) | 2020.08.17 |