물리 호스트가 2대뿐인 홈랩에 Kubernetes 클러스터를 설계할 때 가장 먼저 부딪히는 문제는 마스터 노드를 몇 대 두고 어디에 놓느냐입니다. 저는 마스터 3대와 워커 4대로 클러스터를 만들고, API 주소를 처음부터 가상 IP로 정해 나중에 노드를 옮기거나 늘려도 주소가 바뀌지 않게 했습니다. 이 글에서는 마스터 수를 정한 기준, 두 호스트에 노드를 나눠 둔 방법, 노드 OS와 구성 요소를 고른 이유, 버전을 고르는 기준을 정리합니다. 홈랩 재구성 시리즈 2편이며, 이전 글은 홈랩 인프라 현황과 Kubernetes로 옮기는 이유입니다.
1. 설계 조건
설계는 홈랩이 가진 조건에서 시작했습니다.
| 조건 | 내용 |
| 호스트 | ESXi 호스트 2대, 메모리 128GB와 64GB |
| 연결 | 두 호스트 사이 10Gbps, 공유 스토리지 없이도 vMotion 가능 |
| 스토리지 | 호스트별 로컬 SSD, NAS의 NFS 볼륨 |
| 서비스 | 대부분 트래픽이 적은 웹 사이트와 LMS |
| 운영 | 혼자 운영하므로 자료가 많고 표준에 가까운 구성을 우선 |
마지막 조건이 대부분의 선택을 좌우했습니다. 혼자 운영하는 홈랩은 문제가 생겼을 때 물어볼 사람이 없으므로, 공식 문서와 사례가 많은 표준 도구를 고르는 편이 결국 시간을 아낍니다.
2. 마스터 노드는 몇 대로 할까
kubeadm 기본 구성에서는 클러스터 상태를 저장하는 etcd가 마스터 노드에서 함께 실행됩니다. etcd는 전체의 과반수가 살아 있어야 쓰기를 처리하므로, 마스터 수에 따라 견딜 수 있는 장애 대수가 정해집니다.
| 마스터 수 | 과반수 / 견딜 수 있는 장애 |
| 1대 | 1대 / 0대 |
| 2대 | 2대 / 0대 |
| 3대 | 2대 / 1대 |
| 4대 | 3대 / 1대 (3대와 같고 복제 비용만 늘어남) |
| 5대 | 3대 / 2대 |
2대와 4대는 견딜 수 있는 장애 대수가 각각 1대, 3대일 때와 같습니다. 그래서 마스터는 보통 홀수로 둡니다. 홈랩 규모에서는 3대가 알맞다고 보고 3대로 정했습니다.
문제는 호스트가 2대라는 점입니다. 마스터 3대를 두 호스트에 나누면 어떻게 해도 한쪽에 2대가 몰립니다. 2대가 있는 호스트가 멈추면 과반을 잃어 클러스터를 관리할 수 없고, 1대가 있는 호스트가 멈출 때만 버틸 수 있습니다. 4대를 2대씩 나누는 방법도 생각해 봤지만, 어느 호스트가 멈춰도 4대 중 2대만 남아 과반(3대)에 못 미치므로 더 나쁩니다.
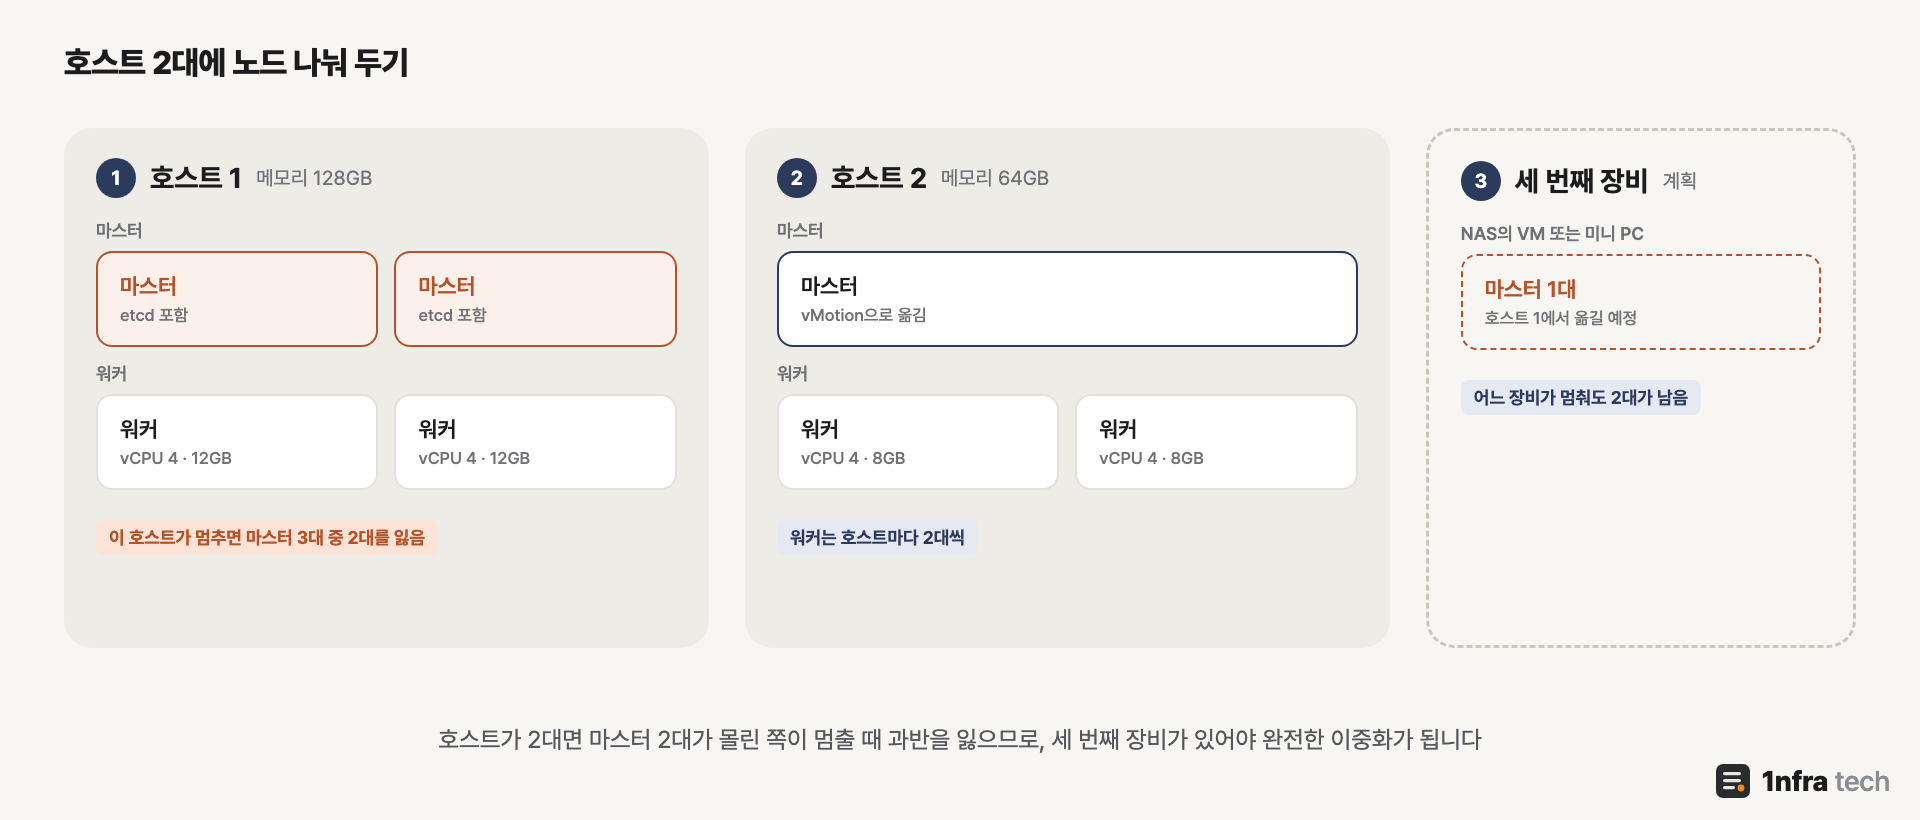
호스트가 2대면 마스터 2대가 몰린 쪽이 멈출 때 과반을 잃으므로, 세 번째 장비가 있어야 완전한 이중화가 됩니다
완전한 이중화를 하려면 세 번째 장애 영역이 필요합니다. NAS에서 돌리는 작은 VM이나 미니 PC에 마스터 1대를 두면, 어느 장비 하나가 멈춰도 마스터 2대가 남습니다. 지금은 장비를 추가하기 전이라 이 상태를 완전한 이중화로 보지 않고, 이후 장비를 추가해 마스터를 나눠 둘 계획입니다.
3. 단계별로 나눠 만들기
처음부터 두 호스트에 나눠 만들지 않고 단계를 나눴습니다. 노드도 VM이라 나중에 vMotion으로 옮기면 되기 때문입니다.
| 단계 | 내용 |
| 1단계 | 여유가 많은 호스트 1에 마스터 3대와 워커 2대로 클러스터를 만듦 |
| 2단계 | 호스트 2에 워커 2대를 추가하고, 마스터 1대를 vMotion으로 옮김 |
| 3단계 | 세 번째 장비를 마련해 마스터 1대를 옮김 (계획) |
1단계에서 꼭 지킨 것은 API 주소를 처음부터 가상 IP로 정하는 것입니다. 클러스터를 만들 때 마스터 1대의 IP를 API 주소로 쓰면, 그 주소가 인증서와 모든 노드 설정에 들어가 나중에 마스터를 늘리거나 바꾸기 어렵습니다. 처음부터 마스터들이 함께 쓰는 가상 IP를 API 주소로 정해 두면, 노드를 옮기거나 늘려도 주소가 그대로입니다.
2단계에서 마스터 1대를 호스트 2로 옮길 때는 서비스를 멈추지 않았습니다. 두 호스트 사이가 10Gbps라 디스크까지 함께 옮기는 vMotion이 1분 49초 만에 끝났고, 옮기는 동안 1초마다 확인한 API 응답 101건이 모두 정상이었습니다. 옮기기 전에는 etcd 리더와 가상 IP가 옮길 마스터에 있지 않은지 확인했습니다. 리더나 가상 IP를 가진 노드를 옮기면 잠깐이라도 리더 선출이나 주소 이동이 일어나기 때문입니다.
4. 노드 사양과 배치
| 노드 | 사양 |
| 마스터 3대 | vCPU 2개, 메모리 4GB, 디스크 40GB |
| 워커 2대 (호스트 1) | vCPU 4개, 메모리 12GB, 디스크 80GB |
| 워커 2대 (호스트 2) | vCPU 4개, 메모리 8GB, 디스크 80GB |
호스트 2의 워커는 메모리를 8GB로 줄였습니다. 호스트 2는 메모리가 64GB라서 12GB씩 주면 사용률이 약 92%까지 올라가기 때문입니다. 워커 사양이 달라도 Kubernetes는 노드마다 할당할 수 있는 자원과 Pod가 요청한 자원을 보고 배치하므로 함께 쓸 수 있습니다.
| 호스트 | 마스터 | 워커 |
| 호스트 1 | 2대 | 2대 |
| 호스트 2 | 1대 | 2대 |
워커는 호스트마다 2대씩 두었습니다. 마스터 과반이 유지되는 상황이라면 호스트 2가 멈춰도 서비스 Pod를 호스트 1의 워커에서 다시 실행할 수 있습니다. 다만 노드 로컬 디스크를 쓰는 Pod는 데이터가 있는 노드에서만 실행됩니다. 클러스터를 만든 뒤 호스트 1의 메모리 사용량은 78GB에서 97.8GB로 늘었습니다.
5. 노드 OS
노드 OS는 Ubuntu 24.04 LTS와 Rocky Linux 9를 비교했습니다.
| 항목 | Ubuntu 24.04 / Rocky 9 |
| 자료 | Kubernetes 관련 자료가 가장 많음 / 기업 온프레미스와 OpenShift 계열에서 많이 씀 |
| 커널 | 6.8, eBPF를 쓰는 Cilium에 유리 / 5.14 |
| 보안 모듈 | AppArmor / SELinux, Kubernetes에서 설정할 것이 더 많음 |
| 지원 기간 | 2029년 4월(Ubuntu Pro 가입 시 2034년) / 2032년 5월 |
지원 기간은 Rocky 9가 길지만, 혼자 운영하는 홈랩에서는 자료가 많고 커널이 새로운 Ubuntu 24.04가 낫다고 판단했습니다. 2026년 4월에 나온 Ubuntu 26.04 LTS도 검토했지만, 아직 Kubernetes와 함께 쓴 사례가 적어 24.04를 골랐습니다.
6. 구성 요소 선택
| 영역 | 선택과 이유 |
| 설치 도구 | kubeadm, 공식 도구라 자료가 많고 구조를 이해하기 좋음 |
| 컨테이너 런타임 | containerd, Kubernetes에서 가장 널리 쓰는 컨테이너 런타임 |
| API 가상 IP | kube-vip, 별도 로드밸런서 VM 없이 마스터끼리 가상 IP를 넘겨받음 |
| 네트워크(CNI) | Cilium, eBPF 기반이고 kube-proxy 대체와 Gateway API 구현까지 함께 지원 |
| 외부 노출 | Cilium Gateway API, ingress-nginx는 2026년 3월에 유지보수가 끝남 |
| LoadBalancer | MetalLB(L2), 서비스망의 IP 10개를 Service에 나눠 줌 |
| 인증서 | cert-manager, 인증서 발급과 갱신 자동화 |
| 배포 | Argo CD, Git 저장소의 내용대로 클러스터를 맞추는 GitOps |
| 모니터링 | 기존 Zabbix 7.0의 Kubernetes 연동, VM과 클러스터를 한 화면에서 봄 |
| 스토리지 | local-path(노드 로컬 디스크), NAS 연동은 네트워크 경로 문제로 보류 |
1편에서 정한 대로 로드밸런서 VM 2대가 하던 일은 MetalLB와 Gateway API가 대신합니다. MetalLB가 서비스망의 IP를 하나 맡고, Gateway가 그 IP로 들어온 요청을 호스트 이름에 따라 각 서비스로 나눕니다.
계획과 달라진 것도 있습니다. 모니터링은 처음에 Prometheus 기반의 kube-prometheus-stack을 생각했지만, 이미 VM을 Zabbix로 보고 있어서 Zabbix의 공식 Kubernetes 연동으로 바꿨습니다. 혼자 운영하는 홈랩에서는 여러 화면보다 한 화면에서 확인하는 편이 장애를 놓칠 가능성이 적기 때문입니다. 스토리지는 NAS를 쓰는 CSI 드라이버를 계획했지만, 서비스망에서 NAS로 가는 경로가 막혀 있어 우선 노드 로컬 디스크만 씁니다. 처음에는 계획에 없던 클러스터 내부 이미지 저장소(registry)도 하나 두었습니다. 직접 만든 서비스 이미지를 외부 저장소에 올리지 않고 클러스터 안에서 바로 받기 위해서입니다.
7. 버전 고르는 기준
버전은 두 가지 기준으로 골랐습니다.
- 나온 지 2주 이상 지난 릴리스만 쓴다
- 구성 요소끼리 공식적으로 지원하는 조합인지 문서로 확인한다
처음 기준은 막 나온 버전에서 발견되는 문제를 피하기 위한 것입니다. 실제로 cert-manager는 최신 1.21.3이 나온 지 5일밖에 되지 않아 1.21.2를 썼고, kube-vip도 10월 중순에 나온 1.3 대신 1.2.4를 썼습니다.
두 번째 기준 덕분에 설치 직전에 버전을 바꿨습니다. 처음에는 Kubernetes 1.37을 설치하려고 했는데, 클러스터를 만들기 직전에 Cilium 문서를 확인해 보니 정식 출시된 Cilium 1.20은 Kubernetes 1.36까지만 지원했습니다. 1.37 지원은 아직 개발 중인 1.21에만 있었습니다. 클러스터를 만들기 전이라 패키지만 바꾸면 됐으므로 Kubernetes 1.36.5로 내렸습니다. 네트워크(CNI)는 클러스터의 모든 통신이 지나가는 곳이라, 지원하지 않는 조합에서 생기는 문제는 원인을 찾기가 가장 어렵습니다.
| 구성 요소 | 버전 |
| Kubernetes | 1.36.5 |
| Cilium | 1.20.2 |
| containerd | 2.2.1 |
| kube-vip | 1.2.4 |
| MetalLB | 0.16.1 |
| Gateway API | 1.6.1 (Cilium 1.20.2 문서 기준 버전) |
| cert-manager | 1.21.2 |
| Argo CD | 3.5.5 |
Cilium 1.21이 정식 출시되면 Kubernetes 1.37로 올릴 계획입니다. 다음 글에서는 이렇게 만든 클러스터로 첫 서비스를 옮긴 과정을 정리하겠습니다.
8. 정리
- etcd는 과반수가 살아 있어야 동작하므로 마스터는 홀수로 두고, 홈랩에서는 3대가 알맞습니다.
- 호스트가 2대면 한쪽에 마스터 2대가 몰리므로, 완전한 이중화에는 세 번째 장비가 필요합니다.
- API 주소는 처음부터 가상 IP로 정해야 나중에 마스터를 늘리거나 옮기기 쉽습니다.
- 노드는 한 호스트에 먼저 만들고, 10Gbps 연결을 이용해 vMotion으로 서비스를 멈추지 않고 나눴습니다.
- 혼자 운영하는 홈랩이라 자료가 많은 Ubuntu 24.04와 표준 도구를 골랐습니다.
- 버전은 나온 지 2주가 지나고 서로 지원하는 조합만 쓰며, 그 기준으로 Kubernetes 1.37 대신 1.36.5를 골랐습니다.
참고
'Project > 홈랩' 카테고리의 다른 글
| [홈랩] Jenkins와 Argo CD로 홈랩 CI/CD 구성하기 (0) | 2026.10.29 |
|---|---|
| [홈랩] 웹 서비스 VM을 Kubernetes로 옮기고 검증하기 (0) | 2026.10.28 |
| [홈랩] 홈랩 인프라 현황과 Kubernetes로 옮기는 이유 (0) | 2026.10.28 |
| [홈랩] 홈 네트워크 구축 V2 (0) | 2020.11.04 |
| ESXi 7.0 설치하고 Ubuntu VM에 전공 동아리 홈페이지 호스팅 (0) | 2020.08.24 |