홈랩의 모니터링 서버에서는 지원이 끝난 Zabbix 5.4를 사용했습니다. Zabbix 7.0은 더 새로운 MySQL과 PHP가 필요해서, 제자리 업그레이드 대신 새 VM을 만들어 DB를 옮기는 방식으로 이전했습니다. 모니터링이 멈춘 시간은 약 18분이었고, 이전한 뒤에는 Zabbix의 공식 연동으로 Kubernetes 클러스터까지 한 화면에서 확인할 수 있게 했습니다. 이 글에서는 새 VM으로 옮긴 이유와 전환 순서, 그 과정에서 만난 문제, Kubernetes 모니터링과 웹 감시 설정을 정리합니다. 홈랩 재구성 시리즈 6편이며, 이전 글은 PHP 사이트 6개와 MySQL을 옮기고 Gateway 하나로 합치기입니다.
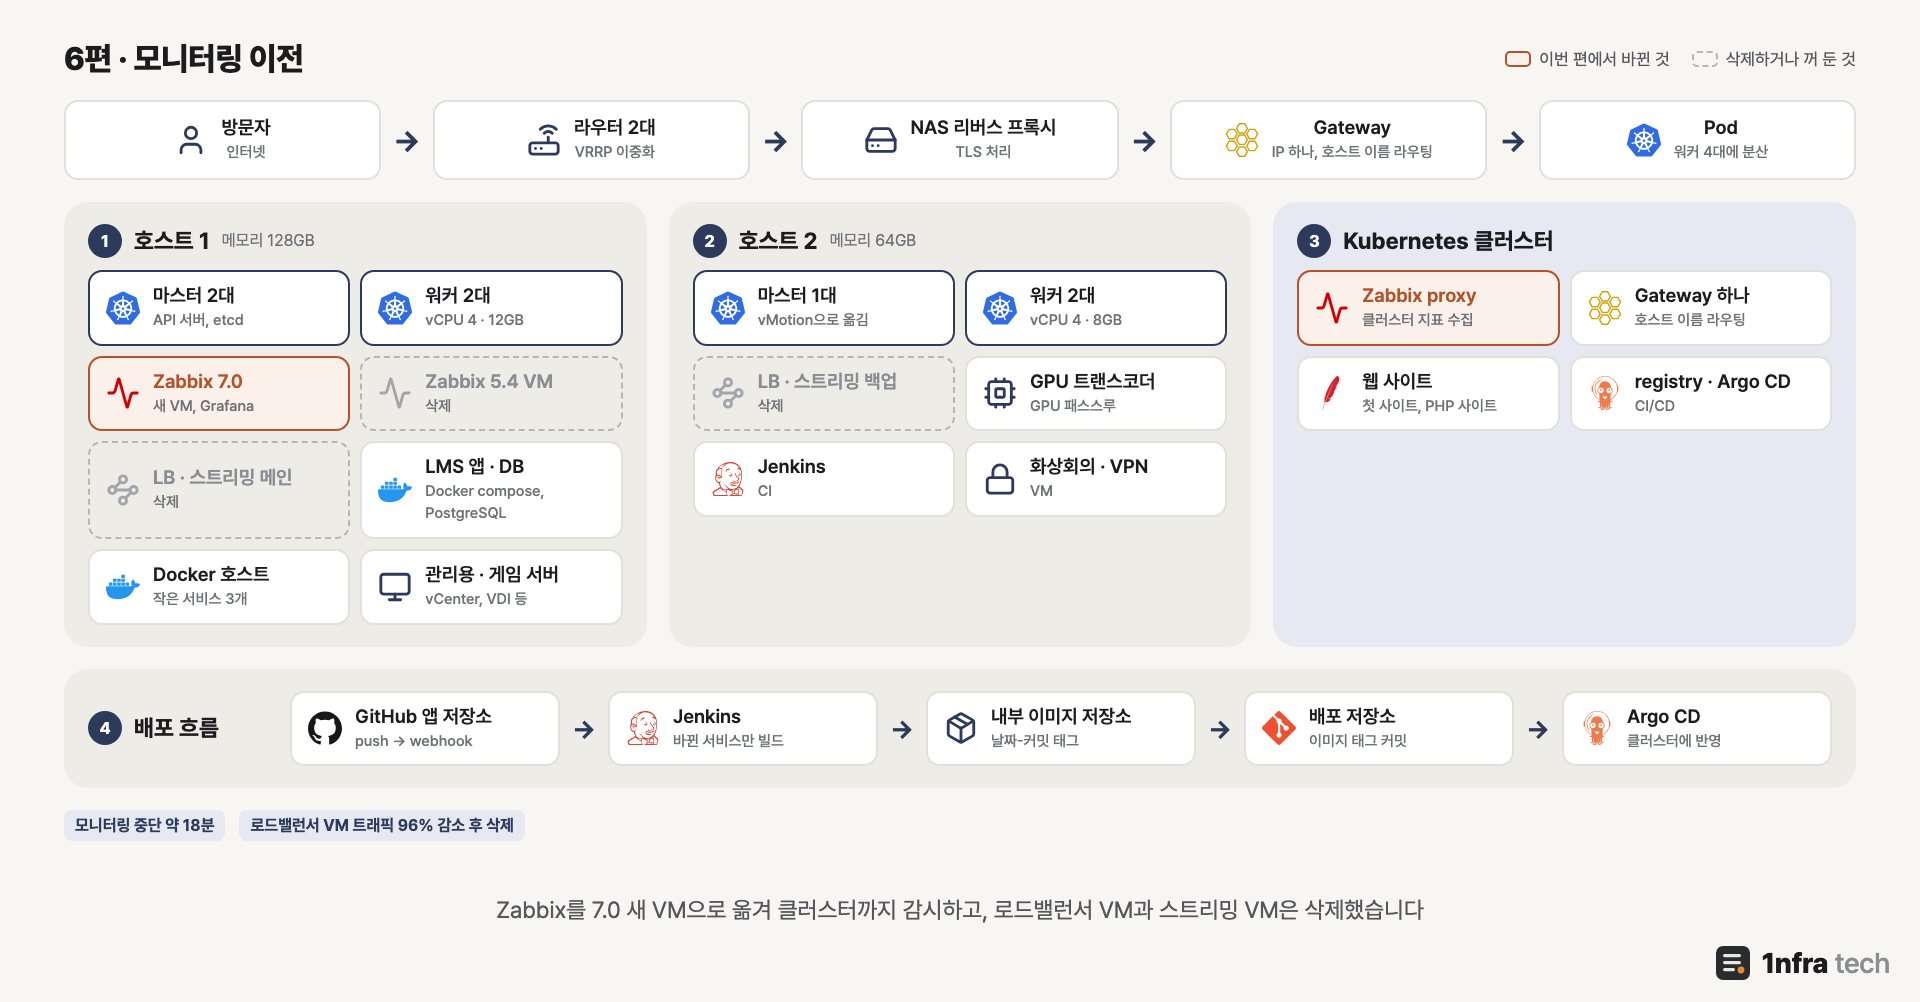
6편을 마친 시점의 구성입니다. Zabbix를 7.0 새 VM으로 옮기고, 로드밸런서 VM과 스트리밍 VM은 삭제했습니다
1. 기존 모니터링 서버
| 항목 | 내용 |
| Zabbix | 5.4, LTS가 아니라 지원이 이미 끝남, 패키지가 아니라 소스로 설치됨 |
| OS와 DB | Ubuntu 18.04, MySQL 5.7, PHP 7.2 |
| 규모 | 호스트 28개, 아이템 약 1만 개, 트리거 약 4,500개, DB 5.4GB |
| 네트워크 | NIC 3개로 서비스망, 관리망, 장비 관리망을 함께 감시 |
| 그 밖 | Grafana 10과 Zabbix 플러그인 |
Zabbix 7.0 LTS는 MySQL 8.0.30 이상과 PHP 8.0 이상이 필요합니다. 기존 서버에서 OS, DB, PHP, Zabbix를 모두 올리는 것보다 새 VM을 만들어 DB만 옮기는 편이 안전하다고 판단했습니다. 새 VM에 문제가 생기면 기존 VM을 다시 켜면 되기 때문입니다.
버전은 7.0.31을 골랐습니다. 7.0.32는 나온 지 1주일밖에 되지 않았고, 다음 LTS인 8.0은 아직 출시 전이었습니다.
2. 새 VM 준비
새 VM은 Kubernetes 노드와 같은 방식으로 Ubuntu 24.04를 무인 설치했습니다. 기존 서버처럼 NIC 3개가 필요했는데, NIC가 여러 개면 OS가 각 NIC에 붙이는 인터페이스 이름이 바뀔 수 있습니다. 그래서 NIC마다 고정 MAC 주소를 지정하고, 네트워크 설정(netplan)에서 MAC 주소로 인터페이스를 찾아 이름을 정해 두었습니다.
기존 서버의 설정값은 새 설정 파일로 옮겼습니다. 이때 기본 설정 파일에 이미 있는 키를 덧붙이는 바람에 같은 키가 두 번 들어갔고, Zabbix 서버가 시작되지 않았습니다. Zabbix는 설정 키가 중복되면 시작하지 않습니다. 기본값 쪽을 주석 처리하고, 7.0에 추가된 설정 검사 옵션(zabbix_server -T)으로 시작 전에 확인했습니다.
전환하기 전에는 기존 서버에서 불필요한 호스트도 정리했습니다. 연결이 끊긴 호스트 4개가 이미 삭제한 VM과 정확히 일치해서 지웠습니다. 옮길 데이터를 줄이고, 전환한 뒤 장애 목록에 이전과 관계없는 경보가 섞이지 않게 하기 위해서입니다.
3. 전환 순서
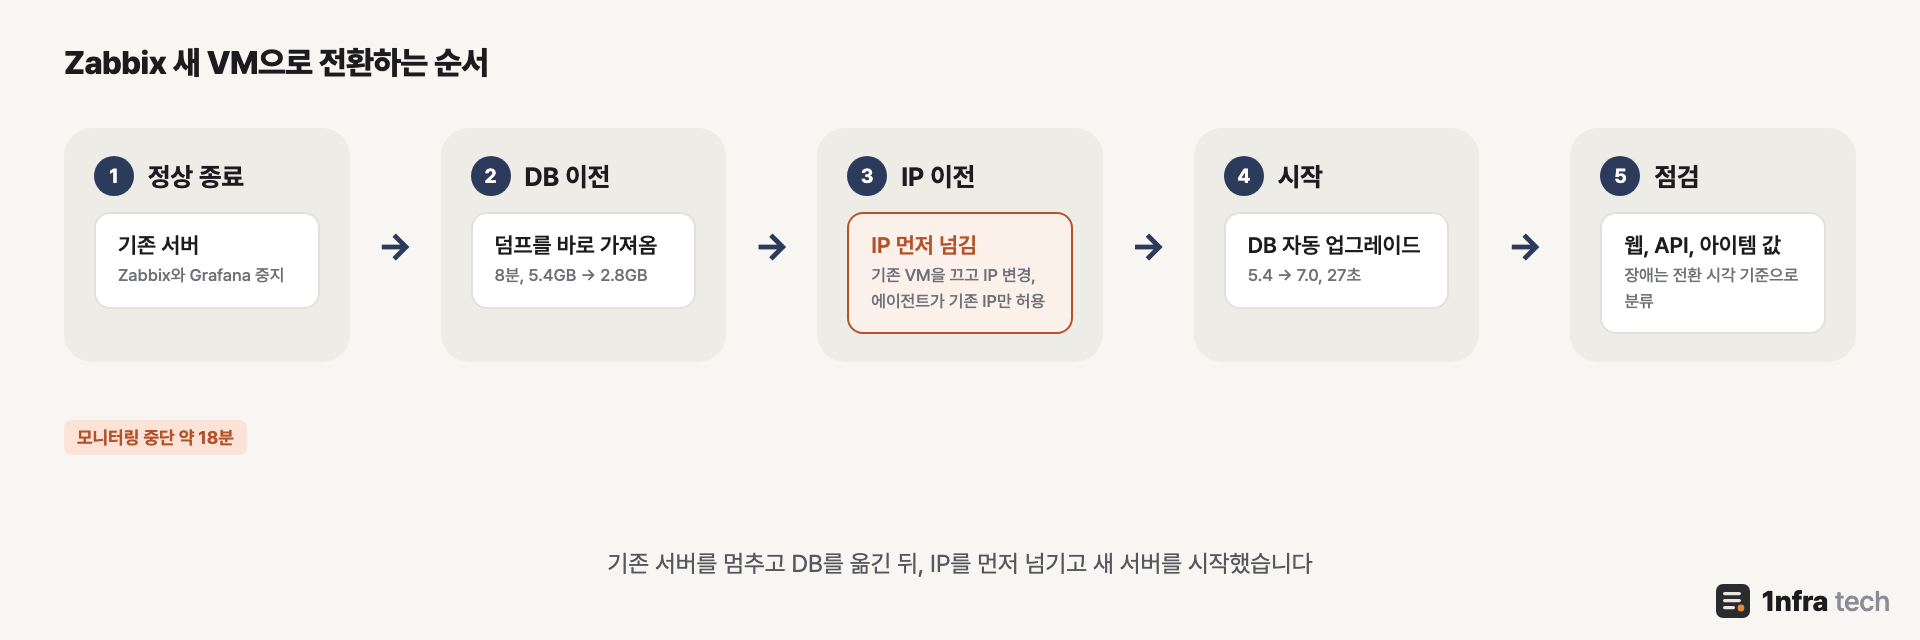
기존 서버를 멈추고 DB를 옮긴 뒤, IP를 먼저 넘기고 새 서버를 시작했습니다
| 순서 | 내용 |
| 1 | 기존 Zabbix 서버를 정상 종료하고 Grafana도 멈춤 |
| 2 | 기존 DB를 덤프해 새 서버의 MySQL로 바로 가져옴 |
| 3 | 기존 VM을 끄고 새 VM의 IP를 기존 IP로 바꿈 |
| 4 | 새 Zabbix 서버를 시작하면 DB가 7.0 형식으로 자동 업그레이드됨 |
| 5 | 웹 화면, API, 주요 아이템 값, Grafana를 확인 |
DB를 가져오다가 한 번 실패했습니다. 컬럼이 70개 가까이 되는 테이블을 만들 때 MySQL 8이 행 크기가 너무 크다며 거부했습니다. 기존 테이블과 형식은 같았지만, MySQL 8의 엄격 모드(innodb_strict_mode)는 실제 데이터가 아니라 가능한 최대 행 크기를 계산해서 거부합니다. 실제 데이터는 작으므로, 가져오는 세션에서만 엄격 모드를 끄고 DB를 비운 뒤 다시 가져왔습니다. 두 번째 가져오기는 8분 만에 끝났고, 테이블 166개와 호스트, 아이템, 이력 행 수가 모두 기존과 같았습니다. DB 용량은 조각화가 정리되어 5.4GB에서 2.8GB로 줄었습니다.
순서에서 가장 신경 쓴 부분은 3번입니다. 새 서버를 임시 IP로 먼저 시작하면, 각 서버의 Zabbix 에이전트는 기존 IP만 허용하도록 설정되어 있어 새 서버의 접속을 거부합니다. 그러면 모든 호스트에서 장애 알림이 쏟아집니다. 그래서 기존 VM을 끄고 IP를 먼저 넘긴 뒤 새 서버를 시작했습니다.
새 서버를 시작하자 DB가 5.4 형식에서 7.0 형식으로 27초 만에 자동 업그레이드되었습니다. 기존 서버를 멈춘 때부터 새 서버가 수집을 시작할 때까지 모니터링이 멈춘 시간은 약 18분이었습니다. 전환한 뒤에는 사용자 언어가 한국어인 계정으로 웹 화면에 들어가자 로케일이 없다는 오류가 났습니다. Ubuntu 24.04 서버 설치본에 한국어 로케일이 없어서 생긴 문제라, 로케일을 만들고 웹 서버를 다시 시작해 해결했습니다.
4. 전환 후 점검
전환한 뒤 장애 목록에 17건이 있었습니다. 이것을 전환 시각 기준으로 나눠 보니 14건은 전환 전부터 있던 것이었고, 전환 뒤에 생긴 3건 중 2건은 서버 OS가 바뀌어서 생긴 정보성 경보였습니다. 나머지 1건은 VDI의 실제 디스크 사용률에 따른 경보였습니다. 이전 때문에 생긴 문제는 없다고 판단하고 기존 VM을 삭제했습니다.
서버 이전처럼 감시 대상이 그대로 유지되는 작업에서는 전환 시각을 기준으로 장애를 나눠 보면 이전 때문에 생긴 것과 원래 있던 것을 쉽게 구분할 수 있습니다.
5. Kubernetes 모니터링
Kubernetes는 Zabbix의 공식 연동을 썼습니다. 공식 Helm 차트로 클러스터 안에 Zabbix proxy와 kube-state-metrics를 띄우고, 각 노드에 에이전트(agent2)를 배포했습니다. 이 차트도 Argo CD로 배포했습니다. proxy가 클러스터 정보를 모아 Zabbix 서버로 보내는 구조입니다.
| 문제 | 해결 |
| 업그레이드한 DB에는 7.0의 Kubernetes 템플릿이 없음 | 공식 저장소의 7.0 템플릿을 가져옴, 새로 설치하면 있는 호스트 그룹도 직접 만듦 |
| proxy가 API 서버 인증서를 신뢰하지 않아 탐색 실패 | 공식 proxy 이미지에 클러스터 CA 인증서를 더한 이미지를 만들어 씀 |
| 에이전트 접속 허용 범위가 차트 기본값으로 모든 주소 | Pod 대역으로 좁힘 |
설정을 마치자 API 서버, 컨트롤러 매니저, 스케줄러, kubelet 호스트 16개가 자동으로 만들어졌습니다. 처음에는 컨트롤러 매니저와 스케줄러의 값이 들어오지 않았습니다. kubeadm 기본 설정에서는 127.0.0.1에서만 지표를 제공하기 때문입니다. 마스터를 한 대씩 돌며 정적 Pod 설정의 bind-address를 0.0.0.0으로 바꾸고, 상태 확인이 정상인 것을 본 뒤 다음 마스터로 넘어갔습니다. 노드 IP가 아니라 0.0.0.0으로 연 이유는 이 컴포넌트들의 liveness probe가 127.0.0.1로 확인하기 때문입니다. kubeadm으로 업그레이드한 뒤에도 유지되도록 클러스터의 kubeadm 설정(kubeadm-config)에도 같은 값을 넣었습니다.
그 뒤에도 컨트롤러 매니저 하나에서만 값이 통째로 들어오지 않았습니다. 리더 컨트롤러 매니저만 내보내는 지표에는 노드의 zone 라벨 값이 들어가는데, region 라벨 없이 zone 라벨만 붙인 노드의 경우, 이 값에 구분용 NUL 문자가 섞입니다. 이 문자 때문에 Zabbix의 Prometheus 지표 파싱이 실패했습니다. 7편에서 다룰 노드 분산용 라벨을 표준 zone 라벨 대신 사용자 정의 라벨로 바꿔 해결했습니다.
6. 웹 감시와 대시보드
Kubernetes로 옮긴 사이트는 웹 시나리오로 따로 감시합니다. 이때 상태 코드 200만 확인하지 않고, 페이지 본문에 사이트마다 정한 문구가 있는지도 확인합니다. 5편에서처럼 상태 코드는 200인데 다른 사이트 내용이 나오는 경우도 잡기 위해서입니다. Zabbix의 웹 시나리오는 장애 트리거를 자동으로 만들지 않으므로, 각 시나리오에 실패 시 경보를 내는 트리거를 직접 추가했습니다.
대시보드는 4쪽으로 만들고 60초마다 넘어가게 했습니다.
| 쪽 | 내용 |
| 개요 | 네트워크 맵, 심각도별 장애, 호스트 가용성, 현재 장애 |
| 가상 머신 | VM별 CPU와 메모리 순위, 사용률 그래프 |
| Kubernetes | 노드와 Pod의 Ready 상태를 칸으로 보여 주는 honeycomb, Pod 재시작 그래프 |
| 네트워크 | 스위치 업링크와 라우터 트래픽 |
네트워크 맵은 스위치의 MAC 주소 표를 SNMP로 읽어 어느 포트에 어떤 장비가 연결되어 있는지 찾은 뒤 다시 그렸습니다. 선마다 그 포트의 송수신 트래픽을 표시하고, 링크가 끊기면 선이 빨간색으로 바뀌게 했습니다. Grafana에도 개요, VM, Kubernetes, LMS DB, 네트워크를 한 번에 보는 대시보드를 만들었습니다. Zabbix 그래프의 한글이 깨지는 문제는 웹 서버가 그래프를 그릴 때 쓰는 글꼴이 한글을 지원하지 않아 생겼고, 나눔고딕을 설치해 그래프 글꼴로 지정해 해결했습니다.
모니터링 기록으로 확인한 것도 있습니다. 로드밸런서 VM이 받던 트래픽은 시간대와 상관없이 1.1Mbps로 일정했는데, 실제 방문자의 요청이 아니라 매초 보내던 상태 확인 요청 때문이었습니다. 두 서비스를 Kubernetes로 옮긴 뒤 이 트래픽은 47Kbps로 96% 줄었고, 로드밸런서 VM은 꺼 두었다가 삭제했습니다.
다음 글에서는 Docker로 돌던 작은 서비스들과 LMS를 Kubernetes로 옮긴 과정을 정리하겠습니다.
7. 정리
- Zabbix 7.0은 새로운 MySQL과 PHP가 필요해서 제자리 업그레이드 대신 새 VM으로 이전했습니다.
- NIC가 여러 개인 VM은 MAC 주소로 인터페이스를 찾게 해서 이름을 고정했습니다.
- MySQL 8의 엄격 모드가 행 크기를 이유로 DB 가져오기를 거부하면, 가져오는 세션에서만 끄고 다시 가져올 수 있습니다.
- 에이전트가 기존 IP만 허용하므로 IP를 먼저 넘기고 새 서버를 시작해 경보 폭주를 막았습니다.
- 전환 후 장애는 전환 시각 기준으로 나눠 이전 때문에 생긴 것이 없는지 확인했습니다.
- Kubernetes는 공식 Helm 차트와 템플릿으로 연동했고, 컨트롤러 매니저와 스케줄러는 bind-address를 바꿔 수집합니다.
- 웹 감시는 상태 코드뿐 아니라 본문 문구까지 확인합니다.
참고
'Project > 홈랩' 카테고리의 다른 글
| [홈랩] PostgreSQL 스트리밍 복제와 VIP로 LMS DB 이중화하기 (8편) (0) | 2026.10.29 |
|---|---|
| [홈랩] Docker 컨테이너와 LMS를 Kubernetes로 옮기기 (7편) (0) | 2026.10.29 |
| [홈랩] PHP 사이트 6개와 MySQL을 옮기고 Gateway 하나로 합치기 (5편) (0) | 2026.10.29 |
| [홈랩] Jenkins와 Argo CD로 홈랩 CI/CD 구성하기 (4편) (0) | 2026.10.29 |
| [홈랩] 웹 서비스 VM을 Kubernetes로 옮기고 검증하기 (3편) (0) | 2026.10.28 |