LMS의 DB는 Kubernetes로 옮기지 않고 VM으로 남겼습니다. 대신 다른 호스트에 복제본 VM을 만들어 PostgreSQL 스트리밍 복제로 실시간 사본을 두고, 앱은 primary에만 붙는 VIP로 접속하게 했습니다. 이 글에서는 이중화 방식 선택, 복제 설정과 검증, VIP, 백업과 모니터링을 정리합니다. 홈랩 재구성 시리즈 8편이며, 이전 글은 Docker 컨테이너와 LMS를 Kubernetes로 옮기기입니다.
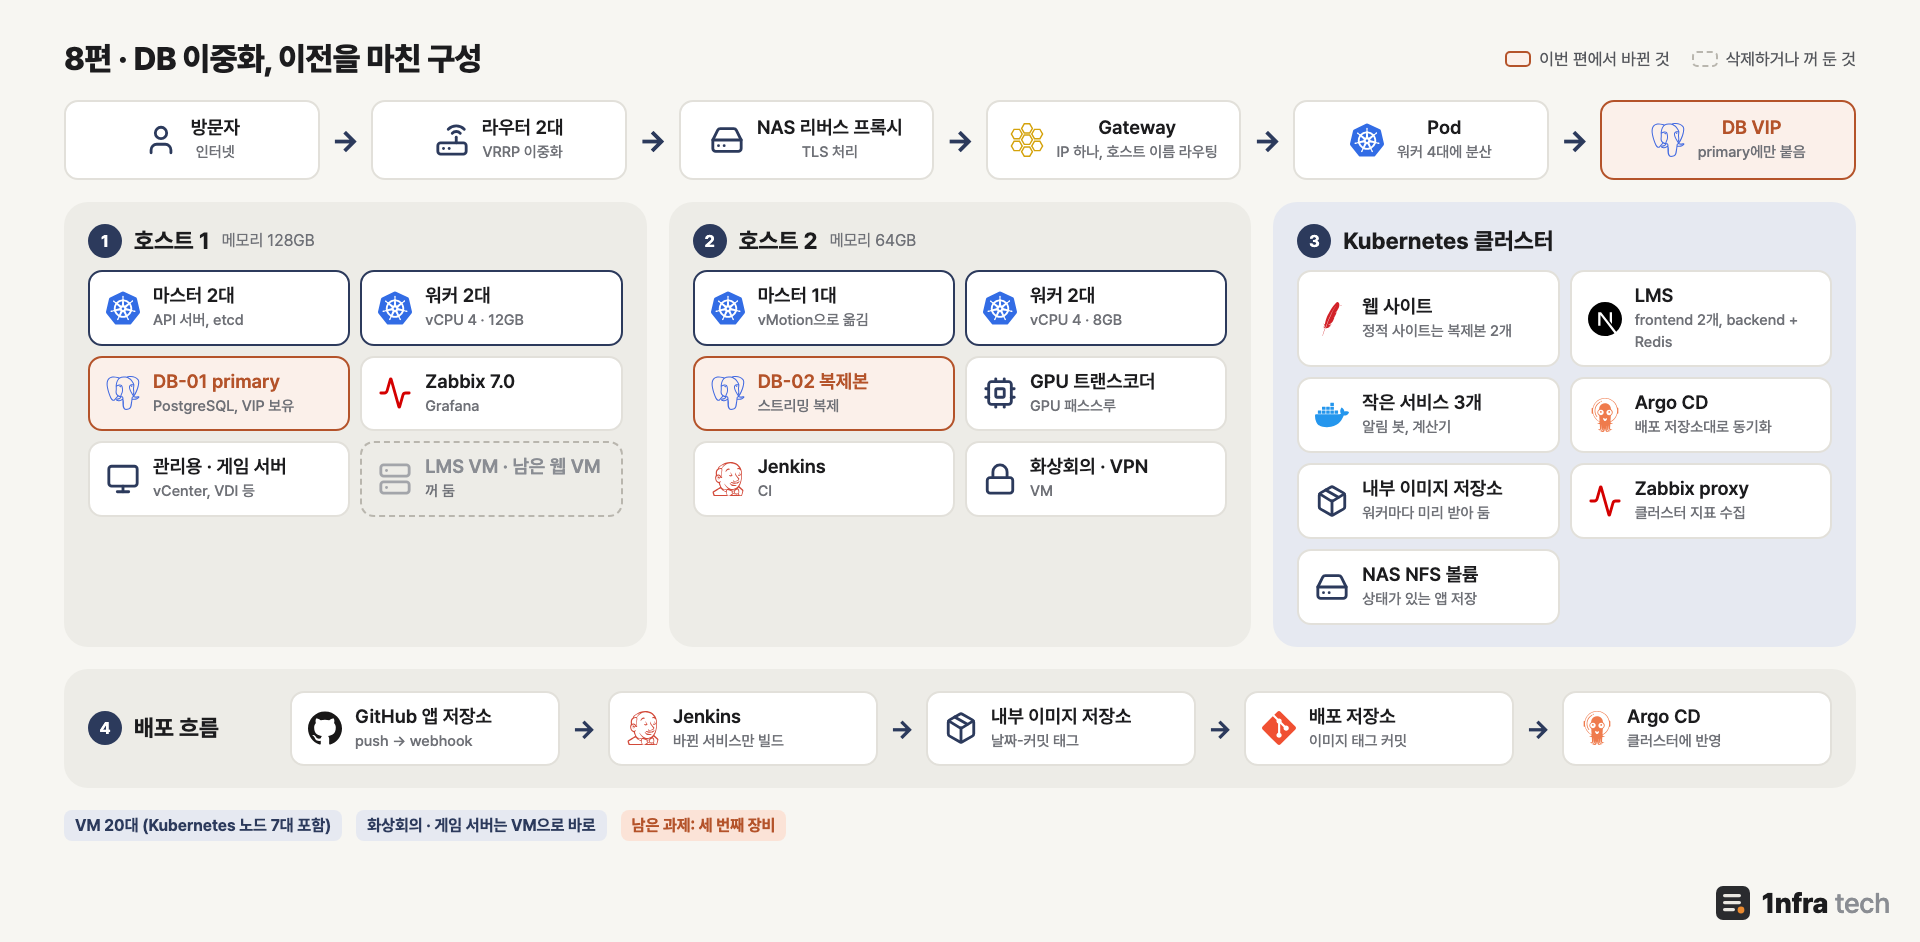
이전을 마친 구성입니다. 요청은 Gateway를 거쳐 Pod로 가고, 앱은 primary에만 붙는 DB VIP로 접속합니다
1. 이중화 방식 고르기
LMS DB는 호스트 1의 PostgreSQL 15 VM 1대에서 실행되고 있었습니다. 실시간 사본이 없어 호스트가 멈추면 DB도 함께 멈추는 구조였습니다. 두 방법을 비교했습니다.
| 항목 | VM 2대 스트리밍 복제 / Kubernetes 안의 DB(CloudNativePG) |
| 배치 | 호스트마다 VM 1대씩 / 인스턴스 2개를 호스트별로 나눔 |
| 장애 조치 | 수동 승격 후 VIP가 따라감 / 자동, 복제본 재생성도 자동 |
| 한계 | 사람이 승격해야 함 / 마스터 3대 중 2대가 있는 호스트 1이 멈추면 Kubernetes API가 중단되어 자동 장애 조치도 동작하지 않음 |
2편에서 정리한 대로 호스트 1이 멈추면 클러스터가 과반을 잃으므로, Kubernetes 안의 DB도 정작 그 상황에서는 자동 장애 조치를 하지 못합니다. 노드 로컬 디스크나 NAS 위의 DB도 아직 위험하다고 봤습니다(1편). 그래서 VM 2대 스트리밍 복제를 골랐습니다.
2. 복제본 VM 만들기
복제본은 호스트 2에 기존 DB와 같은 사양(vCPU 2개, 메모리 4GB)과 OS(Rocky Linux 9)로 만들었습니다. 라벨이 OEMDRV인 볼륨에 kickstart 파일을 넣어 붙이면 무인 설치됩니다.
3. primary 준비
운영 중인 기존 DB는 다시 시작하지 않고, 설정 다시 읽기(pg_reload_conf)로 적용되는 변경만 했습니다. 복제에 필요한 기본 설정(wal_level=replica, max_wal_senders, hot_standby)은 이미 켜져 있었습니다.
| 설정 | 내용 |
| 복제 계정 | 복제 전용 계정을 만들고 비밀번호는 별도 보관 |
| pg_hba | 복제본 IP에서 오는 복제 접속만 scram-sha-256으로 허용 |
| 복제 슬롯 | 복제본 전용 물리 슬롯을 만들어, 복제본이 잠시 멈춰도 필요한 WAL을 남겨 둠 |
| max_slot_wal_keep_size | 2GB, 슬롯이 WAL을 무한정 붙잡아 primary 디스크가 차는 것을 막음 |
복제 슬롯은 복제본이 따라잡을 때까지 WAL을 지우지 않으므로 상한이 필요합니다. 상한을 넘으면 그 복제본만 다시 만들면 됩니다.
4. 복제본 설정
복제본은 pg_basebackup으로 primary 데이터를 통째로 받았습니다. -R 옵션은 복제 접속 정보와 standby 설정을 자동으로 만듭니다. -S로 앞에서 만든 슬롯을 지정하고, -X stream으로 백업 중에 생긴 WAL까지 함께 받습니다. 복제 계정의 비밀번호는 postgres 계정의 .pgpass 파일에만 두었습니다.
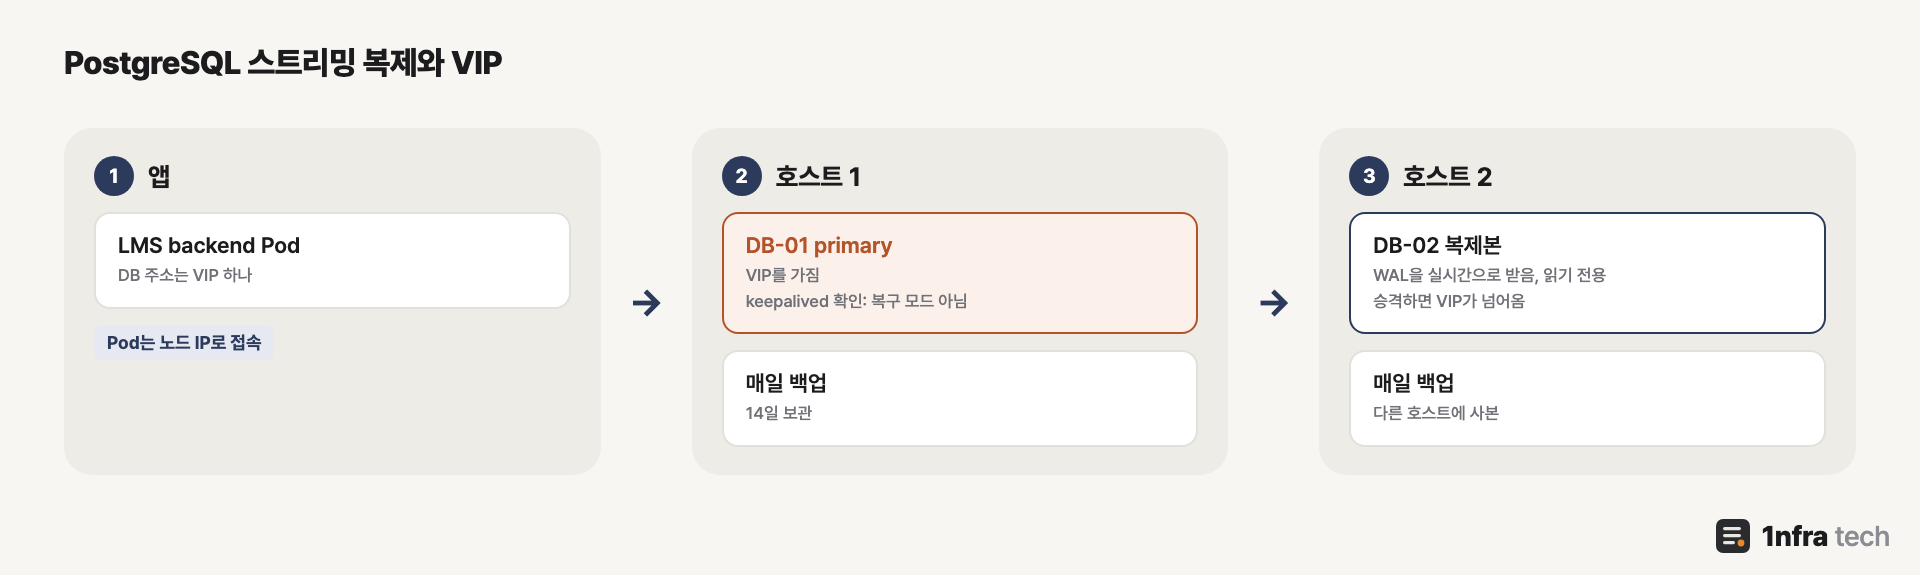
primary의 WAL이 복제본으로 실시간 전달되고, 앱은 primary에만 붙는 VIP로 접속합니다
5. 복제 확인
| 확인 | 결과 |
| primary의 복제 상태(pg_stat_replication) | 복제본이 streaming 상태, 지연 0바이트, 적용 지연 1ms |
| 복제 슬롯 | 사용 중(active) |
| 복제본의 복구 모드(pg_is_in_recovery) | true, 읽기 전용 복제본으로 동작 |
| 주요 테이블 행 수 | 양쪽이 같음 |
| 데이터 전체 덤프 해시 | 양쪽이 같음 |
WAL 위치를 바이트 단위로 비교해도 primary의 현재 위치와 복제본의 수신, 적용 위치가 같았습니다. 다만 비동기 복제라 primary가 갑자기 멈추면 마지막 몇 ms의 쓰기는 복제본에 없을 수 있습니다.
6. 앱이 접속할 VIP
앱이 DB IP를 직접 쓰면 승격 뒤 앱 설정을 모두 바꿔야 하므로, 두 DB 서버에 keepalived로 VIP를 두었습니다.
| 설정 | 내용 |
| VIP 조건 | 상태 확인 스크립트가 "복구 모드가 아님(pg_is_in_recovery = false)"을 확인한 서버, 즉 primary에만 VIP |
| 복제본 | 상태 확인이 실패하므로 VIP 없이 대기 |
| 승격 후 | 복제본을 primary로 올리면 상태 확인이 성공해 VIP가 넘어옴 |
| 통신 | VRRP를 unicast로 서로 지정 |
일반적인 keepalived 설정은 우선순위로 VIP를 정하지만, DB에서는 VIP가 반드시 primary를 따라가야 하므로 PostgreSQL에 직접 묻는 상태 확인을 조건으로 썼습니다.
SELinux가 켜진 Rocky Linux에서는 상태 확인 스크립트에 맞는 SELinux 라벨을 붙이고, 방화벽에 VRRP를 허용합니다. Pod에서 접속할 때는 출발지 IP가 노드 IP로 바뀌므로 pg_hba에 워커 노드 IP 대역을 추가했습니다.
7. 백업과 모니터링
백업은 두 서버 모두에서 매일 새벽 pg_dump로 받아 14일 보관하므로, 서로 다른 호스트에 사본이 하나씩 생깁니다.
두 서버에는 Zabbix agent2와 PostgreSQL 플러그인을 설치했습니다. 기본 템플릿에는 복제 상태 트리거가 없어서, 서버의 현재 역할에 따라 동작하는 트리거를 추가했습니다.
| 트리거 | 심각도 |
| primary에 연결된 복제본이 0개 | High |
| 복제본이 WAL을 받지 못함 | High |
| 복제 지연 64MB 초과 | Warning |
| primary가 2대 | Disaster |
마지막 트리거는 장애 조치 뒤 기존 primary가 다시 켜져 primary가 둘이 되는 상황을 잡습니다. 데이터가 갈라질 수 있어 가장 높은 심각도로 두었습니다.
8. 남은 일과 시리즈를 마치며
장애 조치는 아직 사람이 승격하는 방식입니다. 승격 절차를 문서로 정리하고, 세 번째 장비가 생기면 마스터와 DB의 자동 장애 조치를 다시 검토할 계획입니다.
이것으로 홈랩 재구성 시리즈에서 다룬 이관 작업을 마칩니다. 웹 서비스와 Docker 서비스, LMS는 Kubernetes로 옮겼고, DB와 관리용 서버는 VM으로 남겼습니다. 앱은 Jenkins와 Argo CD로 빌드하고 배포하며, 전체 상태는 Zabbix와 Grafana로 한곳에서 봅니다. VM은 한때 약 68대였지만, 지금은 Kubernetes 노드 7대를 포함해 20대입니다.
9. 정리
- 호스트가 2대뿐이면 Kubernetes 안의 DB도 호스트 1 장애 때 자동 장애 조치가 멈추므로, VM 2대 스트리밍 복제를 골랐습니다.
- primary는 다시 시작하지 않고 설정 다시 읽기만으로 복제 계정, pg_hba, 복제 슬롯을 준비했습니다.
- 복제 슬롯에는 max_slot_wal_keep_size로 상한을 두어 primary 디스크를 지킵니다.
- 복제 상태, 행 수, 전체 덤프 해시로 복제본이 primary와 같은지 확인했습니다.
- 비동기 복제라 primary가 갑자기 멈추면 마지막 몇 ms의 쓰기는 잃을 수 있습니다.
- keepalived VIP는 우선순위가 아니라 PostgreSQL에 직접 확인한 primary에만 붙게 했습니다.
- 복제 트리거는 서버 역할에 따라 동작하므로 장애 조치 뒤에도 그대로 쓸 수 있습니다.
참고
'Project > 홈랩' 카테고리의 다른 글
| [홈랩] Docker 컨테이너와 LMS를 Kubernetes로 옮기기 (7편) (0) | 2026.10.29 |
|---|---|
| [홈랩] Zabbix 5.4를 7.0 LTS로 옮기고 Kubernetes까지 모니터링하기 (6편) (1) | 2026.10.29 |
| [홈랩] PHP 사이트 6개와 MySQL을 옮기고 Gateway 하나로 합치기 (5편) (0) | 2026.10.29 |
| [홈랩] Jenkins와 Argo CD로 홈랩 CI/CD 구성하기 (4편) (0) | 2026.10.29 |
| [홈랩] 웹 서비스 VM을 Kubernetes로 옮기고 검증하기 (3편) (0) | 2026.10.28 |