이번에는 Docker VM에서 돌던 작은 서비스 3개와 LMS(학습 관리 시스템)를 옮겼습니다. 이미 컨테이너로 돌던 서비스라 VM에서 쓰던 컨테이너 이미지를 그대로 썼습니다. 가장 신경 쓴 점은 노드 하나가 멈춰도 다른 워커에서 계속 동작하게 하는 것입니다. 이 글에서는 Docker 서비스를 옮긴 방법, 두 곳에서 동시에 돌면 안 되는 알림 봇을 옮기는 순서, LMS를 노드 장애에 견디게 만든 설계와 전환 과정을 정리합니다. 홈랩 재구성 시리즈 7편이며, 이전 글은 Zabbix 5.4를 7.0 LTS로 옮기고 Kubernetes까지 모니터링하기입니다.
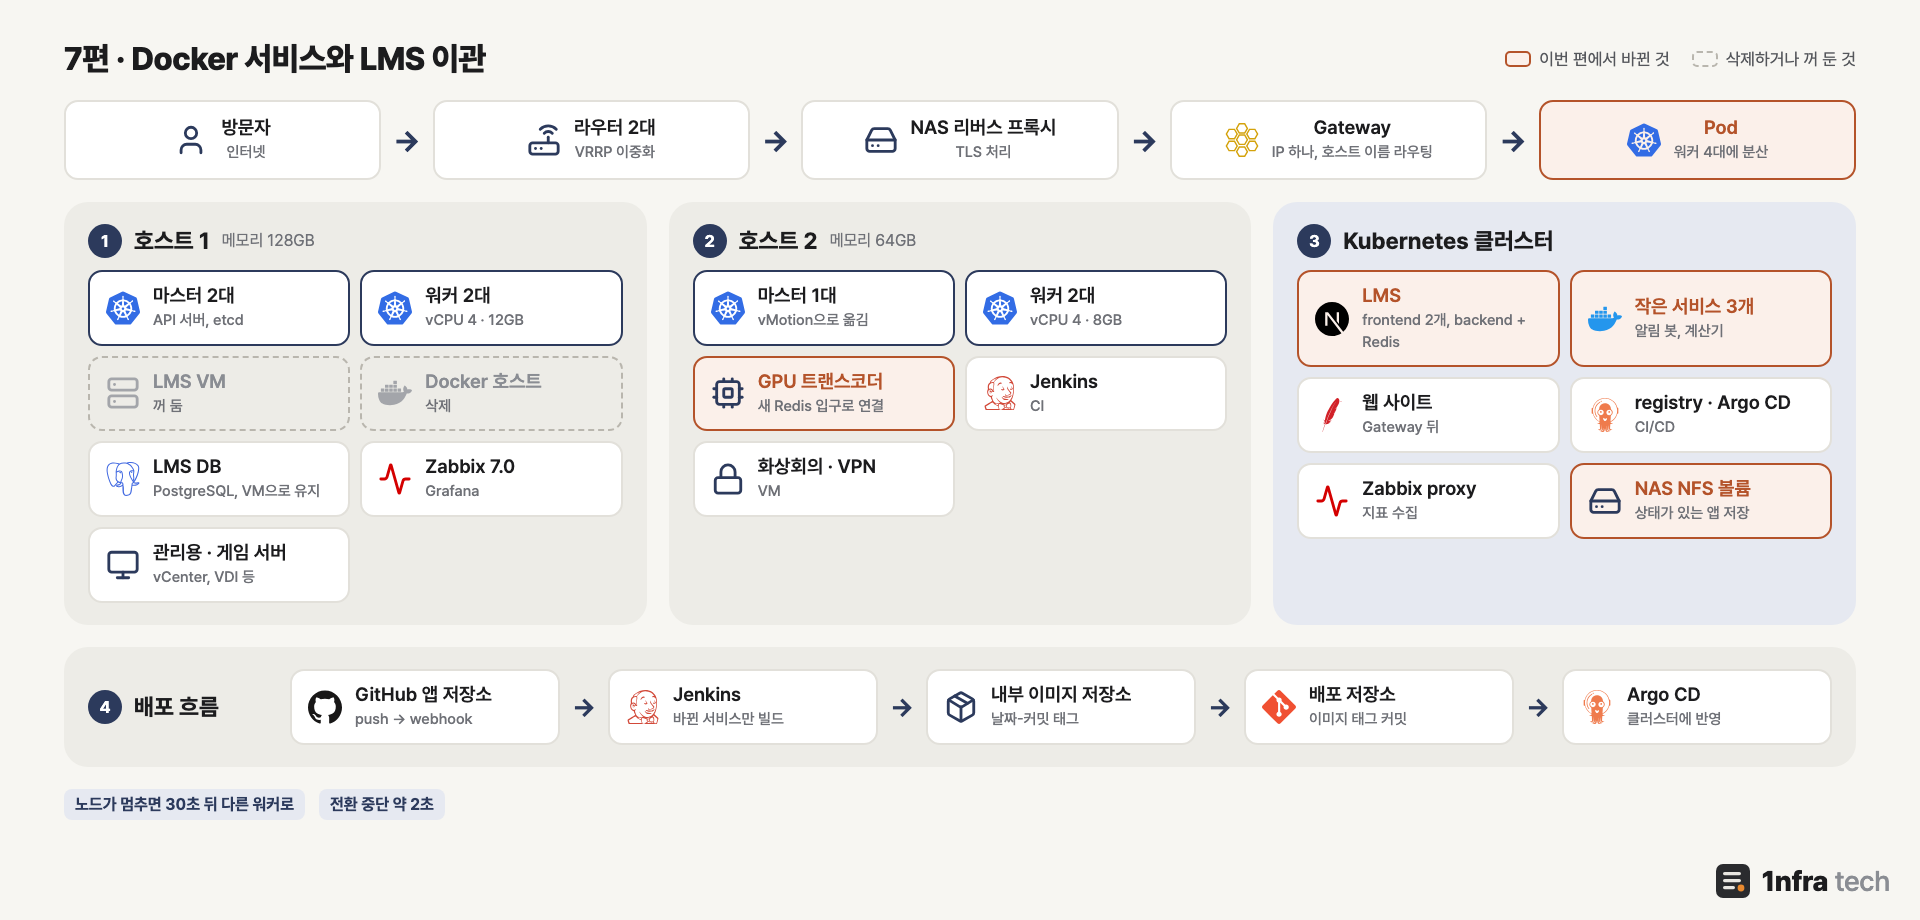
7편을 마친 시점의 구성입니다. Docker 서비스와 LMS를 옮기고, 노드가 멈춰도 다른 워커에서 다시 실행되게 했습니다
1. Docker VM의 서비스 3개
| 서비스 | 구성과 데이터 |
| GPU 비교 계산기 | Next.js 앱과 PostgreSQL |
| 숙소 빈방 알림 봇 | 60분마다 확인해 알림 전송, 설정 파일과 상태 파일 |
| 영화 예매 알림 봇 | 60초마다 확인해 알림 전송, 설정 파일(알림 토큰)과 상태 파일 |
세 서비스 모두 VM에서 쓰던 컨테이너 이미지를 그대로 내보내 내부 이미지 저장소에 올리고, 매니페스트 digest가 같은지 확인했습니다. 다시 빌드하면 의존성 버전이 바뀔 수 있기 때문입니다. 소스가 있는 서비스는 이후 Jenkins CI로 빌드하도록 바꿨습니다(4편).
2. 설정과 상태 파일 옮기기
Secret은 VM 컨테이너의 환경 변수에서 필요한 값만 골라 만들었습니다. DB 주소의 호스트 이름이 compose 서비스 이름(postgres)이라, Kubernetes Service 이름도 postgres로 맞춰 앱 설정은 고치지 않아도 되게 했습니다.
알림 봇의 설정 파일은 웹 화면에서 바꾸면 앱이 직접 고쳐 씁니다. 그래서 Pod 안에서 읽기 전용인 ConfigMap 대신 영구 볼륨에 두었습니다.
알림 봇은 VM과 Kubernetes에서 동시에 돌면 같은 알림이 두 번 가므로 옮기는 순서가 중요합니다.
| 순서 | 내용 |
| 1 | Kubernetes에 영구 볼륨과 복사용 임시 Pod를 만듦 |
| 2 | VM의 봇 컨테이너를 멈춤 (삭제하지 않아 되돌릴 수 있음) |
| 3 | 설정과 상태 파일을 복사하고 해시가 같은지 확인 |
| 4 | 임시 Pod를 지우고 Git에 push해 봇을 시작 |
Deployment는 복제본 1개, 배포 전략 Recreate로 두어 업데이트할 때도 새 Pod와 기존 Pod가 동시에 돌지 않게 했습니다. DB는 덤프를 받아 가져온 뒤 양쪽 내용이 같은지 확인했습니다.
3. 전환과 확인
앞단 프록시를 바꾼 뒤에는 공개 주소와 Gateway에 각각 보낸 요청의 응답 상태 코드와 본문 해시를 비교했습니다. VM과 응답이 같아 어느 쪽 응답인지 구분할 수 없는 GPU 계산기는 VM의 컨테이너를 멈춘 뒤에도 정상 응답이 오는지로 확인했습니다. 그 뒤 Docker VM을 삭제했습니다.
4. LMS 구성
| 구성 요소 | 내용 |
| frontend | Next.js 웹 화면 |
| backend | NestJS API, 업로드 처리, 작업 큐 |
| scoreboard | Python 점수판 |
| Redis | backend의 작업 큐(BullMQ) |
| DB | PostgreSQL, VM으로 유지 (다음 글에서 이중화) |
| 트랜스코더 | GPU 패스스루가 필요한 영상 변환 서버, VM으로 유지 |
요구 사항은 노드 하나가 멈춰도 다른 워커에서 계속 동작하는 것이었습니다. 지금 클러스터의 영구 볼륨은 노드 로컬 디스크라, 이를 쓰는 Pod는 노드가 멈추면 다른 노드로 옮겨 가지 못합니다.
5. 영구 볼륨 없애기
그래서 LMS 코드를 보고 각 데이터를 계속 보관해야 하는지 확인했습니다.
| 데이터 | 확인한 내용과 처리 |
| 업로드 폴더 | 처리 중에만 쓰는 임시 파일 → 임시 볼륨(emptyDir) |
| 점수판 상태 파일 | 코드 주석상 캐시, 없으면 처음부터 다시 수집 → 임시 볼륨 |
| Redis 작업 큐 | backend가 시작할 때 DB를 보고 멈춘 작업을 큐에 다시 등록 → backend Pod 안의 보조 컨테이너로 |
Redis는 backend Pod 안의 보조 컨테이너로 넣어 둘이 항상 같은 노드로 함께 옮겨 가게 했습니다. backend는 다른 노드에서 다시 시작되면 DB를 기준으로 작업 큐를 복원하므로, Redis 데이터가 사라져도 작업을 잃지 않습니다.
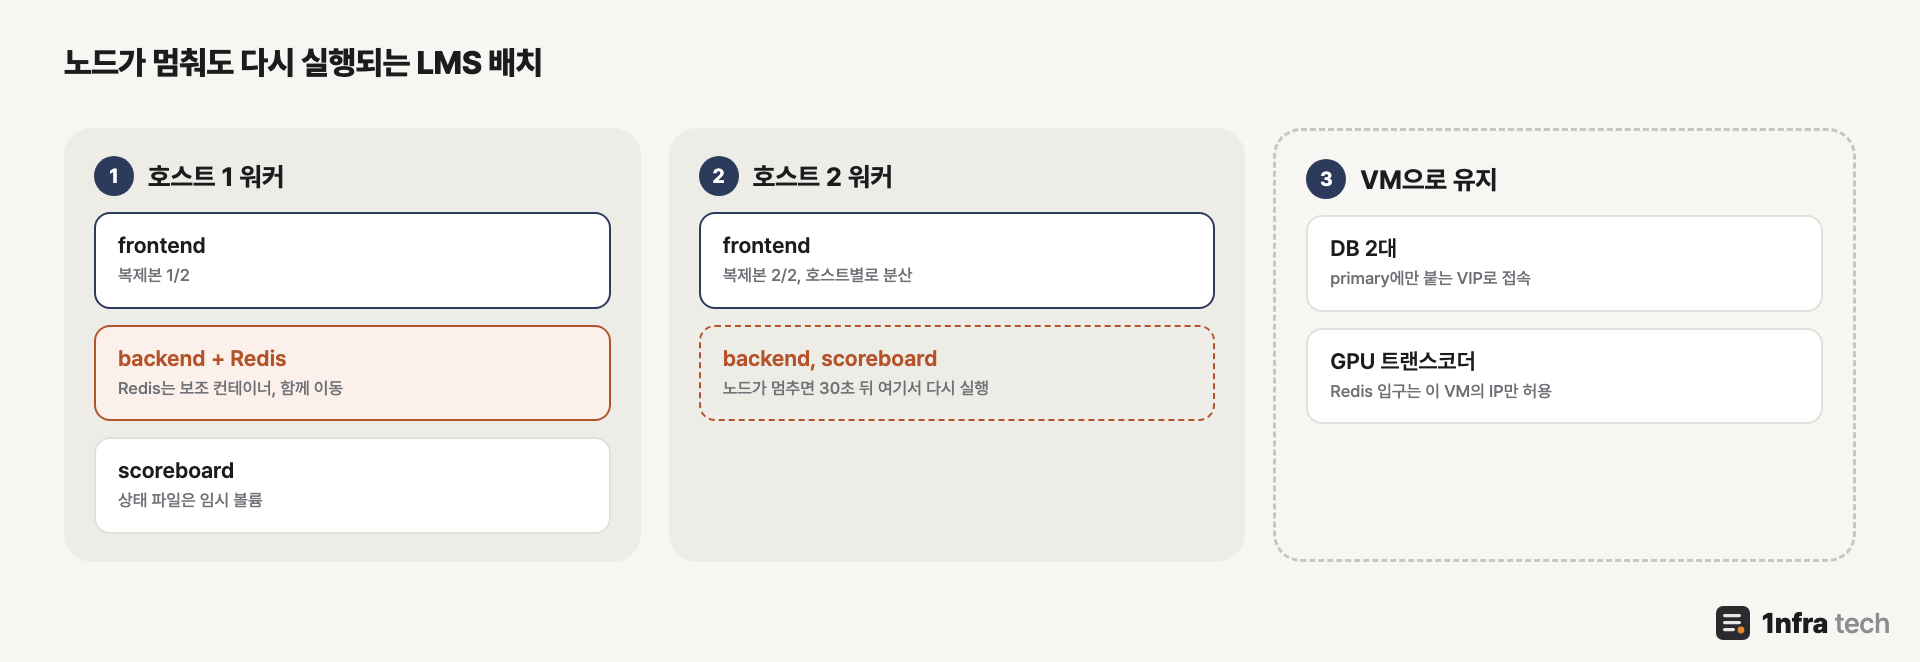
노드 로컬 디스크에 묶이는 영구 볼륨을 없애서, 노드가 멈춰도 Pod가 다른 워커에서 다시 실행됩니다
배치도 노드 장애를 기준으로 정했습니다.
| 설정 | 내용 |
| frontend | 복제본 2개, 두 호스트에 하나씩 퍼지도록 topologySpreadConstraints 사용 |
| backend, scoreboard | 복제본 1개, 노드가 응답하지 않으면 기본 5분 대신 30초 뒤에 다른 노드로 옮김 |
| 트랜스코더용 Redis 접속 주소 | LoadBalancer IP를 따로 주고, 트랜스코더 VM의 IP에서만 접속 허용 |
호스트별 분산에는 워커가 어느 ESXi 호스트에 있는지 나타내는 사용자 정의 라벨을 썼습니다. 표준 zone 라벨을 region 라벨 없이 붙이면 컨트롤러 매니저 지표에 NUL 문자가 섞여 모니터링이 깨질 수 있습니다(6편). 롤링 업데이트 중에는 스케줄러가 이전 버전 Pod까지 세므로 새 Pod가 한 호스트로 몰릴 수 있어, matchLabelKeys에 pod-template-hash를 넣었습니다. Redis 비밀번호는 프로세스 목록에 보이는 실행 인자 대신 Secret에 넣은 설정 파일로 넘깁니다.
6. 업로드가 15초 만에 끊기는 문제
큰 영상을 올리면 504 오류가 났습니다. Cilium Gateway가 내부에서 쓰는 Envoy는 라우트에 시간 제한이 없으면 기본값 15초를 적용합니다. 업로드 후처리가 이보다 길면 끊깁니다. LMS 라우트에만 요청 시간 제한을 1시간으로 늘렸습니다.
7. 약 2초 만에 전환하기
영구 볼륨이 없으므로 LMS를 Kubernetes에 먼저 띄워 VM의 응답과 비교해 검증했습니다.
| 순서 | 내용 |
| 1 | VM의 frontend를 멈추고, 같은 포트에 요청을 클러스터로 넘기는 전달기(socat)를 띄움 |
| 2 | VM의 나머지 컨테이너를 멈춤 (삭제하지 않음) |
| 3 | 트랜스코더가 새 Redis 접속 주소와 DB 주소를 쓰도록 바꾸고 다시 시작 |
| 4 | 앞단 프록시를 클러스터로 바꿈 |
| 5 | 전달기로 들어오는 연결이 없는 것을 확인하고 전달기 삭제 |
서비스는 1번 단계에서 약 2초 동안 멈췄습니다. VM 자리에 전달기를 먼저 두어서, 앞단 프록시를 바꾸는 시점과 상관없이 요청이 클러스터로 갔습니다. 트랜스코더는 나중에 연결했지만, 그사이 올라온 영상은 새 큐에 쌓였다가 트랜스코더가 연결된 뒤 바로 처리되었습니다. backend의 정기 작업은 두 곳에서 잠깐 같이 돌아도 결과가 같습니다.
8. 노드 장애 대비 안전장치
다른 서비스에도 같은 기준으로 안전장치를 더했습니다.
| 안전장치 | 내용 |
| 복제본 분산 | 상태가 없는 정적 사이트와 LMS frontend는 복제본 2개를 두 호스트에 나눠 둠 |
| 빠른 이동 | 복제본이 1개인 서비스는 노드가 응답하지 않으면 30초 뒤 다른 노드로 옮김 |
| 이미지 사전 다운로드 | 내부 이미지를 모든 워커에 미리 받아 두어, 이미지 저장소가 있는 노드가 멈춰도 Pod가 실행됨 |
| PV 회수 정책 | 영구 볼륨을 Retain으로 바꿔 PVC를 지워도 데이터가 남게 함 |
| 백업 | 볼륨 데이터, DB 덤프, 이미지 저장소를 따로 백업 |
| 공유 스토리지 | 상태가 있는 앱은 NAS NFS 볼륨으로 옮겨 어느 워커에서도 실행됨 |
공유 스토리지로 Longhorn도 검토했지만, 지금 쓰는 Kubernetes 1.36.5에서 장애 발생 시 RWO 볼륨을 다른 노드로 옮기는 데 약 6분이 걸리는 알려진 문제가 있어 NAS의 NFS를 골랐습니다. 워커마다 NAS용 내부망 NIC를 붙이고, Pod는 그 망으로 직접 나가지 못하게 네트워크 정책으로 막았습니다.
다음 글에서는 VM으로 남긴 LMS DB를 스트리밍 복제와 VIP로 이중화한 과정을 정리하겠습니다.
9. 정리
- 이미 컨테이너로 돌던 서비스는 VM에서 쓰던 컨테이너 이미지를 그대로 옮기고 digest로 확인했습니다.
- 앱이 직접 고쳐 쓰는 설정 파일은 ConfigMap이 아니라 영구 볼륨에 둡니다.
- 두 곳에서 돌면 안 되는 서비스는 기존 쪽을 먼저 멈추고 데이터를 옮깁니다.
- 각 데이터를 계속 보관해야 하는지 코드로 확인해, 노드 로컬 디스크에 묶이는 영구 볼륨을 없앴습니다.
- Cilium Gateway의 기본 요청 시간 제한은 15초라, 업로드가 오래 걸리면 라우트의 시간 제한을 늘려야 합니다.
- VM 자리에 전달기를 먼저 두어 약 2초 만에 전환했습니다.
- 복제본 분산, 30초 이동, 이미지 사전 다운로드, PV Retain, NAS NFS 볼륨으로 노드 장애에 대비했습니다.
참고
'Project > 홈랩' 카테고리의 다른 글
| [홈랩] PostgreSQL 스트리밍 복제와 VIP로 LMS DB 이중화하기 (8편) (0) | 2026.10.29 |
|---|---|
| [홈랩] Zabbix 5.4를 7.0 LTS로 옮기고 Kubernetes까지 모니터링하기 (6편) (1) | 2026.10.29 |
| [홈랩] PHP 사이트 6개와 MySQL을 옮기고 Gateway 하나로 합치기 (5편) (0) | 2026.10.29 |
| [홈랩] Jenkins와 Argo CD로 홈랩 CI/CD 구성하기 (4편) (0) | 2026.10.29 |
| [홈랩] 웹 서비스 VM을 Kubernetes로 옮기고 검증하기 (3편) (0) | 2026.10.28 |