AI는 사람이 하던 복잡한 판단을 프로그램이나 모델이 대신하게 만드는 기술 전체를 말하고, 그중 규칙을 사람이 짜는 대신 데이터로 학습시키는 방법이 머신러닝입니다. 딥러닝은 층이 여러 개인 신경망을 쓰는 머신러닝이고, 요즘 말하는 생성형 AI와 LLM은 대부분 딥러닝 모델입니다. 인프라 입장에서는 학습과 추론을 나눠서 보는 것이 자원 설계의 출발점입니다.
1. AI란
AI(인공지능, Artificial Intelligence)는 번역이나 영상 판독처럼 사람의 판단이 필요했던 복잡한 작업을 처리하는 프로그램이나 모델을 넓게 가리키는 말입니다. 그래서 사람이 조건문을 직접 짠 규칙 기반 프로그램도 넓은 의미의 AI에 들어가고, 판단 기준을 데이터에서 배우는 머신러닝은 그 안의 한 방법입니다.
| 구분 | 규칙 기반 프로그램 | 머신러닝 모델 |
| 판단 기준 | 사람이 작성한 조건문 | 데이터에서 학습한 파라미터 |
| 예시 | CPU 90% 이상이면 알림, 방화벽 ACL |
스팸 메일 분류, 지표 이상 탐지 |
| 바꾸는 방법 | 규칙과 코드 수정 | 데이터를 바꿔 다시 학습 |
| 강점 | 동작을 예측하고 설명하기 쉬움 | 규칙으로 쓰기 어려운 패턴 처리 |
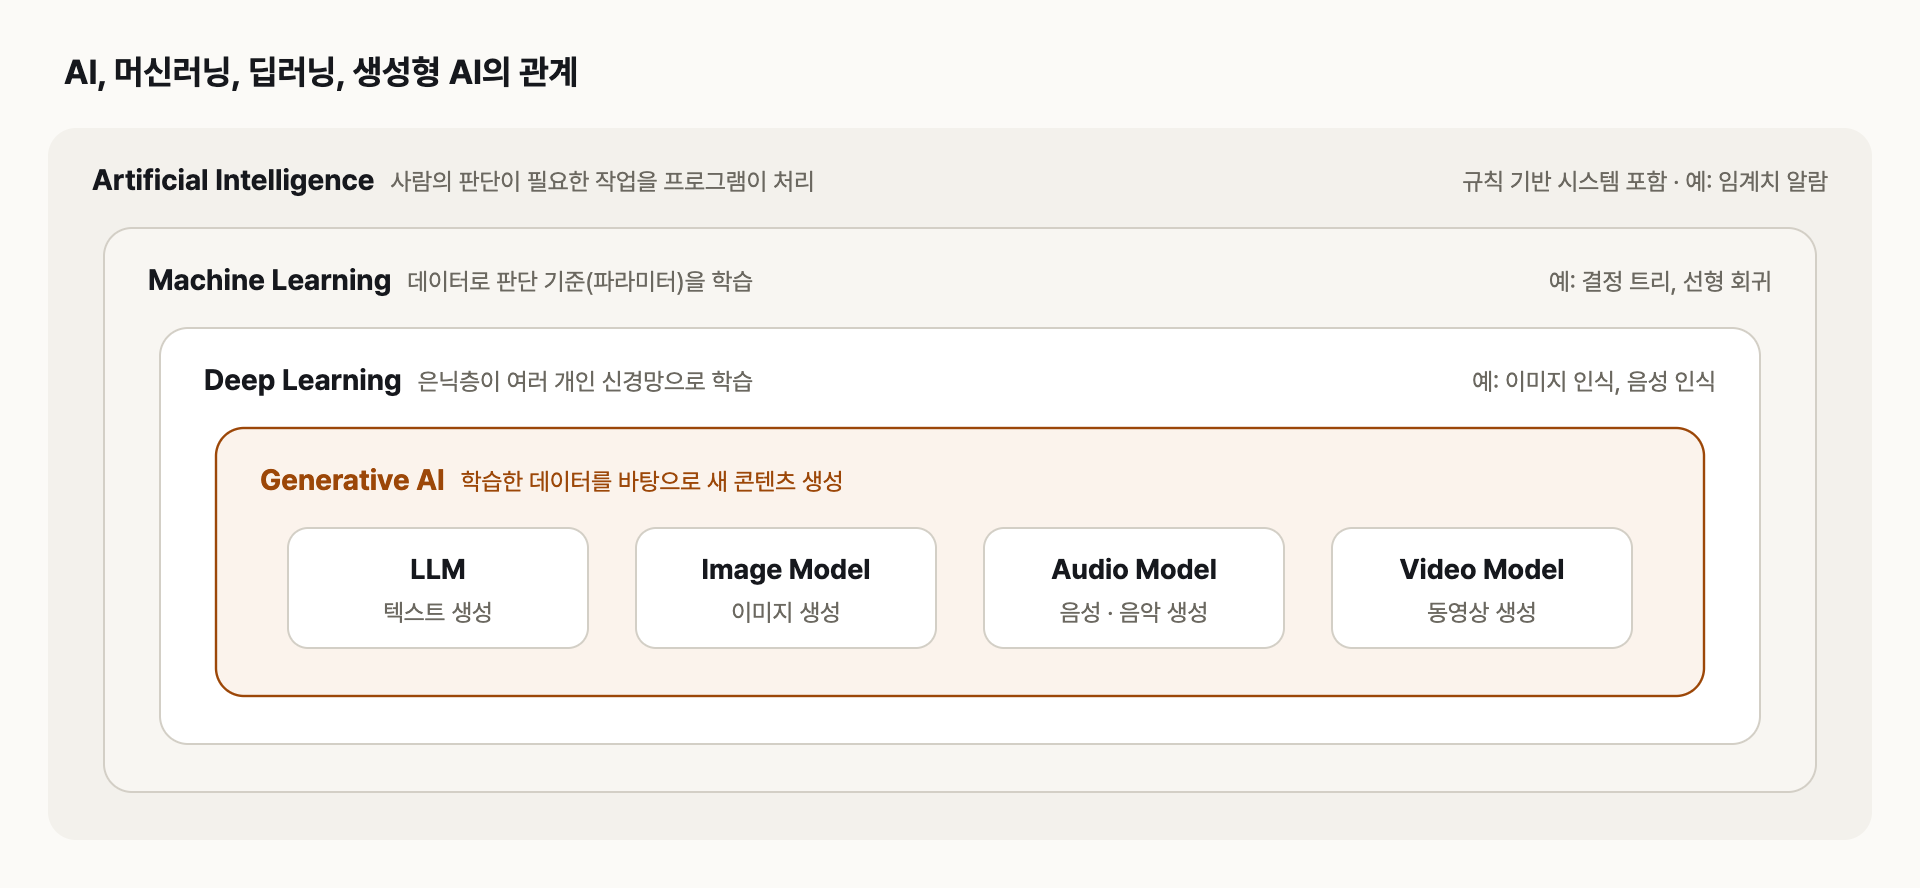
AI, 머신러닝, 딥러닝, 생성형 AI의 포함 관계
네 용어는 바깥에서 안쪽으로 좁아지는 관계입니다. 새 데이터를 만들어 내는 생성 모델 자체는 딥러닝 이전의 확률 모델에도 있었지만, 지금 생성형 AI라고 부르는 LLM과 이미지 생성 모델은 대부분 딥러닝 기반이라 그림처럼 딥러닝 안에 두고 보는 것이 현업 감각에 맞습니다.
2. 머신러닝
머신러닝(Machine Learning)은 입력 데이터로 모델을 학습시키고, 학습된 모델이 처음 보는 데이터에 대해 예측하게 만드는 방식입니다. 서버 장애를 미리 알아채는 모델을 만든다고 가정하면 기본 용어는 다음과 같이 대응됩니다.
| 용어 | 뜻 | 예: 서버 장애 예측 |
| 특성 (feature) |
모델에 넣는 입력 변수 | CPU 사용률, 디스크 I/O, 에러 로그 수 |
| 레이블 (label) |
지도 학습에서의 정답 | 1시간 안에 장애가 났는지 여부 |
| 파라미터 (parameter) |
학습 중에 모델이 스스로 정하는 값 (가중치, 편향) |
각 지표가 장애에 주는 영향의 크기 |
| 하이퍼파라미터 | 학습 전에 사람이 정하는 값 | 학습률, 학습 반복 횟수 |
| 과적합 (overfitting) |
학습 데이터에만 지나치게 맞춰져 새 데이터를 잘못 예측하는 상태 |
특정 서버의 과거 장애만 외운 모델 |
| 추론 (inference) |
학습된 모델로 새 데이터를 예측하는 과정 | 지금 지표로 장애 가능성 계산 |
학습 방식은 데이터에 정답이 있는지, 무엇을 목표로 하는지에 따라 세 가지로 나눕니다.
| 방식 | 데이터 | 학습 목표 | 예 |
| 지도 학습 | 특성 + 레이블 | 입력과 정답의 관계 | 장애 여부 분류, 트래픽 예측 |
| 비지도 학습 | 레이블 없음 | 데이터 안의 패턴과 그룹 | 로그 군집화, 이상 탐지 |
| 강화 학습 | 환경과 보상 | 보상을 가장 크게 만드는 행동 | 게임, 로봇 제어 |

학습 단계에서 파라미터를 정하고, 추론 단계에서는 고정된 모델에 새 입력만 넣어 결과를 얻는 흐름
3. 딥러닝
신경망(neural network)은 입력층과 출력층 사이에 은닉층(hidden layer)을 둔 모델이고, 은닉층이 두 개 이상인 신경망을 심층 신경망이라고 부릅니다. 이 심층 신경망을 쓰는 머신러닝이 딥러닝(Deep Learning)입니다. 각 층은 입력에 가중치를 곱해 더한 값을 다음 층으로 넘기고, 학습은 예측과 정답의 차이가 줄어드는 방향으로 역전파(backpropagation)를 통해 가중치를 조금씩 고치는 과정입니다.
딥러닝에 GPU가 필요한 이유도 여기서 나옵니다. 층마다 하는 계산이 대부분 큰 행렬 곱셈이고, 같은 연산을 수많은 숫자에 동시에 적용하는 일이라 코어가 많은 GPU가 CPU보다 훨씬 유리합니다. 모델이 커질수록 파라미터를 올려 둘 GPU 메모리도 함께 커져야 합니다.
| 구분 | 전통적인 머신러닝 | 딥러닝 |
| 특성 설계 | 사람이 의미 있는 특성을 골라 만듦 | 이미지, 텍스트 같은 원본에서 모델이 특징을 직접 학습 |
| 데이터 양 | 비교적 적어도 동작 | 많을수록 유리 |
| 연산 자원 | CPU로 충분한 경우가 많음 | GPU 같은 가속기 필요 |
| 예 | 결정 트리, 선형 회귀 | 이미지 인식, 음성 인식, LLM |
4. 생성형 AI와 LLM
생성형 AI(Generative AI)는 공식 정의가 정해진 용어는 아니지만, 학습한 데이터를 바탕으로 복잡하고 일관된 새 콘텐츠를 만들어 내는 모델을 가리킵니다. 텍스트를 만드는 LLM(대규모 언어 모델, Large Language Model), 이미지와 음악, 동영상 생성 모델이 모두 여기에 들어갑니다. LLM은 파라미터 수가 매우 많은 언어 모델로, 지금 쓰이는 LLM은 대부분 트랜스포머(Transformer) 구조입니다.
트랜스포머는 2017년 Google 연구진의 논문 "Attention Is All You Need"에서 나온 신경망 구조입니다. 이전의 순환 신경망처럼 단어를 차례로 처리하지 않고, 셀프 어텐션(self-attention)으로 문장 안의 각 토큰이 다른 토큰 중 어디에 주목할지를 한꺼번에 계산합니다. 덕분에 긴 문맥을 잘 잡고 병렬 계산이 쉬워서, 큰 모델을 많은 GPU로 학습시키기에 알맞습니다.
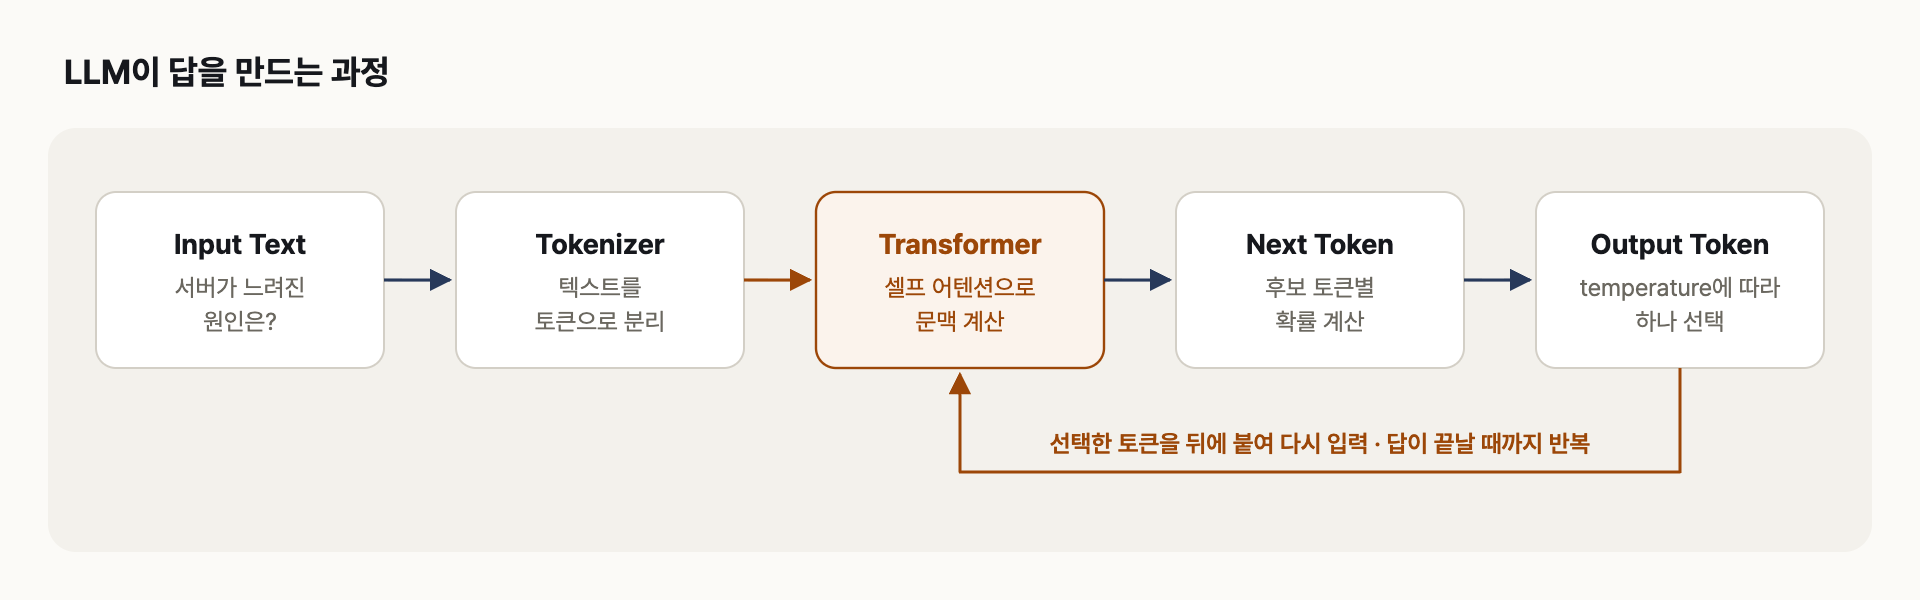
LLM은 지금까지의 토큰을 보고 다음 토큰 하나를 고르는 일을 반복해 답을 만듭니다
LLM은 답 전체를 한 번에 만들지 않습니다. 입력을 토큰(token)으로 나누고, 지금까지의 토큰을 보고 다음에 올 토큰의 확률을 계산해 하나를 고른 뒤, 그 토큰을 붙여 다시 다음 토큰을 예측합니다. temperature는 이 선택을 얼마나 무작위로 할지 정하는 값이고, 컨텍스트 윈도우(context window)는 모델이 한 번에 처리할 수 있는 토큰 수입니다.
| 단계 | 하는 일 | 데이터 |
| 사전 학습 (pre-training) |
방대한 일반 데이터로 다음 토큰 예측을 학습 |
웹 문서, 책, 코드 등 대규모 텍스트 |
| 미세 조정 (fine-tuning) |
특정 작업에 맞게 파라미터를 추가로 학습 |
작업에 맞춘 수백~수천 개 예제 |
| 정렬 (RLHF 등) |
사람의 평가로 답변 품질과 안전성 개선 |
사람이 순위를 매긴 응답 |
정렬 단계의 효과는 2022년 InstructGPT 논문에서 잘 드러났습니다. 사람의 피드백으로 강화 학습(RLHF, Reinforcement Learning from Human Feedback)을 거친 13억 파라미터 모델의 답이 1,750억 파라미터 GPT-3의 답보다 사람 평가에서 더 선호됐습니다. 모델 크기만큼 학습 방식도 답의 품질을 좌우한다는 뜻입니다.
이렇게 방대한 데이터로 사전 학습해 여러 요청에 두루 쓰거나 미세 조정의 출발점으로 삼는 큰 모델을 파운데이션 모델(foundation model)이라고 합니다. 입력이나 출력에 텍스트와 이미지처럼 두 가지 이상의 형식을 다루면 멀티모달(multimodal) 모델이라고 부릅니다.
5. 현업에서 자주 쓰는 용어
| 용어 | 뜻 | 현업에서 볼 때 |
| 프롬프트 (prompt) |
모델이 특정 방식으로 답하도록 주는 입력 텍스트 | 지시, 예시, 역할을 함께 넣어 답의 형식을 조절 |
| 토큰 (token) |
모델이 처리하는 최소 단위 (단어, 하위 단어 등) |
API 요금과 한도가 토큰 단위로 계산됨 |
| 임베딩 (embedding) |
데이터를 의미가 담긴 숫자 배열(벡터)로 바꾼 것 |
의미가 비슷한 문서를 찾는 벡터 검색에 사용 |
| RAG | 답하기 전에 외부 문서를 검색해 근거로 넣는 기법 |
사내 문서 기반 챗봇, 재학습 없이 최신 정보 반영 |
| 파인튜닝 (fine-tuning) |
사전 학습 모델을 특정 작업용으로 추가 학습 |
답의 형식이나 말투 고정, 특정 도메인 작업 |
| 에이전트 (agent) |
사용자 입력을 바탕으로 작업을 계획하고 실행하는 소프트웨어 |
API, 셸 같은 도구 호출까지 맡기는 자동화 |
| 할루시네이션 (hallucination) |
사실처럼 보이지만 틀린 출력 | 근거 문서 제공과 출력 검증 절차가 필요 |
| temperature | 출력의 무작위성을 정하는 값 | 낮으면 일정한 답, 높으면 다양한 답 |
저는 답이 기대와 다를 때 모델을 바꾸거나 파인튜닝하기 전에 프롬프트와 RAG부터 손보는 편이 낫다고 봅니다. 파인튜닝은 학습 데이터를 준비하고 다시 학습하는 비용이 들고, 기반 모델을 바꾸면 그 작업을 반복해야 하기 때문입니다.
6. 인프라 관점: 학습과 추론
같은 모델이라도 학습과 추론은 필요한 자원과 운영 방식이 완전히 다릅니다.
| 구분 | 학습(training) | 추론(inference) |
| 하는 일 | 데이터로 파라미터를 계산하고 수정 | 고정된 파라미터로 결과만 계산 |
| 실행 형태 | 일정 기간 돌아가는 배치 작업 | 요청마다 응답하는 상시 서비스 (대량 처리용 배치 추론도 있음) |
| 주요 자원 | 여러 GPU, 큰 GPU 메모리, 빠른 GPU 간 네트워크와 스토리지 |
모델을 올릴 GPU 메모리, 동시 요청을 처리할 처리량 |
| 중요 지표 | 학습 완료 시간, GPU 사용률 | 응답 지연 시간, 초당 처리 토큰 수 |
| 비용 구조 | 한 번에 크게 드는 비용 | 사용량에 비례해 계속 드는 비용 |
대부분의 회사는 모델을 직접 학습하기보다 클라우드 API나 공개 모델로 추론만 운영합니다. 그래서 인프라 엔지니어가 먼저 챙길 것은 추론 쪽의 지연 시간, 처리량, 비용, 그리고 네트워크 격리입니다. Azure에서 모델을 사설망으로만 호출하는 구성은 Microsoft Foundry 구성과 Private Link 정리에서 다뤘습니다.
7. 정리
- AI ⊃ 머신러닝 ⊃ 딥러닝 ⊃ 생성형 AI 순서로 좁아지며, 머신러닝은 규칙 대신 데이터로 판단 기준을 학습합니다.
- LLM은 트랜스포머 기반 딥러닝 모델로, 사전 학습, 미세 조정, 정렬을 거쳐 다음 토큰을 반복 예측해 답을 만듭니다.
- 인프라에서는 학습과 추론을 나눠 보고, 대부분의 조직에서는 추론의 지연 시간, 처리량, 비용, 네트워크 격리를 먼저 설계합니다.
참고
