RAG는 질문과 관련된 문서를 먼저 검색해 프롬프트에 넣고, 모델이 그 내용을 근거로 답하게 하는 방식입니다. 모델을 다시 학습시키지 않아도 사내 문서처럼 모델이 모르는 정보를 답에 반영할 수 있습니다. 문서를 청크로 나눠 임베딩으로 바꾸고 벡터 DB에 저장하는 색인 단계와, 질문이 들어오면 비슷한 청크를 찾아 모델에 넘기는 질의 단계로 나뉩니다. 모델은 검색된 청크만 볼 수 있으므로, 사내 문서 챗봇의 답 품질과 보안은 수집, 검색, 권한 처리를 맡는 인프라 부품에서 크게 갈립니다.
1. RAG가 필요한 이유
LLM은 학습 데이터에 있던 내용만 알고, 사내 위키나 런북, 지난주 장애 보고서는 알지 못합니다. 이런 정보를 답에 반영하는 방법은 크게 세 가지입니다. 문서를 매번 프롬프트에 직접 붙이는 방법, 필요한 부분만 검색해서 붙이는 방법(RAG), 모델 자체를 추가로 학습시키는 방법(파인튜닝)입니다. 세 방법의 선택 기준은 별도 글에서 다루고, 이 글은 RAG에 집중합니다.
Microsoft Learn은 RAG를 자체 콘텐츠에 응답을 근거(grounding)시켜 LLM의 능력을 확장하는 패턴으로 정의하고, 모델을 재학습하지 않는다는 점을 장점으로 듭니다. 문서가 바뀌면 색인만 다시 만들면 되므로, 자주 바뀌는 운영 문서에 잘 맞습니다.
문서를 통째로 프롬프트에 넣는 방법도 있지만, LLM 토큰과 컨텍스트 윈도우 개념 정리에서 정리했듯이 입력이 길수록 매 요청의 비용이 늘고, 첫 응답이 늦어지고, 중간에 있는 내용을 놓치기 쉬워집니다. 반대로 Anthropic은 지식 베이스가 20만 토큰(약 500페이지) 이하라면 전체를 프롬프트에 넣고 프롬프트 캐싱을 쓰는 방법도 가능하다고 안내합니다. 그래서 저는 문서 양이 적으면 전체 넣기로 먼저 시작하고, 문서가 계속 늘어나는 경우에 RAG를 검토합니다.
| 항목 | 문서 전체 넣기 | RAG |
| 맞는 규모 | 소량 문서 | 대량, 계속 늘어나는 문서 |
| 준비 작업 | 거의 없음 | 청킹, 임베딩, 색인 파이프라인 |
| 요청당 입력 | 문서 전체 | 검색된 청크 몇 개 |
| 주요 실패 | 긴 입력으로 정확도 저하 | 필요한 청크를 못 찾으면 답도 틀림 |
2. RAG의 두 단계 흐름
RAG는 미리 해 두는 색인(Indexing) 단계와, 질문마다 실행하는 질의(Query) 단계로 나뉩니다. 색인 단계는 배치 작업처럼 주기적으로 돌고, 질의 단계는 사용자 요청마다 실시간으로 돕니다.
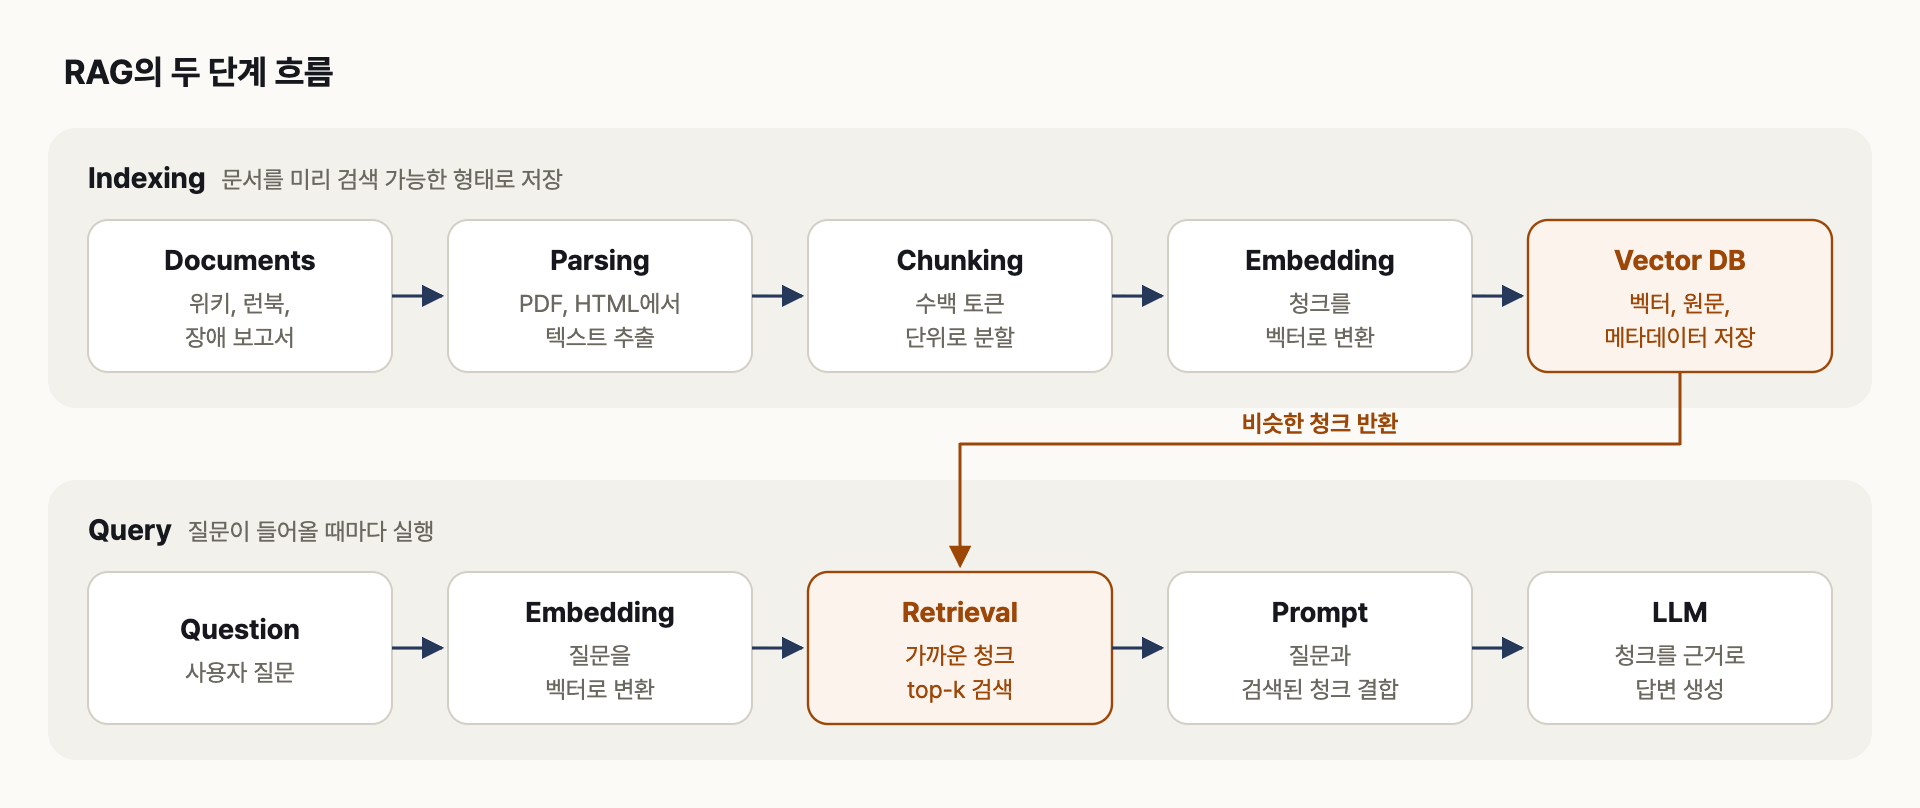
색인 단계에서 만든 벡터 DB를 질의 단계의 검색이 사용합니다
| 단계 | 하는 일 |
| 수집, 파싱 | 위키, 저장소, 파일 서버에서 문서를 가져와 텍스트를 추출 |
| 청킹 | 문서를 검색 단위인 청크로 분할 |
| 임베딩, 저장 | 청크를 벡터로 바꿔 원문, 메타데이터와 함께 벡터 DB에 저장 |
| 질문 임베딩 | 사용자 질문을 같은 임베딩 모델로 벡터로 변환 |
| 검색 | 질문 벡터와 가까운 청크를 상위 k개(top-k) 조회 |
| 생성 | 질문과 청크를 프롬프트로 묶어 LLM이 답변 |
핵심은 모델이 문서를 기억하는 것이 아니라, 매 요청 검색된 청크를 입력으로 받는다는 점입니다. 그래서 검색이 필요한 청크를 놓치면 모델이 아무리 좋아도 답이 틀리고, 청크를 많이 넣을수록 입력 토큰이 늘어 비용과 응답 시간이 함께 늘어납니다. 마지막 단계에서 만들어지는 프롬프트는 대략 다음과 같습니다.
다음 문서 내용만 근거로 질문에 답하고, 근거가 된 문서 경로를 함께 적어 주세요.
문서에 없는 내용이면 모른다고 답하세요.

<documents>
[1] runbook/nginx-502.md
Nginx가 502를 반환하면 upstream 프로세스가 살아 있는지와 포트가 열려 있는지
먼저 확인합니다.
[2] runbook/db-pool.md
DB 커넥션 풀이 가득 차면 애플리케이션이 응답하지 않으므로 max_connections와
풀 크기를 함께 조정합니다.
</documents>

질문: 배포 직후 웹 서버가 502를 반환합니다. 무엇부터 확인해야 하나요?
문서 경로를 함께 넣으면 답에 출처를 표시할 수 있어 사용자가 원문을 직접 확인할 수 있습니다. "문서에 없으면 모른다고 답하라"는 지시는 검색이 실패했을 때 모델이 그럴듯한 답을 지어내는 것을 줄이기 위해 넣습니다.
3. 청킹: 문서를 검색 단위로 나누기
문서를 청크로 나누는 이유는 세 가지입니다. 임베딩 모델마다 입력 한도가 있고(OpenAI text-embedding-3 계열은 8,192토큰), 긴 문서 하나를 벡터 하나로 만들면 여러 주제가 섞여 특정 질문과의 거리가 흐려지며, 필요한 부분만 넣어야 입력 토큰을 아낄 수 있기 때문입니다. Anthropic은 보통 수백 토큰 이하로 나눈다고 설명합니다.
문제는 잘린 청크가 앞뒤 맥락을 잃는다는 점입니다. 예를 들어 런북의 "3단계: 서비스를 재시작한 뒤 헬스 체크가 통과하는지 확인합니다"라는 청크만 보면 어떤 서비스의 어떤 장애 절차인지 알 수 없어, 관련 질문에도 검색되지 않거나 엉뚱한 질문에 검색될 수 있습니다. 그래서 청크를 나눌 때 다음을 함께 고려합니다.
| 방법 | 이유 |
| 구조 기준 분할 | 제목, 문단, 코드 블록 경계에서 나눠 절차나 명령이 중간에 잘리지 않게 함 |
| 청크 겹침 | 앞뒤 청크를 일부 겹쳐(overlap) 경계에 걸린 문장을 보존 |
| 메타데이터 저장 | 문서 경로, 제목, 부서, 수정일을 함께 저장해 출처 표시, 권한 필터, 최신 문서 우선에 사용 |
| 맥락 문장 추가 | 청크 앞에 문서 제목이나 짧은 설명을 붙여 청크만으로도 무엇에 관한 내용인지 드러나게 함 |
마지막 방법은 Anthropic이 Contextual Retrieval이라는 이름으로 공개한 방식입니다. 모델로 청크마다 50~100토큰 정도의 맥락 설명을 만들어 청크 앞에 붙인 뒤 임베딩했더니, 상위 20개 청크 안에 정답 청크가 없는 검색 실패율이 5.7%에서 3.7%로 35% 줄었다고 발표했습니다.
4. 임베딩
OpenAI 문서는 임베딩을 부동소수점 숫자의 목록(벡터)이고, 두 벡터 사이의 거리가 관련성을 나타낸다고 설명합니다. 거리가 가까우면 의미가 비슷하고, 멀면 관련이 적다는 뜻입니다. 단어가 겹치지 않아도 뜻이 비슷하면 가까워지기 때문에, "게이트웨이 오류가 나요"라는 질문으로 "Nginx 502 Bad Gateway" 문서를 찾을 수 있습니다.
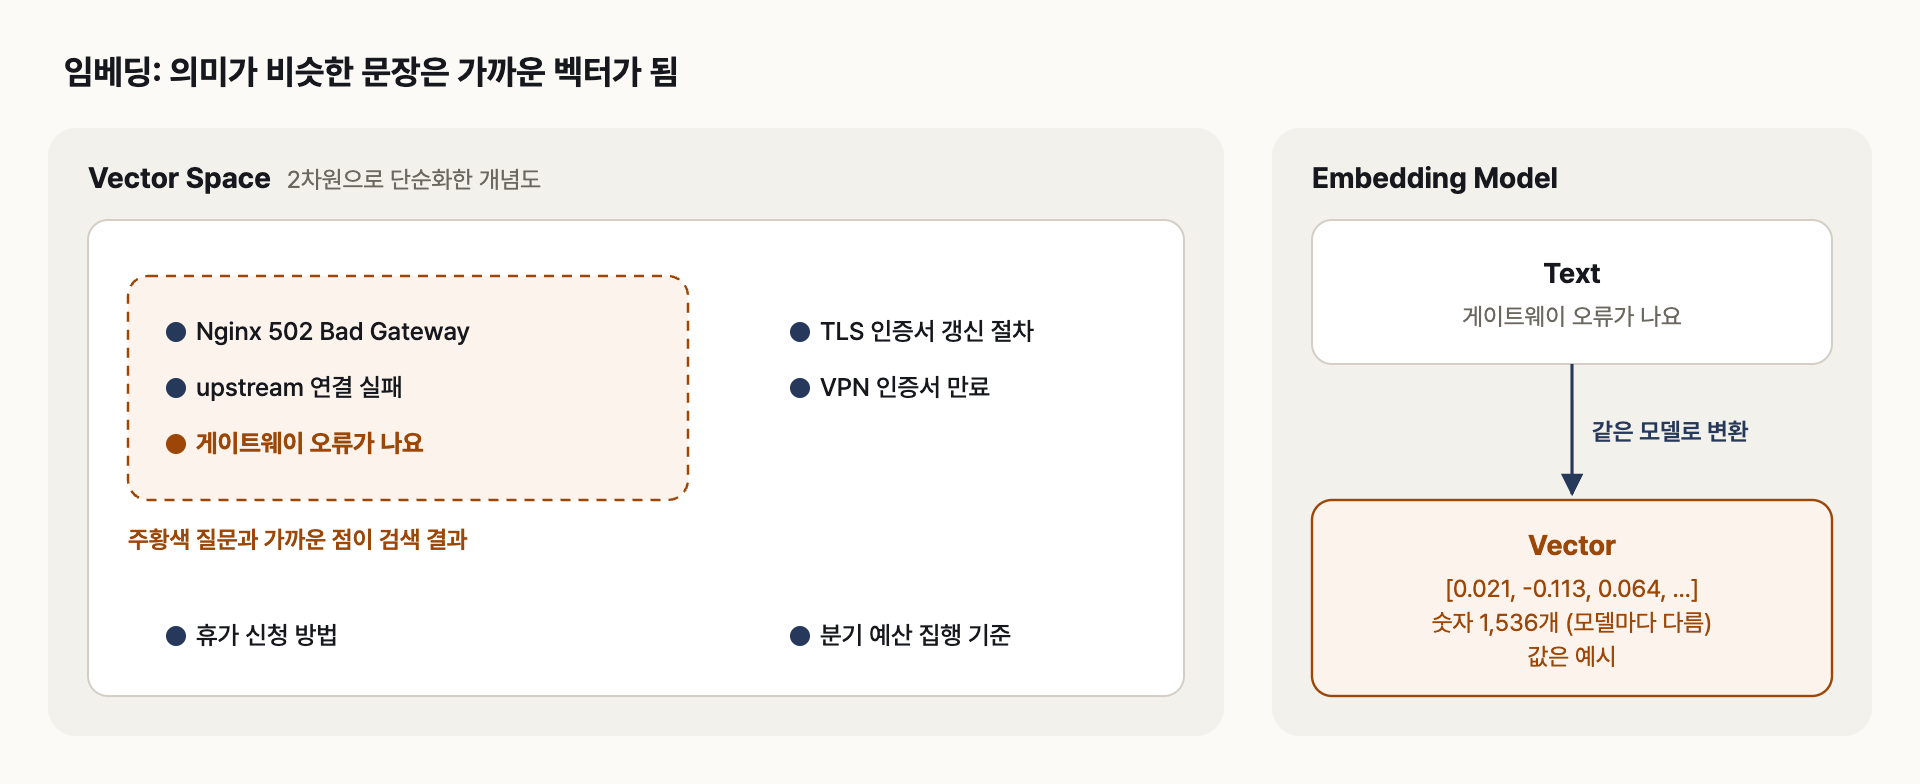
실제 벡터는 수백에서 수천 차원이며, 그림은 개념을 설명하기 위해 2차원으로 단순화했습니다
OpenAI의 text-embedding-3-small은 기본 1,536차원, text-embedding-3-large는 기본 3,072차원 벡터를 만들고, dimensions 파라미터로 차원을 줄일 수도 있습니다. 거리 계산은 코사인 유사도를 권장하며, 이 모델들의 벡터는 길이가 1로 정규화되어 있어 내적으로 더 빠르게 계산해도 순위가 같습니다. 운영 관점에서 확인할 점은 다음과 같습니다.
| 항목 | 이유 |
| 같은 모델 사용 | 모델마다 벡터 공간이 달라, 문서와 질문을 다른 모델로 변환하면 거리 비교가 의미 없음 |
| 모델 교체는 전체 재색인 | 기존 벡터를 재사용할 수 없어 문서 전체를 다시 임베딩해야 하고, 그동안 이전 색인과 새 색인을 함께 운영해야 함 |
| 차원 수는 저장 공간 | float32 기준 1,536차원 벡터 하나가 6,144바이트이므로 청크 100만 개면 벡터만 약 6GB, 인덱스는 별도 |
| 다국어 성능 | 한국어 문서와 질문이 많다면 한국어 검색 품질을 직접 확인한 모델을 사용 |
임베딩 비용 자체는 생성 모델보다 훨씬 작습니다. OpenAI 문서는 text-embedding-3-small로 1달러에 약 62,500페이지(페이지당 800토큰 가정)를 임베딩할 수 있다고 예시합니다. 그래서 비용보다는 재색인에 걸리는 시간과, 외부 API로 사내 문서를 보내도 되는지가 더 중요한 판단 기준이 됩니다.
5. 벡터 DB와 검색
벡터 DB는 벡터와 원문, 메타데이터를 저장하고, 질문 벡터와 가까운 벡터를 빠르게 찾아 줍니다. 모든 벡터와 거리를 하나씩 계산하는 정확한 검색은 데이터가 늘수록 느려지므로, 보통 근사 최근접 이웃(ANN) 인덱스를 씁니다. pgvector 문서는 기본 검색이 정확한 최근접 이웃 검색이고, 인덱스를 추가하면 재현율(recall)을 일부 포기하는 대신 속도를 얻는다고 설명합니다.
| 인덱스 | 특징 |
| HNSW | 여러 층의 그래프 구조, 속도와 재현율의 균형이 더 좋지만 빌드가 느리고 메모리를 더 사용, 데이터 없이도 생성 가능 |
| IVFFlat | 벡터를 여러 목록으로 나눔, 빌드가 빠르고 메모리를 덜 쓰지만 검색 성능은 HNSW보다 낮음, 데이터를 넣은 뒤에 생성해야 함 |
벡터 DB는 PostgreSQL의 pgvector처럼 기존 DB에 확장을 설치하는 방식, OpenSearch나 Elasticsearch의 벡터 검색 기능을 쓰는 방식, Azure AI Search 같은 관리형 검색 서비스, Milvus나 Qdrant 같은 전용 벡터 DB로 나눌 수 있습니다. 저는 사내에 PostgreSQL 운영 경험이 있고 규모가 크지 않다면 pgvector로 시작하는 편을 권합니다. 백업, 접근 제어, 모니터링을 기존 체계 그대로 쓸 수 있고, 권한 필터를 일반 SQL 조건으로 걸 수 있기 때문입니다.
아래는 PostgreSQL 16과 pgvector에서 직접 실행한 예시입니다. 동작을 보여 주기 위해 3차원 벡터를 직접 넣었고, 실제로는 임베딩 모델이 만든 벡터를 넣습니다.
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE doc_chunks (
  id        bigserial PRIMARY KEY,
  source    text NOT NULL,          -- 원본 문서 경로
  dept      text NOT NULL,          -- 접근 권한 판단용 메타데이터
  content   text NOT NULL,          -- 청크 원문
  embedding vector(3) NOT NULL      -- 실제로는 임베딩 모델 차원 (예: 1536)
);

INSERT INTO doc_chunks (source, dept, content, embedding) VALUES
 ('runbook/nginx-502.md', 'infra', 'upstream 프로세스와 포트 확인', '[0.9, 0.1, 0.1]'),
 ('runbook/db-pool.md',   'infra', '커넥션 풀과 max_connections 조정', '[0.7, 0.4, 0.1]'),
 ('it/vpn-cert.md',       'it',    'VPN 인증서 재발급 절차', '[0.2, 0.9, 0.1]'),
 ('finance/budget.md',    'finance', '분기 예산 집행 기준', '[0.1, 0.1, 0.9]');

CREATE INDEX ON doc_chunks USING hnsw (embedding vector_cosine_ops);

-- 질문 벡터와 코사인 거리가 가까운 순서로 3개, 권한 있는 부서 문서만
SELECT source, round((embedding <=> '[0.8, 0.2, 0.1]')::numeric, 3) AS distance
FROM doc_chunks
WHERE dept = ANY (ARRAY['infra', 'it'])
ORDER BY embedding <=> '[0.8, 0.2, 0.1]'
LIMIT 3;
source | distance
----------------------+----------
runbook/nginx-502.md | 0.009
runbook/db-pool.md | 0.037
it/vpn-cert.md | 0.546
(3 rows)<=>는 코사인 거리 연산자로, 0에 가까울수록 방향이 같은 벡터입니다. finance 부서 문서는 WHERE 조건으로 검색 대상에서 빠졌습니다. 이처럼 권한 필터를 검색 쿼리에 넣는 것이 사내 챗봇에서 가장 중요한 부분이며, 8장에서 다시 다룹니다.
차원 수와 관련해 실제로 겪기 쉬운 제약도 있습니다. pgvector의 vector 타입은 인덱스를 만들 수 있는 차원이 2,000까지라서, text-embedding-3-large의 기본 3,072차원 벡터에 HNSW 인덱스를 만들면 다음 오류가 납니다.
ERROR: column cannot have more than 2000 dimensions for hnsw indexpgvector 문서 기준으로 halfvec 타입은 4,000차원까지 인덱스를 지원하므로, 새 버전의 halfvec을 쓰거나 임베딩 API의 dimensions 파라미터로 차원을 줄여서 해결합니다. 모델을 고를 때 벡터 DB의 차원 제한을 함께 확인해야 하는 이유입니다.
6. 하이브리드 검색과 재순위
임베딩 검색은 뜻이 비슷한 문장을 잘 찾지만, 오류 코드, 호스트명, 버전 번호처럼 글자가 정확히 일치해야 하는 검색에는 약합니다. Anthropic은 오류 코드 예시를 들어, 이런 경우 BM25 같은 키워드 기반 검색이 정확한 단어 일치를 잘 찾는다고 설명합니다. 운영 문서에는 이런 식별자가 많아서, 저는 벡터 검색만 쓰기보다 키워드 검색을 함께 쓰는 하이브리드 검색을 기본으로 둡니다. Microsoft Learn도 재현율을 높이기 위해 키워드 검색과 벡터 검색을 함께 쓰는 하이브리드 쿼리를 권장합니다.
재순위(reranking)는 1차 검색으로 후보를 넉넉히 가져온 뒤, 질문과 각 청크의 관련성을 다시 평가해 상위 몇 개만 남기는 단계입니다. Anthropic의 실험에서는 후보 150개를 가져와 재순위 후 20개를 모델에 넘겼습니다. 같은 글에서 발표한 검색 실패율은 다음과 같습니다.
| 방법 | 상위 20개 검색 실패율 |
| 기본 임베딩 검색 | 5.7% |
| 맥락을 붙인 임베딩 | 3.7% 35% 감소 |
| 위 방법 + 맥락을 붙인 BM25 | 2.9% 49% 감소 |
| 위 방법 + 재순위 | 1.9% 67% 감소 |
이 수치는 Anthropic이 사용한 데이터셋 기준이므로 사내 문서에서도 같은 폭으로 좋아진다고 볼 수는 없습니다. 다만 키워드 검색과 재순위를 더할수록 검색 실패가 줄어드는 방향은 일관되므로, 자주 묻는 질문 수십 개로 평가 세트를 만들어 단계별로 효과를 확인하는 방법을 권합니다.
7. 사내 문서 챗봇을 이루는 인프라 구성
사내 문서 챗봇은 모델 하나가 아니라 여러 서버와 작업으로 이루어집니다. 크게 문서를 모아 색인하는 수집(Ingestion) 영역과, 사용자 질문을 처리하는 서빙(Serving) 영역으로 나뉩니다.
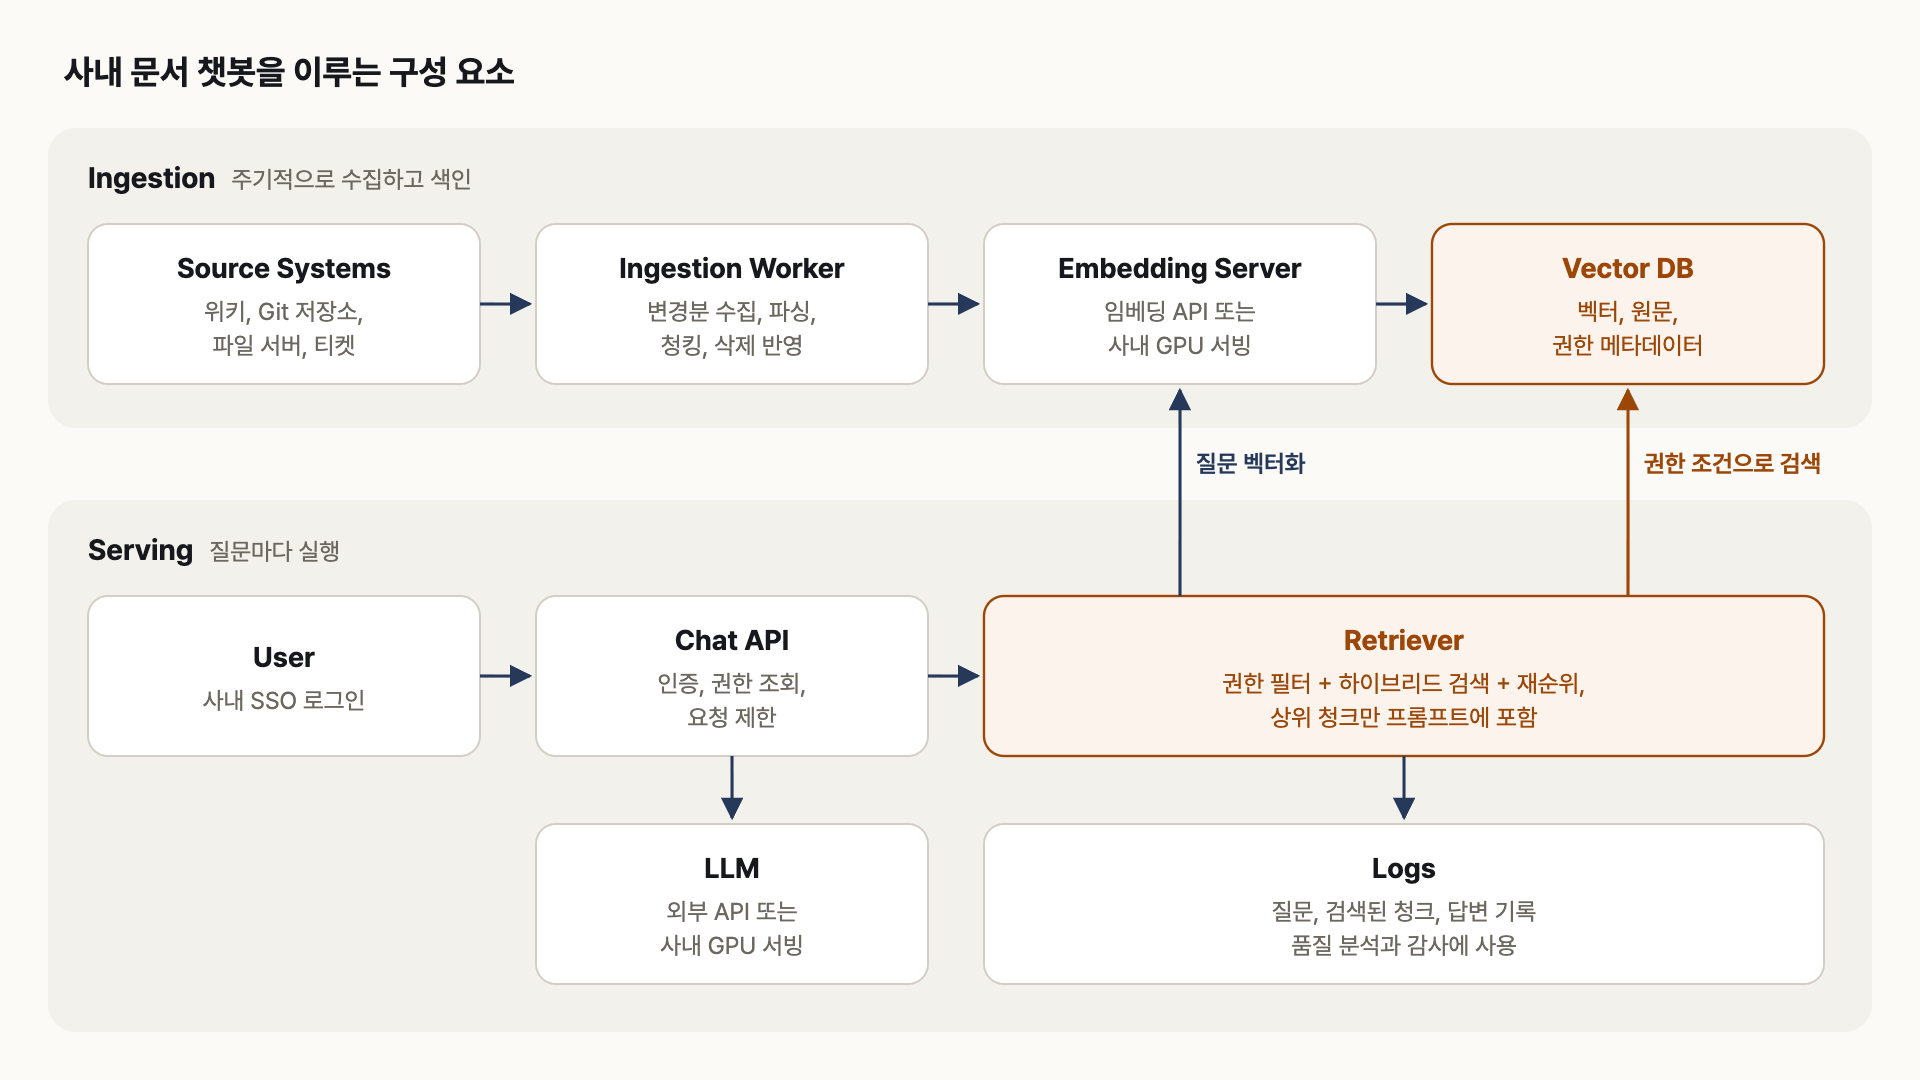
검색은 사용자의 권한 조건과 함께 실행되고, 질문과 검색 결과, 답변은 로그로 남깁니다
| 구성 요소 | 역할과 운영 시 확인할 점 |
| Source Systems | 위키, Git 저장소, 파일 서버, 티켓 시스템, 수집 API의 호출 제한과 수집 계정의 권한 범위 |
| Ingestion Worker | 변경된 문서만 다시 색인하고 삭제된 문서를 색인에서 제거, 삭제가 반영되지 않으면 폐기된 절차로 답함 |
| Embedding Server | 외부 API라면 사내 문서 반출 정책, 사내 서빙이라면 GPU 서버와 배치 처리량 |
| Vector DB | HNSW 인덱스 메모리, 백업과 복구, 재색인 시 인덱스 재구축 시간 |
| Chat API | SSO 인증, 사용자 권한 조회, 요청 수 제한, 타임아웃 |
| Retriever | 권한 필터, 하이브리드 검색, 재순위, 프롬프트에 넣을 청크 수 |
| LLM | 외부 API 또는 사내 GPU 서빙, 컨텍스트 윈도우와 토큰 비용 |
| Logs | 질문, 검색된 청크, 답변을 기록해 품질 분석에 사용, 민감 정보가 담기므로 보관 기간과 접근 권한 관리 |
임베딩과 LLM을 사내 GPU로 서빙할지 외부 API를 쓸지는 문서 반출 정책과 비용에 따라 갈립니다. 사내 서빙을 검토한다면 GPU 개념 글에서 정리한 GPU 메모리와 대역폭 개념이 서버 사양을 정하는 기준이 됩니다.
8. 권한과 보안
사내 문서 챗봇에서 가장 흔한 사고는 권한이 없는 사람이 챗봇을 통해 문서 내용을 보게 되는 경우입니다. 원본 시스템에서는 인사팀만 볼 수 있는 문서라도, 한 계정으로 모두 수집해 하나의 벡터 DB에 넣으면 누구의 질문에든 검색될 수 있습니다.
그래서 권한은 프롬프트가 아니라 검색 단계에서 걸러야 합니다. "이 사용자는 재무 문서를 보면 안 된다"는 지시를 프롬프트에 넣어도 모델은 이미 그 청크를 입력으로 받았으므로, 프롬프트 인젝션이나 모델의 실수로 내용이 노출될 수 있습니다. Microsoft Learn도 RAG 구성 요소로 문서 단위 보안 트리밍(security trimming)과 쿼리 시점의 필터 기반 보안을 제시합니다. OWASP LLM Top 10 2025의 LLM08(Vector and Embedding Weaknesses) 항목이 정리한 위험과 대응은 다음과 같습니다.
| 위험 | 대응 |
| 권한 없는 접근 | 청크에 원본 문서의 권한 정보를 저장하고, 검색 쿼리에 사용자 권한 조건을 적용 |
| 조직 간 정보 유출 | 여러 부서나 고객사 데이터를 한 저장소에 둘 때 논리적 분리와 필터를 적용 |
| 임베딩 역변환 | 벡터에서 원문 정보를 상당 부분 복원할 수 있으므로 벡터도 원문과 같은 수준으로 보호 |
| 데이터 오염 | 검증된 출처의 문서만 수집하고, 누가 어떤 문서를 추가했는지 기록 |
생성형 AI를 업무에 쓸 때의 입력 데이터 관리와 권한 문제는 생성형 AI 업무 활용 시 보안 주의점 정리에서 더 자세히 다루었습니다.
9. 답이 틀릴 때 확인하는 순서
RAG 챗봇이 틀린 답을 하면 저는 모델보다 검색 로그를 먼저 봅니다. 모델은 검색된 청크만 볼 수 있으므로, 필요한 청크가 검색되지 않았다면 프롬프트나 모델을 바꿔도 해결되지 않기 때문입니다.
| 증상 | 확인할 곳 |
| 문서에 있는데 모른다고 답함 | 해당 청크가 top-k에 있었는지 확인, 없으면 청킹, 임베딩 모델, 하이브리드 검색 점검 |
| 청크는 검색됐는데 답이 틀림 | 프롬프트 지시, 청크 순서, 너무 많은 청크로 인한 정확도 저하 점검 |
| 예전 절차로 답함 | 색인 동기화 주기, 삭제 반영 여부, 수정일 메타데이터 점검 |
| 오류 코드나 호스트명 질문에 엉뚱한 답 | 키워드 검색이 빠져 있는지 확인 |
| 권한 밖 문서 내용이 나옴 | 즉시 해당 청크를 색인에서 제외하고, 수집 계정 권한과 검색 필터 점검 |
10. 정리
- RAG는 질문과 관련된 문서를 검색해 프롬프트에 넣는 방식이며, 모델 재학습 없이 사내 문서를 답에 반영합니다.
- 색인 단계는 수집, 파싱, 청킹, 임베딩, 저장이고, 질의 단계는 질문 임베딩, 검색, 프롬프트 구성, 생성입니다.
- 임베딩은 의미를 벡터로 바꾼 것이고, 문서와 질문은 같은 모델로 변환해야 하며, 모델을 바꾸면 전체 재색인이 필요합니다.
- 운영 문서에는 오류 코드 같은 식별자가 많으므로 키워드 검색을 함께 쓰는 하이브리드 검색과 재순위를 고려합니다.
- 권한 필터는 프롬프트가 아니라 검색 쿼리에 걸고, 벡터와 로그도 원문과 같은 수준으로 보호합니다.
참고
'AI > 개념' 카테고리의 다른 글
| [AI] 프롬프트, RAG, 파인튜닝 선택 기준 정리 (0) | 2026.09.26 |
|---|---|
| [AI] AI 에이전트와 MCP 개념 정리 (0) | 2026.09.26 |
| [AI] LLM 토큰과 컨텍스트 윈도우 개념 정리 (0) | 2026.09.26 |
| [AI] 머신러닝, 딥러닝, 생성형 AI 개념 정리 (0) | 2026.09.25 |
