LLM은 글자가 아니라 토큰 단위로 입력을 읽고 출력을 만들며, 요금과 한도도 모두 토큰으로 계산합니다. 긴 입력은 첫 응답을 늦추고, 긴 출력은 전체 응답 시간을 늘립니다. 컨텍스트 윈도우는 모델이 한 번에 볼 수 있는 토큰 한도인데, 한도 안에 들어가더라도 입력이 길수록 정보를 찾아내는 정확도가 떨어지고 중간에 있는 내용을 놓치기 쉽습니다. 그래서 긴 로그는 통째로 넣기보다 필요한 구간을 잘라 집계한 뒤 넣는 편이 비용과 정확도 모두에 유리합니다.
1. 토큰이란
토큰은 모델이 텍스트를 처리하는 단위입니다. OpenAI 도움말은 토큰이 글자 하나일 수도, 단어의 일부나 단어 전체, 문장 부호일 수도 있고, 같은 텍스트라도 모델과 언어에 따라 토큰 수가 달라진다고 설명합니다. 모델에 텍스트를 보내면 토크나이저가 텍스트를 토큰으로 나눠 숫자(토큰 ID)로 바꾸고, 모델은 다음 토큰을 하나씩 예측해 출력한 뒤 다시 글자로 되돌립니다.
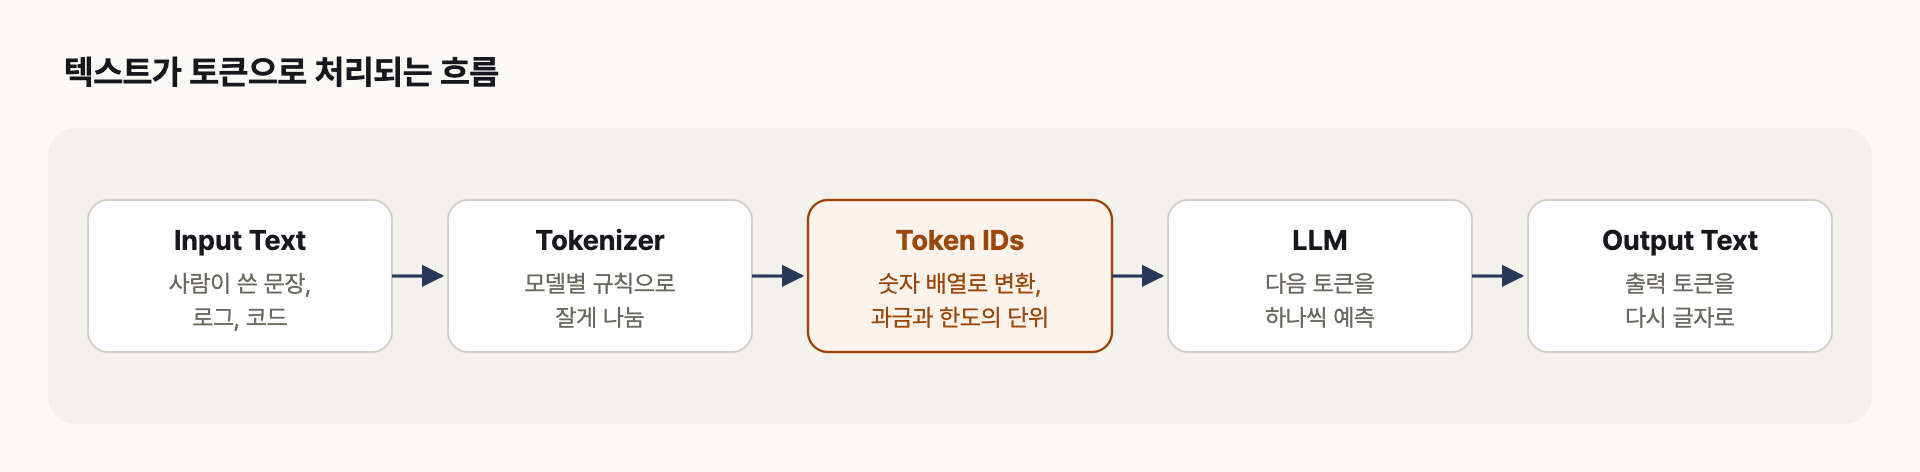
모델이 보는 것은 글자가 아니라 토큰 ID 배열이고, 과금과 한도도 이 단위로 계산합니다
영어는 "토큰 1개가 약 4글자, 100토큰이 약 75단어"라는 어림값이 널리 쓰이지만, 한국어나 로그는 이 비율이 맞지 않습니다. 같은 뜻의 문장과 실제 로그를 OpenAI Tokenizer(GPT-5.x 인코딩)로 직접 세어 보면 다음과 같습니다.
| 입력 | 글자 수 | 토큰 수 |
| 영어 문장 (502 에러 설명 한 줄) |
59 | 12 |
| 같은 뜻의 한국어 문장 | 25 | 13 |
| Nginx 에러 로그 한 줄 | 160 | 55 |
| JSON 로그 한 줄 (UUID 포함) |
152 | 79 |
한국어 문장은 영어보다 글자 수가 절반도 안 되지만 토큰 수는 비슷합니다. 로그는 날짜, IP, 요청 ID 같은 숫자와 기호가 많아 영어 문장보다 글자당 토큰이 훨씬 많고, 특히 UUID처럼 규칙 없는 문자열은 잘게 쪼개집니다. 그래서 저는 입력 크기를 글자 수나 파일 크기로 어림하지 않고 토크나이저나 API의 토큰 계산 기능으로 확인합니다.
2. 입력 토큰, 출력 토큰과 요금
API 요금은 토큰 종류별로 단가가 따로 매겨집니다. 요청마다 응답의 usage 항목에 실제로 쓴 토큰 수가 기록되므로, 비용을 추적할 때는 이 값을 기준으로 봅니다.
| 종류 | 설명 |
| 입력 토큰 | 시스템 프롬프트, 이전 대화, 붙여 넣은 로그, 도구 정의까지 요청에 담긴 모든 토큰 |
| 출력 토큰 | 모델이 생성한 답, 입력보다 단가가 높음 |
| 캐시된 입력 | 프롬프트 캐싱으로 재사용한 앞부분, 일반 입력보다 싸게 과금 |
| 추론 토큰 | 추론 모델이 답하기 전에 내부적으로 쓰는 토큰, 화면에 보이지 않지만 출력으로 과금 |
Anthropic 요금표를 보면 모든 모델에서 출력 단가가 입력 단가의 5배입니다. 입력 100만 토큰당 2달러, 출력 100만 토큰당 10달러인 모델에 로그 2만 토큰과 질문 1천 토큰을 넣고 1천 토큰짜리 답을 받으면, 입력 약 0.042달러와 출력 0.01달러로 한 번에 약 0.052달러가 듭니다.
주의할 점은 대화가 이어질 때입니다. API는 이전 대화를 기억하지 않기 때문에 매 요청에 지금까지의 대화 전체를 다시 입력으로 보내고, 그만큼 다시 과금됩니다. 같은 로그를 두고 추가 질문을 다섯 번 하면 입력 토큰은 아래처럼 늘어납니다.
| 차례 | 입력 토큰 |
| 1번째 | 21,000 로그 20,000 + 질문 1,000 |
| 2번째 | 23,000 1번째 전체 + 답 1,000 + 질문 1,000 |
| 6번째 | 31,000 이전 대화 전체 + 질문 1,000 |
| 6번 합계 | 156,000 21,000 + 23,000 + … + 31,000 |
로그는 한 번 붙였지만 여섯 번 과금되어 입력 토큰이 첫 요청의 7배를 넘습니다. 프롬프트 캐싱을 쓰면 반복되는 앞부분을 훨씬 싸게 처리할 수 있지만, Anthropic 문서가 설명하듯 캐시된 토큰도 컨텍스트 윈도우 자리는 그대로 차지합니다. ChatGPT나 Claude 같은 채팅 서비스는 토큰당 요금을 내지 않을 뿐, 내부적으로는 같은 방식으로 대화 전체를 다시 읽습니다.
3. 응답 속도: Prefill과 Decode
NVIDIA의 LLM 추론 최적화 글은 응답 생성을 두 단계로 나눕니다. Prefill 단계에서는 입력 토큰 전체를 한꺼번에 처리하는데, 입력이 이미 다 주어져 있어 병렬로 계산할 수 있고 GPU 연산 성능을 거의 다 씁니다. Decode 단계에서는 출력 토큰을 하나씩 순서대로 만들며, 매번 가중치와 이전 계산 결과를 메모리에서 읽어야 해서 연산보다 메모리 대역폭이 속도를 좌우합니다.
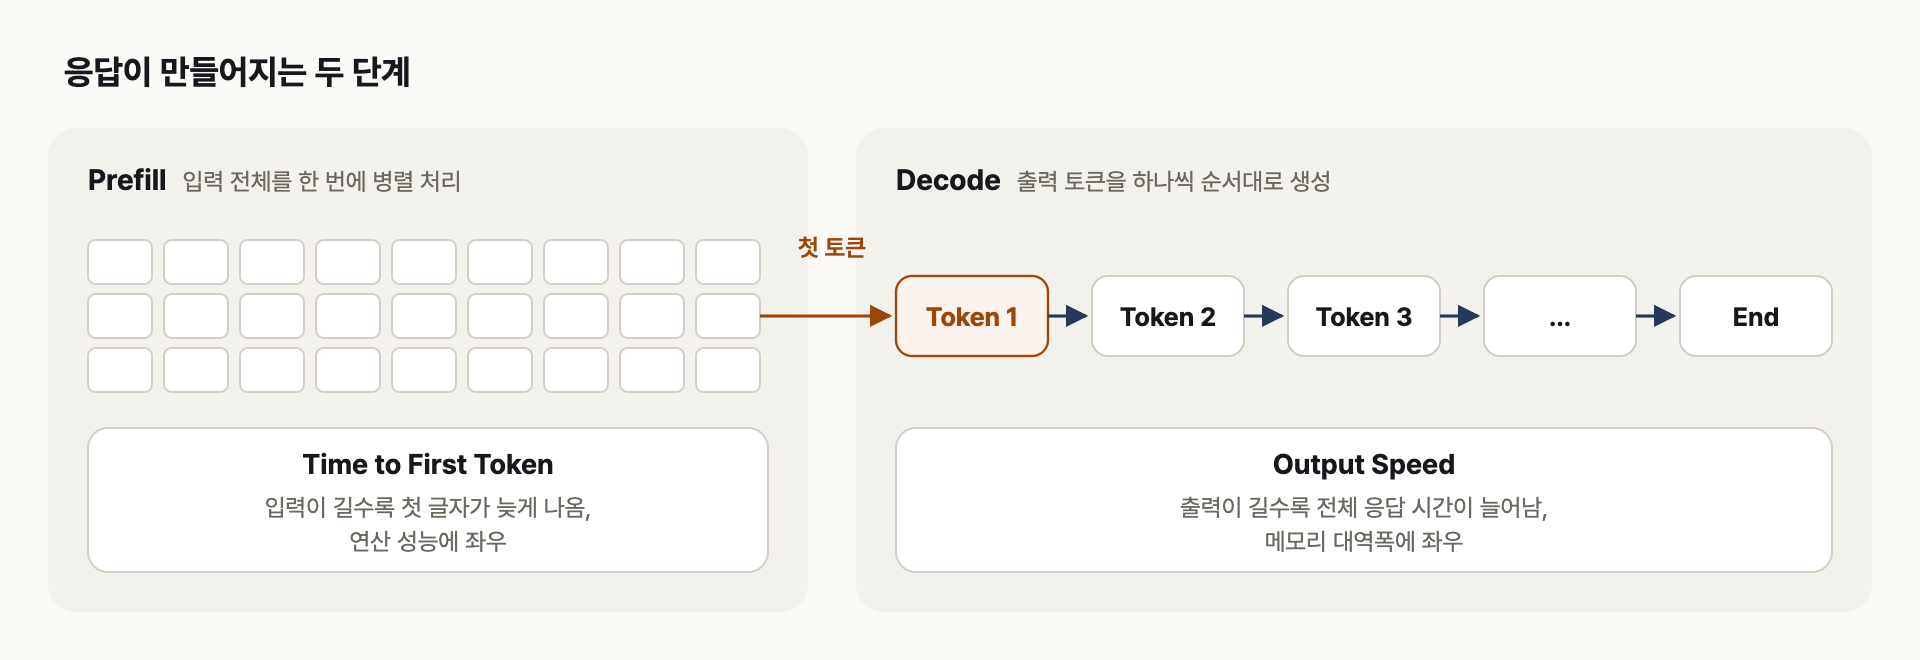
입력은 한 번에 처리해 첫 토큰을 만들고, 이후 출력은 한 토큰씩 이어서 생성합니다
| 상황 | 느려지는 이유와 대응 |
| 첫 글자가 늦게 나옴 |
입력이 길어 Prefill이 오래 걸림, 필요한 부분만 넣고 반복되는 앞부분은 캐싱 |
| 답이 끝날 때까지 오래 걸림 | 출력이 길어 Decode 횟수가 많음, 답의 형식과 길이를 지정 |
| 짧은 답인데 느림 | 추론 모델이 보이지 않는 추론 토큰을 많이 생성, 단순 작업은 추론 수준을 낮춤 |
스트리밍으로 받으면 전체 시간은 같아도 첫 토큰부터 화면에 보여 줄 수 있어 체감 대기 시간이 줄어듭니다. 저는 운영 스크립트에서 AI를 호출할 때 "원인 후보 3개, 확인 명령 포함"처럼 출력 형식을 정해 두는데, 출력 토큰이 줄어 비용과 시간이 함께 줄기 때문입니다.
4. 컨텍스트 윈도우
컨텍스트 윈도우는 모델이 응답을 만들 때 참고할 수 있는 토큰의 한도입니다. Anthropic 문서는 이를 학습 데이터와 구분되는 모델의 작업 기억(working memory)이라고 설명하며, 시스템 프롬프트, 이전 대화, 도구 정의, 첨부한 문서와 이미지, 그리고 이번에 생성할 출력까지 모두 이 한도 안에 들어가야 합니다.
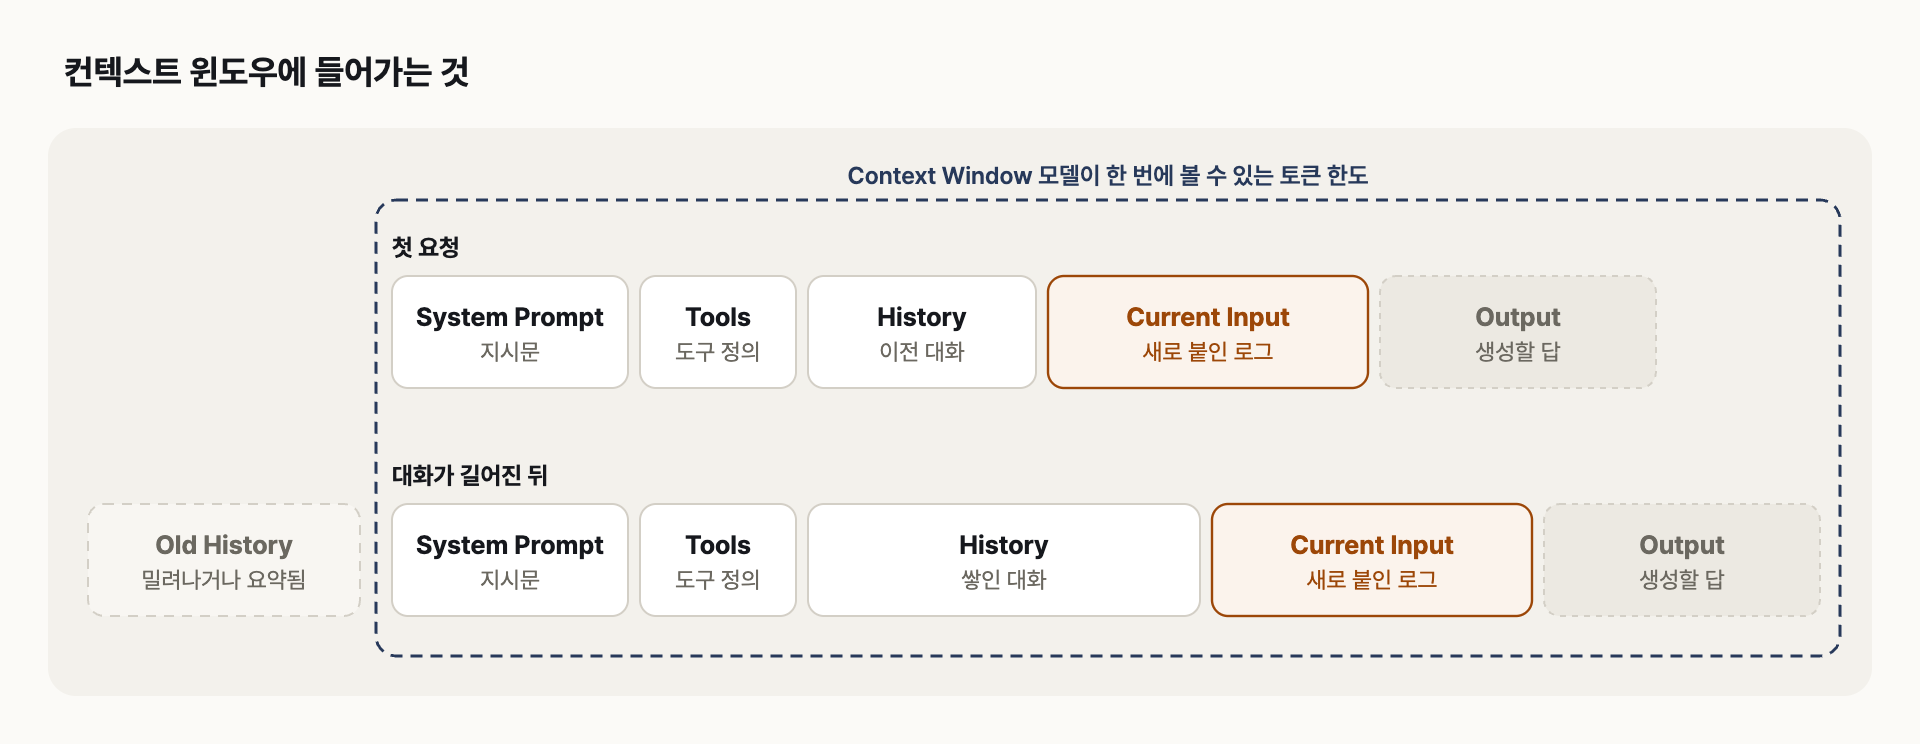
대화가 길어질수록 이전 대화가 윈도우를 채우고, 채팅 서비스에서는 가장 오래된 부분이 밀려나거나 요약될 수 있습니다
컨텍스트 윈도우 크기는 모델마다 다르며, 최근 모델은 수십만에서 100만 토큰 수준입니다. 이와 별도로 한 번에 생성할 수 있는 최대 출력 토큰도 정해져 있습니다. 한도를 넘으면 동작은 다음과 같습니다.
| 경우 | 동작 |
| 입력만으로 한도 초과 | API가 요청을 거부 (Claude는 400 prompt is too long) |
| 생성 중 한도 도달 | 출력이 중간에 끊기고 종료 사유로 표시 |
| 채팅 서비스에서 대화가 길어짐 | 오래된 대화를 밀어내거나 요약해 대화를 이어 감 |
5. 긴 로그를 넣으면 앞부분을 잊는 이유
긴 로그를 붙이고 대화를 몇 번 이어 가면 모델이 처음 로그 내용을 잘못 말하거나 없던 것처럼 답하는 경우가 있습니다. 원인은 크게 세 가지입니다.
| 원인 | 설명 |
| 잘림과 요약 | 채팅 서비스는 윈도우가 차면 오래된 대화부터 밀어내거나 요약하므로, 처음 붙인 로그가 이미 모델이 보는 범위 밖에 있을 수 있음 |
| Context Rot | 윈도우 안에 있어도 토큰이 많아질수록 원하는 정보를 정확히 찾아내는 능력이 떨어짐 |
| 위치 효과 | 입력의 처음과 끝에 있는 정보는 잘 쓰고, 중간에 있는 정보를 가장 많이 놓침 |
Anthropic은 두 번째 현상을 context rot이라고 부르며, 모든 토큰이 다른 모든 토큰과의 관계를 계산하는 트랜스포머 구조에서는 토큰이 n개면 관계가 n²개로 늘어나 모델의 주의력(attention budget)이 분산된다고 설명합니다. 세 번째 현상은 2023년 Lost in the Middle 논문에서 여러 문서 중 정답이 든 문서의 위치만 바꿔 가며 실험한 결과로, 정답이 입력의 가운데에 있을 때 성능이 가장 크게 떨어졌습니다.
즉 컨텍스트 윈도우가 100만 토큰이라는 것은 그만큼 넣을 수 있다는 뜻이지, 넣은 내용을 모두 똑같이 잘 활용한다는 뜻은 아닙니다. 로그를 많이 넣을수록 답이 좋아진다고 기대하기보다 모델이 볼 토큰을 줄이는 쪽이 정확도에 유리합니다.
6. 긴 로그를 넣을 때의 방법
장애 로그는 같은 에러가 수백 번 반복되는 경우가 많습니다. 반복되는 줄을 그대로 넣으면 토큰만 쓰고 정보는 늘지 않으므로, 메시지별로 횟수와 처음·마지막 시각을 집계해서 넣습니다. 아래 명령은 ISO 8601 시각으로 시작하는 로그에서 ERROR와 WARN 줄을 메시지별로 묶습니다.
# 시간순으로 정렬된 로그에서 메시지별 횟수와 처음·마지막 시각 집계
awk '/ERROR|WARN/ {
  t = substr($1, 12, 8); $1 = ""; msg = $0
  if (!(msg in first)) first[msg] = t
  last[msg] = t; cnt[msg]++
}
END { for (m in cnt) printf "%5d  %s ~ %s %s\n", cnt[m], first[m], last[m], m }' \
  app.log | sort -rn
ERROR와 WARN 242줄이 들어 있는 테스트 로그에 실행하면 다음 네 줄로 줄어듭니다.
   93  14:00:03 ~ 14:09:51  ERROR upstream connect failed: connection refused
   52  14:00:07 ~ 14:09:49  WARN retrying request
   50  14:00:01 ~ 14:09:52  ERROR token validation failed
   47  14:00:47 ~ 14:09:58  WARN slow query took 2300ms
집계 결과로 원인 후보를 좁힌 다음, 가장 의심되는 에러의 앞뒤 원본 몇십 줄만 추가로 넣으면 모델이 볼 토큰은 적고 근거는 충분해집니다.
| 방법 | 이유 |
| 시간 구간 자르기 | 증상 전후 몇 분만 남기면 토큰이 크게 줄어듦 |
| 반복 줄 집계 | 같은 에러 수백 줄을 횟수와 시각 한 줄로 요약 |
| 질문은 로그 뒤에 | Anthropic 문서는 긴 자료를 위에, 질문을 끝에 두면 테스트에서 응답 품질이 최대 30% 좋아졌다고 설명 |
| 긴 대화는 새로 시작 | 지금까지 확인한 내용을 요약해 새 대화에 넣으면 잘림과 누적 과금을 함께 피함 |
| 출력 형식 지정 | 출력 토큰이 줄어 비용과 응답 시간이 함께 줄어듦 |
로그를 자르고 민감 정보를 가리는 방법과 프롬프트 구조는 생성형 AI로 에러 로그 분석하는 프롬프트 정리에 정리해 두었습니다.
7. 정리
- 토큰은 모델의 처리, 과금, 한도의 단위이고, 한국어와 로그는 영어의 "1토큰 = 4글자" 어림이 맞지 않습니다.
- 출력 토큰은 입력보다 비싸고, 대화가 이어지면 이전 대화 전체가 매번 다시 입력으로 과금됩니다.
- 긴 입력은 첫 토큰을 늦추고(Prefill), 긴 출력은 전체 응답 시간을 늘립니다(Decode).
- 컨텍스트 윈도우 안에 있어도 입력이 길수록 정확도가 떨어지고 중간 내용을 놓치기 쉬우므로, 로그는 잘라서 집계한 뒤 넣습니다.
참고
'AI > 개념' 카테고리의 다른 글
| [AI] 프롬프트, RAG, 파인튜닝 선택 기준 정리 (0) | 2026.09.26 |
|---|---|
| [AI] AI 에이전트와 MCP 개념 정리 (0) | 2026.09.26 |
| [AI] RAG 개념과 사내 문서 챗봇 구성 정리 (0) | 2026.09.26 |
| [AI] 머신러닝, 딥러닝, 생성형 AI 개념 정리 (0) | 2026.09.25 |
