프롬프트, RAG, 파인튜닝은 서로 대신하는 관계가 아니라 해결하는 문제가 다릅니다. 모델이 필요한 정보를 모르는 지식 문제라면 프롬프트에 직접 넣거나 RAG로 검색해 넣고, 정보는 있는데 답의 형식이나 판단이 일관되지 않은 행동 문제라면 프롬프트를 다듬고 그래도 부족할 때 파인튜닝을 검토합니다. 어느 경우든 평가 세트를 먼저 만들고 프롬프트부터 시작하는 것이 시간과 비용이 가장 적게 듭니다.
1. 세 방법이 바꾸는 것
세 방법은 모델의 어디를 바꾸느냐가 다릅니다. 프롬프트와 RAG는 매 요청마다 모델에 들어가는 입력을 바꾸고, 파인튜닝은 추가 학습으로 모델의 가중치 자체를 바꿉니다.
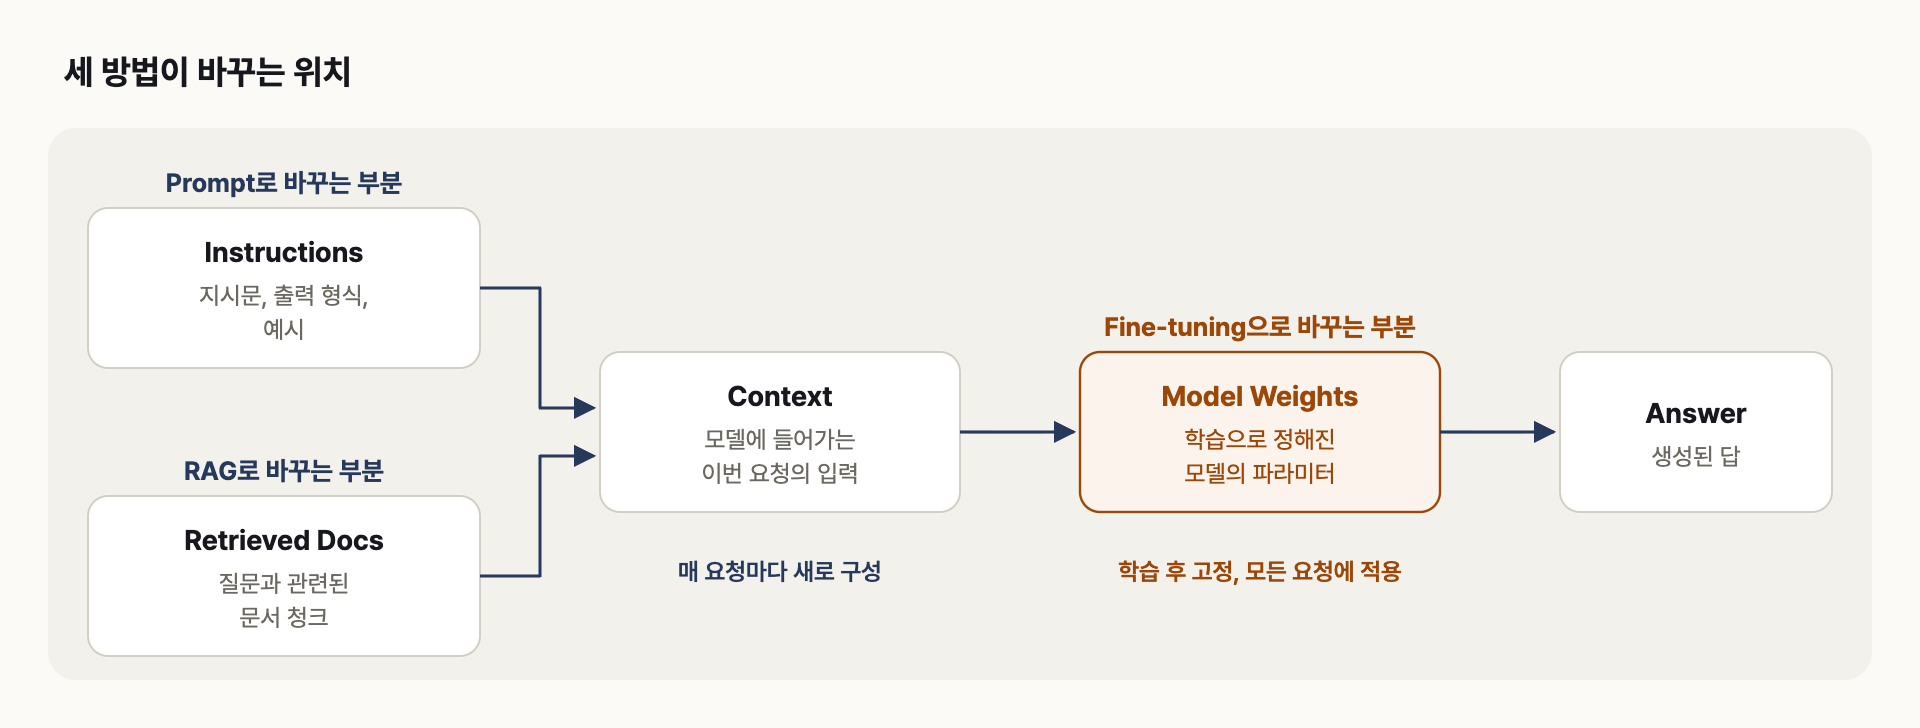
프롬프트와 RAG는 요청마다 입력을 구성하고, 파인튜닝은 모든 요청에 적용되는 모델을 바꿉니다
| 방법 | 바꾸는 곳과 특징 |
| 프롬프트 | 지시문, 출력 형식, 예시 같은 입력, 수정 즉시 반영되고 추가 인프라가 필요 없음 |
| RAG | 질문과 관련된 문서를 검색해 입력에 추가, 문서를 바꾸면 재색인 후 반영되고 검색 인프라가 필요 |
| 파인튜닝 | 학습 데이터로 모델 가중치를 조정, 바꾸려면 다시 학습해야 하고 학습 데이터와 평가가 필요 |
OpenAI의 정확도 최적화 가이드는 이 차이를 시험에 비유합니다. 시험장에 교과서를 가지고 들어가 필요한 부분을 찾아보는 것이 입력에 넣는 방식(in-context memory)이고, 몇 달 동안 공부해 머리에 익혀 두는 것이 학습으로 넣는 방식(learned memory)입니다. 교과서는 내용이 바뀌면 바로 새 책을 들고 가면 되지만, 공부한 내용을 바꾸려면 다시 공부해야 한다는 차이가 그대로 운영 방식의 차이로 이어집니다.
2. 먼저 문제를 나누기: 지식 문제와 행동 문제
같은 가이드는 정확도 문제를 두 축으로 나눕니다. 하나는 모델이 필요한 정보를 모르거나 오래된 정보를 가지고 있는 맥락(context) 문제이고, 다른 하나는 답의 형식, 말투, 추론 방식이 들쭉날쭉한 모델 동작(LLM behavior) 문제입니다. 앞의 것은 입력에 정보를 넣어 해결하고, 뒤의 것은 지시와 예시를 다듬거나 학습으로 해결합니다.
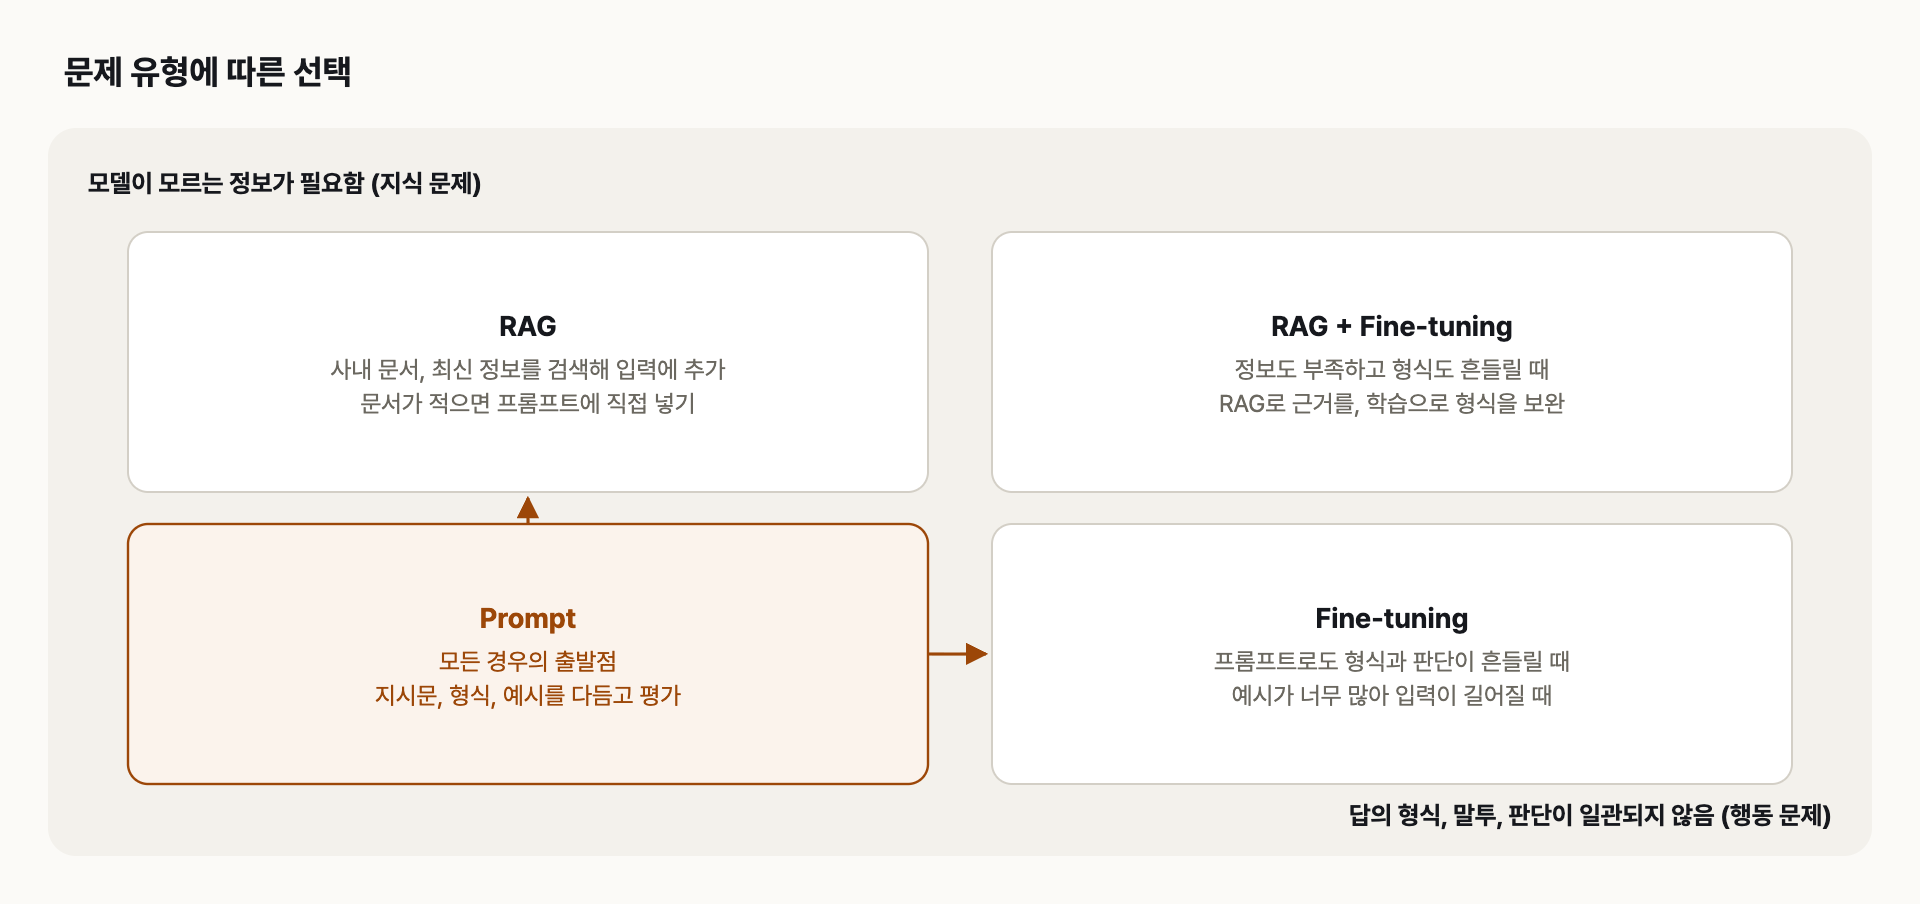
프롬프트에서 시작해 부족한 쪽으로 이동하며, 두 방법은 함께 쓸 수 있습니다
이 구분이 중요한 이유는 문제를 잘못 진단하면 비용만 쓰고 결과가 좋아지지 않기 때문입니다. 예를 들어 사내 런북 내용을 모르는 것은 지식 문제인데, 이를 파인튜닝으로 해결하려고 하면 학습 데이터를 만드는 데 시간이 들고 런북이 바뀔 때마다 다시 학습해야 합니다. OpenAI 가이드도 파인튜닝을 지식을 넣는 수단보다 일관된 동작을 가르치는 수단으로 설명하며, 두 방법은 대체 관계가 아니라 더해 쓸 수 있다고 봅니다.
3. 증상별 선택 기준
실제로 문제가 생겼을 때 저는 증상을 보고 다음 표로 먼저 방향을 정합니다.
| 증상 | 먼저 시도할 방법 |
| 사내 문서나 최신 정보를 모름 | 문서가 적으면 프롬프트에 직접 넣고, 많거나 계속 늘어나면 RAG |
| 답에 출처를 표시해야 함 | RAG, 검색된 문서 경로를 답과 함께 보여 줄 수 있음 |
| 사용자마다 볼 수 있는 문서가 다름 | RAG, 학습된 내용은 모든 사용자에게 같은 모델로 나가므로 권한별 제한이 어려움 |
| 정보가 자주 바뀜 | RAG, 재색인만으로 반영되고 재학습이 필요 없음 |
| 답의 형식이 매번 다름 | 프롬프트에 형식과 예시를 명시, 그래도 흔들리면 파인튜닝 |
| 분류나 말투를 일관되게 맞춰야 함 | 예시 몇 개를 프롬프트에 넣고, 예시가 수십 개 이상 필요하면 파인튜닝 |
| 지시문과 예시가 길어 비용과 지연이 큼 | 파인튜닝으로 프롬프트를 줄이거나 더 작은 모델로 대체 |
마지막 항목은 OpenAI의 모델 최적화 가이드가 드는 파인튜닝의 장점입니다. 학습으로 원하는 동작을 익히면 매 요청에 긴 예시를 넣지 않아도 되어 토큰 비용과 지연이 줄고, 특정 작업에 한해서는 더 작고 저렴한 모델을 쓸 수 있습니다. 요청이 하루 수천 건 이상 반복되는 작업일수록 이 차이가 커집니다.
4. 항목별 비교
운영 관점에서 세 방법을 비교하면 다음과 같습니다.
| 항목 | 프롬프트 / RAG / 파인튜닝 |
| 준비물 | 프롬프트: 지시문과 예시 RAG: 문서 수집, 청킹, 임베딩, 벡터 DB 파인튜닝: 입력과 기대 출력 쌍으로 된 학습 데이터 |
| 변경 반영 | 프롬프트: 수정 즉시 RAG: 재색인 후 파인튜닝: 재학습과 재평가 후 |
| 요청당 입력 | 프롬프트: 지시문과 예시만큼 RAG: 검색된 청크만큼 증가 파인튜닝: 예시를 줄일 수 있어 감소 |
| 추가 인프라 | 프롬프트: 거의 없음 RAG: 수집 작업, 임베딩, 벡터 DB, 검색 API 파인튜닝: 학습 작업, 모델 버전 관리, 직접 운영 시 GPU |
| 실패할 때 볼 곳 | 프롬프트: 지시문과 평가 결과 RAG: 검색 로그 파인튜닝: 학습 데이터 품질 |
RAG의 구성 요소와 검색 로그를 보는 방법은 RAG 개념과 사내 문서 챗봇 구성 정리에서 자세히 다루었습니다.
5. 파인튜닝을 검토할 때 알아 둘 것
파인튜닝은 입력과 기대하는 출력의 쌍을 모델에 학습시키는 것입니다. OpenAI의 지도 학습 방식(supervised fine-tuning) 문서 기준으로 학습 데이터는 한 줄에 한 예시를 담은 JSONL 파일이며, 최소 10개부터 가능하고 잘 만든 예시 50개로 시작해 결과를 평가하라고 권합니다. 예를 들어 알람 메시지를 정해진 JSON으로 분류하는 작업이라면 한 줄은 다음과 같습니다.
{
  "messages": [
    {
      "role": "system",
      "content": "알람을 JSON으로 분류합니다."
    },
    {
      "role": "user",
      "content": "[CRITICAL] db-server disk usage 95% on /var"
    },
    {
      "role": "assistant",
      "content": "{\"severity\": \"critical\", \"category\": \"disk\"}"
    }
  ]
}
실제 JSONL 파일에서는 이 예시 하나가 한 줄로 들어가며, 위 예시는 읽기 쉽게 줄을 나눈 것입니다. 이 형식에서 알 수 있듯이 파인튜닝에서 가장 많은 시간이 드는 부분은 학습 자체보다 실제 입력을 대표하는 좋은 예시를 모으고 검수하는 일입니다.
| 항목 | 알아 둘 점 |
| 학습 방식 | OpenAI는 지도 학습(SFT) 외에 선호도 학습(DPO), 강화 학습 방식(RFT) 등을 제공하며, SFT는 분류와 특정 형식의 생성에 적합하다고 안내 |
| 직접 학습 | 오픈 모델을 사내 GPU로 학습할 때는 LoRA 같은 방식을 많이 씀, 원래 가중치는 고정하고 작은 행렬만 학습 |
| 모델 교체 | 기반 모델을 새 버전으로 바꾸면 이전에 학습한 결과를 그대로 쓸 수 없어 다시 학습과 평가가 필요 |
| 데이터 보안 | 학습 데이터에 들어간 내용은 모델 가중치에 반영되므로 민감 정보를 넣지 않도록 검수 |
LoRA 논문은 GPT-3 175B 모델을 기준으로 전체 파인튜닝 대비 학습하는 파라미터 수를 1만 분의 1로, GPU 메모리 요구량을 3분의 1로 줄이면서도 품질은 비슷하거나 더 좋았다고 보고합니다. 그래서 사내 GPU로 오픈 모델을 조정하는 경우 전체 파인튜닝보다 LoRA 계열을 먼저 검토하며, 학습에 필요한 GPU 메모리 개념은 GPU 개념 글을 참고하시면 됩니다.
6. 선택하고 개선하는 순서
어떤 방법을 쓰든 먼저 평가 세트가 있어야 합니다. 자주 받는 질문과 기대하는 답을 수십 개 모아 두면, 프롬프트를 고치거나 RAG를 붙이거나 파인튜닝을 했을 때 실제로 좋아졌는지를 같은 기준으로 비교할 수 있습니다. OpenAI 가이드도 평가를 만들어 기준선을 정하고 프롬프트부터 시작한 뒤, 틀린 원인에 따라 RAG나 파인튜닝을 더하라고 권합니다.

평가 세트는 한 번 만들어 두고, 방법을 바꿀 때마다 같은 세트로 다시 측정합니다
평가 없이 방법부터 정하면 "RAG를 붙였더니 좋아진 것 같다"는 느낌만 남고, 어떤 질문이 좋아지고 어떤 질문이 나빠졌는지 알 수 없습니다. 저는 평가 결과를 질문별로 남겨 두고, 틀린 질문을 지식 부족과 동작 불일치로 나눠 세는 방식으로 다음 방법을 정합니다.
7. 인프라 업무 사례로 보는 선택
| 사례 | 선택과 이유 |
| 장애 로그 분석 | 프롬프트, 로그는 매번 새로 붙이는 입력이므로 템플릿과 출력 형식을 정하는 것이 핵심 |
| 사내 런북 챗봇 | RAG, 문서가 많고 자주 바뀌며 출처 표시와 권한별 검색이 필요 |
| 사내 용어와 서비스 이름 이해 | 용어집을 프롬프트에 넣거나 RAG로 검색, 용어가 바뀔 때 재학습 없이 반영 |
| 하루 수천 건 알람 분류 | 프롬프트로 시작하고, 형식 오류가 남거나 비용이 크면 파인튜닝으로 작은 모델에 학습 |
| 런북 기반 조치 안내를 정해진 보고서 형식으로 작성 | RAG로 근거를 찾고, 형식이 계속 흔들리면 파인튜닝을 더함 |
장애 로그 분석 프롬프트는 생성형 AI로 에러 로그 분석하는 프롬프트 정리에 템플릿으로 정리해 두었습니다.
8. 정리
- 프롬프트와 RAG는 매 요청의 입력을 바꾸고, 파인튜닝은 모델 가중치를 바꿉니다.
- 모델이 정보를 모르는 지식 문제는 프롬프트나 RAG로, 형식과 판단이 흔들리는 행동 문제는 프롬프트와 파인튜닝으로 해결합니다.
- 자주 바뀌는 정보, 출처 표시, 사용자별 권한이 필요하면 RAG가 맞고, 반복 작업의 형식 일관성과 비용 절감이 목표라면 파인튜닝이 맞습니다.
- 평가 세트를 먼저 만들고 프롬프트부터 시작해, 틀린 원인에 따라 방법을 더해 갑니다.
참고
'AI > 개념' 카테고리의 다른 글
| [AI] AI 에이전트와 MCP 개념 정리 (0) | 2026.09.26 |
|---|---|
| [AI] RAG 개념과 사내 문서 챗봇 구성 정리 (0) | 2026.09.26 |
| [AI] LLM 토큰과 컨텍스트 윈도우 개념 정리 (0) | 2026.09.26 |
| [AI] 머신러닝, 딥러닝, 생성형 AI 개념 정리 (0) | 2026.09.25 |
