GPU는 한 스레드를 빠르게 처리하는 대신 수천 개의 스레드를 동시에 돌리도록 설계된 프로세서이고, 딥러닝의 핵심인 행렬 곱셈이 이런 구조에 잘 맞아 AI 인프라의 기본 단위가 되었습니다. 인프라 관점에서 GPU를 고를 때는 연산 성능보다 먼저 메모리 용량과 대역폭, GPU 사이의 연결 방식, 전력과 냉각을 봐야 합니다. 모델이 GPU 메모리에 들어가지 않으면 다른 조건은 의미가 없기 때문입니다.
1. GPU가 AI에 쓰이는 이유
NVIDIA CUDA 프로그래밍 가이드는 CPU와 GPU의 차이를 설계 목표로 설명합니다. CPU는 순서대로 이어지는 연산(스레드)을 최대한 빨리 처리하도록 만들어져 수십 개 정도의 스레드를 병렬로 실행하고, GPU는 단일 스레드 성능을 낮추는 대신 수천 개의 스레드를 동시에 실행해 전체 처리량을 높입니다. 그래서 CPU는 칩 면적을 캐시와 제어 로직에 많이 쓰고, GPU는 데이터 처리 유닛에 더 많이 씁니다.
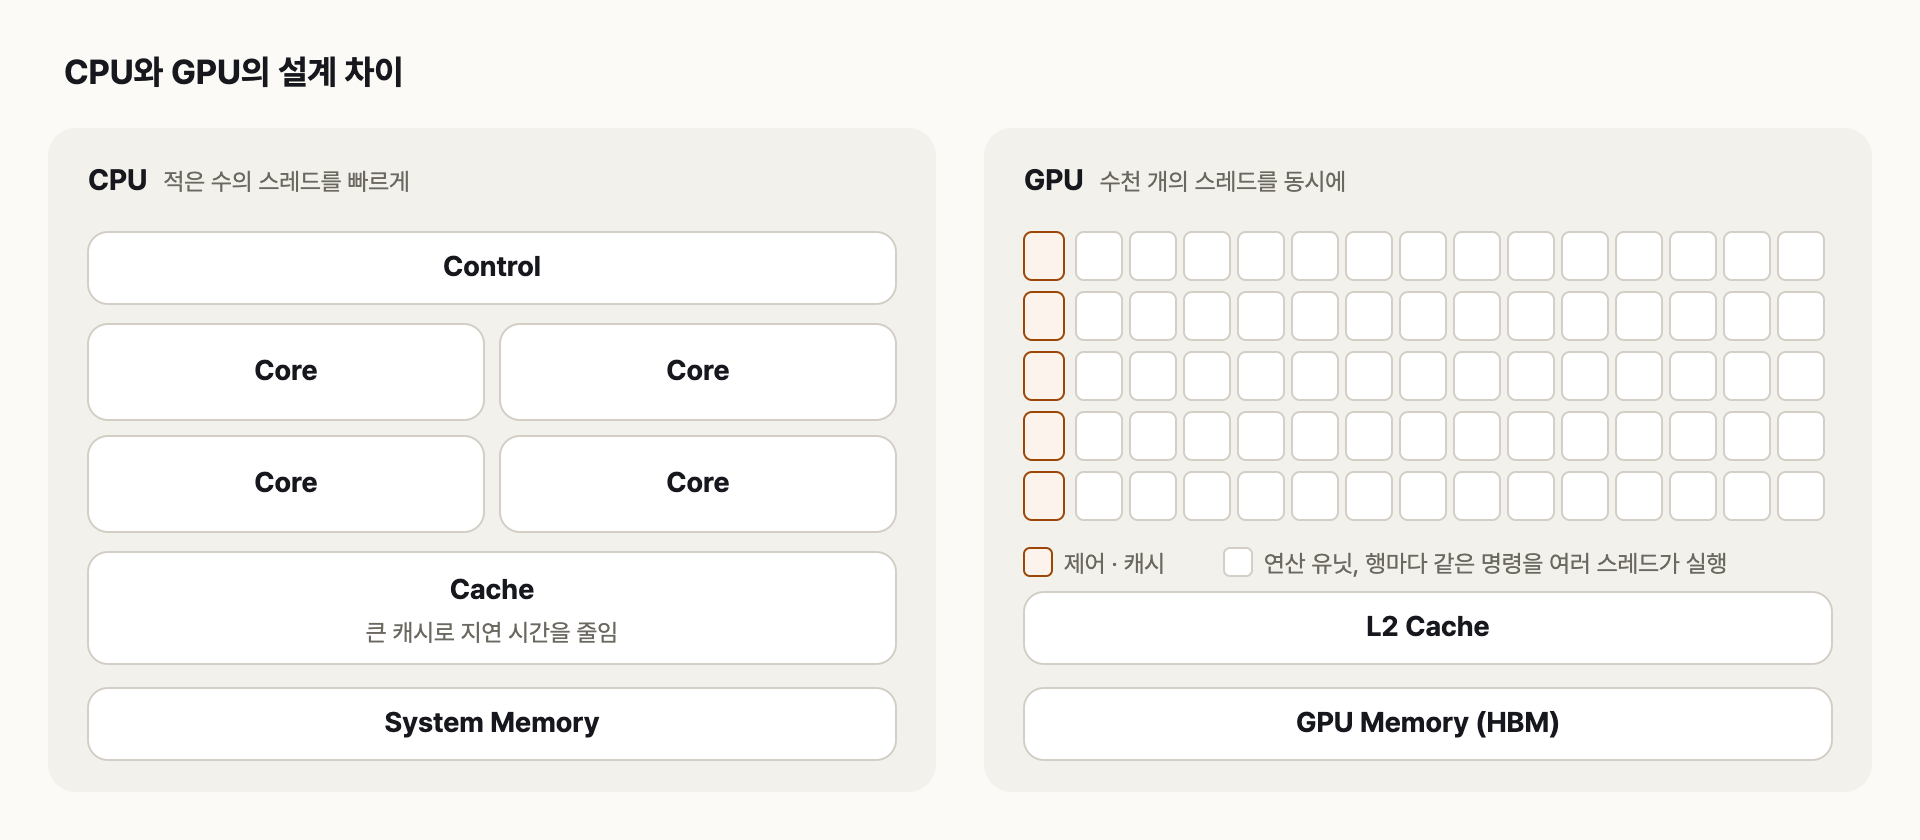
CPU는 적은 수의 큰 코어와 큰 캐시로, GPU는 많은 연산 유닛으로 칩을 채웁니다
딥러닝 모델의 학습과 추론은 대부분 큰 행렬끼리 곱하는 연산입니다. 행렬 곱셈은 결과의 각 원소를 다른 원소와 독립적으로 계산할 수 있어서, 같은 연산을 수천 개의 스레드에 나눠 동시에 처리하는 GPU 구조와 잘 맞습니다.
| 구분 | CPU | GPU |
| 설계 목표 | 한 스레드를 빠르게 | 많은 스레드를 동시에 |
| 동시 스레드 | 수십 개 | 수천 개 이상 |
| 칩 자원 | 캐시와 제어 로직 비중이 큼 | 연산 유닛 비중이 큼 |
| 잘 맞는 작업 | 분기가 많은 일반 처리 | 행렬 연산 같은 대량 병렬 처리 |
2. GPU 내부 구조
CUDA 가이드는 GPU를 여러 개의 SM(Streaming Multiprocessor)이 모인 장치로 봅니다. SM 여러 개가 GPC(Graphics Processing Cluster)로 묶이고, 각 SM 안에 연산 유닛과 레지스터 파일, 공유 메모리와 L1 캐시가 있습니다. 모든 SM은 L2 캐시와 GPU 메모리를 함께 쓰며, CPU와 GPU는 PCIe나 NVLink 같은 인터커넥트로 연결됩니다.
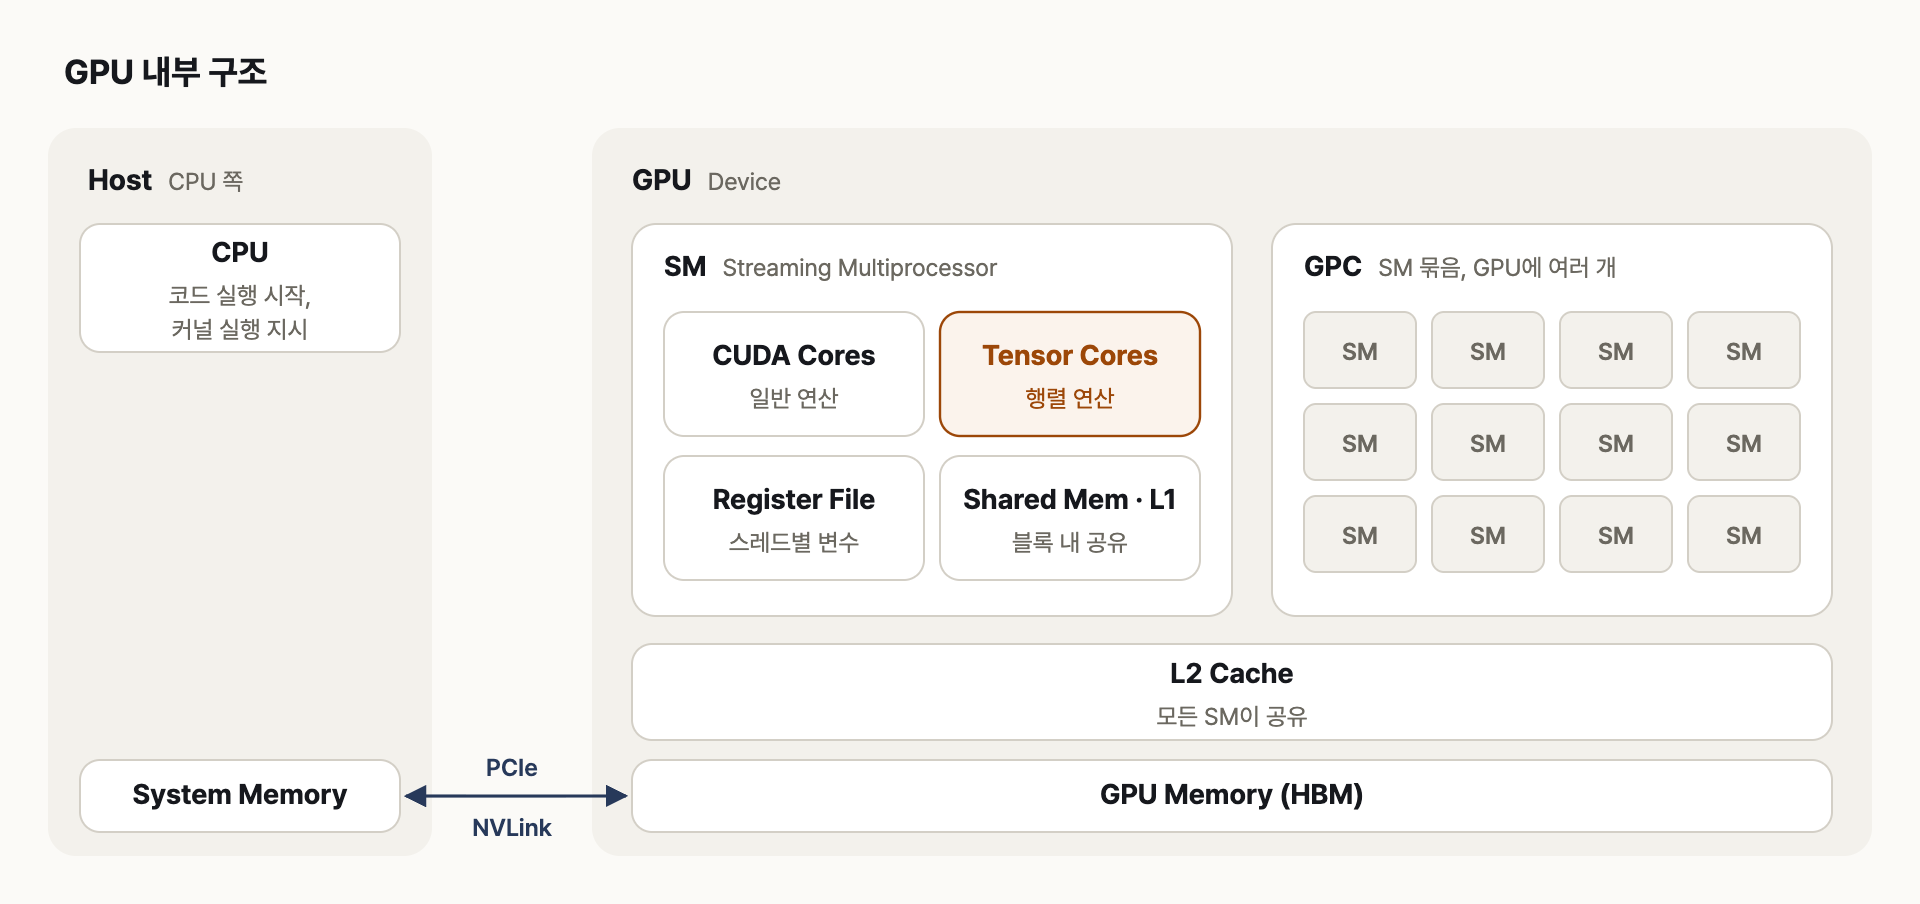
호스트 메모리의 데이터가 PCIe나 NVLink로 GPU 메모리에 복사되고, 여러 SM이 이 데이터를 나눠 처리합니다
프로그램은 항상 CPU에서 시작하고, CPU가 데이터를 GPU 메모리로 복사한 뒤 GPU에서 실행할 함수(커널)를 띄웁니다. GPU는 이 커널을 많은 스레드로 나눠 SM에 배분하는데, 스레드는 32개씩 워프(warp) 단위로 같은 명령을 함께 실행합니다.
| 용어 | 의미 |
| SM | GPU 연산의 기본 블록, GPU 하나에 수십에서 수백 개 |
| CUDA Core | SM 안에서 일반 산술 연산을 처리하는 유닛 |
| Tensor Core | 행렬 곱셈과 누산을 빠르게 처리하는 전용 유닛, 낮은 정밀도일수록 처리량이 커짐 |
| Warp | 같은 명령을 함께 실행하는 32개 스레드 묶음 |
| GPU 메모리 | GPU에 직접 붙은 메모리(VRAM), H100 같은 고성능 GPU는 대역폭이 높은 HBM을 사용 |
3. 메모리 용량과 대역폭
인프라 관점에서 가장 먼저 볼 숫자는 GPU 메모리입니다. 모델의 가중치가 GPU 메모리에 모두 올라가야 제 속도로 추론할 수 있고, 들어가지 않으면 GPU를 여러 장 쓰거나 정밀도를 낮춰야 합니다. 예를 들어 NVIDIA H100 SXM은 GPU 메모리가 80GB이고 메모리 대역폭이 3.35TB/s입니다.
필요한 메모리는 파라미터 수에 파라미터 하나의 크기(바이트)를 곱해 어림할 수 있습니다. 파라미터가 700억 개(70B)인 모델을 FP16으로 올리면 가중치만 약 140GB라서 80GB GPU 한 장에 들어가지 않습니다.
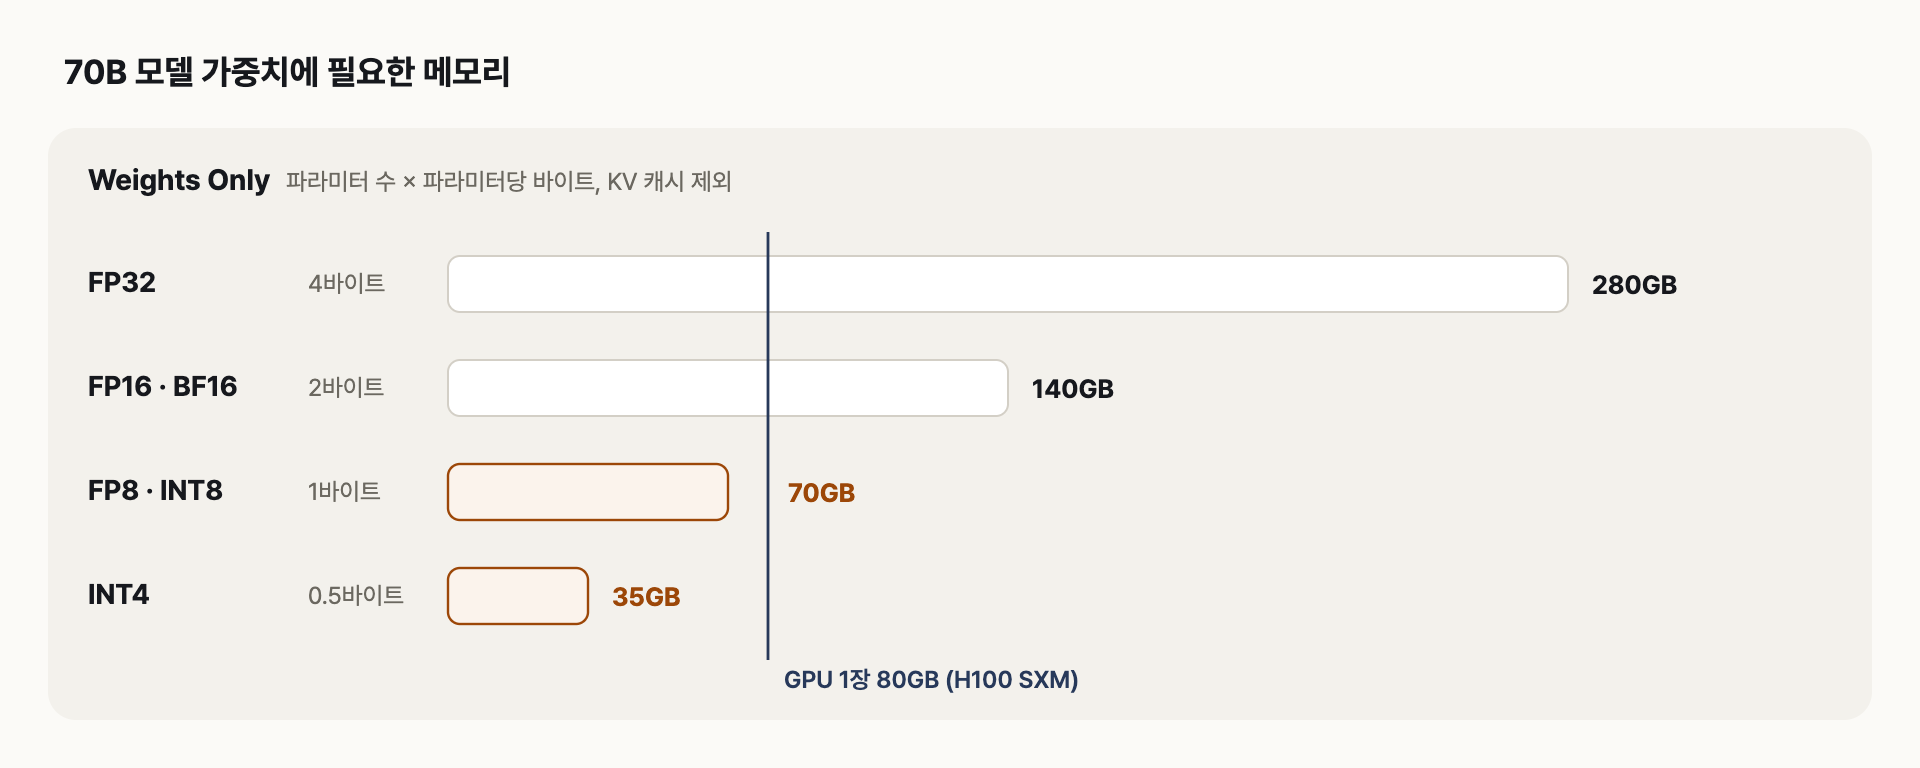
같은 70B 모델도 정밀도에 따라 필요한 메모리가 8배까지 차이 납니다. 실제로는 KV 캐시와 실행 공간이 더 필요합니다
대역폭도 용량만큼 중요합니다. LLM은 토큰을 하나 만들 때마다 가중치를 메모리에서 읽어 와야 해서, 한 번에 처리하는 요청이 적을 때는 연산 성능보다 메모리 대역폭이 생성 속도를 좌우하는 경우가 많습니다. KV 캐시를 포함한 추론 메모리 계산은 다음 글에서 따로 정리하겠습니다.
4. 정밀도와 Tensor Core
정밀도는 숫자 하나를 몇 비트로 표현하느냐입니다. 비트 수를 줄이면 메모리와 대역폭을 덜 쓰고 Tensor Core가 더 많은 연산을 처리할 수 있지만, 표현할 수 있는 값의 범위와 정확도가 줄어듭니다. 그래서 학습은 BF16이나 FP16을, 추론은 FP8이나 INT8, INT4까지 낮추는 양자화를 함께 검토합니다.
| 정밀도 · 크기 | 주로 쓰는 곳 |
| FP32 4바이트 |
일반 연산, 정확도가 중요한 계산 |
| FP16, BF16 2바이트 |
딥러닝 학습과 추론의 기본 |
| FP8, INT8 1바이트 |
추론 가속, 최신 GPU의 학습 |
| INT4 0.5바이트 |
양자화한 모델의 추론 |
GPU 사양표의 연산 성능(TFLOPS)은 정밀도마다 따로 적혀 있고, Tensor Core 수치에는 희소성(sparsity)을 적용한 값이 표기되기도 합니다. 저는 사양표를 비교할 때 같은 정밀도끼리, 희소성 적용 여부까지 맞춰서 봅니다.
5. GPU를 여러 장 쓸 때
모델이 GPU 한 장에 들어가지 않으면 여러 GPU에 나눠 올리고, 계산 중간 결과를 GPU끼리 계속 주고받습니다. 이때 GPU 사이의 연결 대역폭이 전체 속도를 제한하기 때문에 고성능 데이터센터 GPU는 PCIe 외에 NVLink로 GPU끼리 직접 연결합니다. H100 SXM 기준으로 NVLink는 900GB/s, PCIe Gen5는 128GB/s입니다.
반대로 GPU 한 장이 남을 때는 MIG(Multi-Instance GPU)로 나눠 쓸 수 있습니다. H100 SXM은 최대 7개 인스턴스(각 10GB)로 나눌 수 있어서, 작은 모델 여러 개를 격리된 상태로 한 GPU에서 돌릴 때 유용합니다.
6. 인프라 엔지니어가 확인할 것
GPU 서버를 도입하거나 클라우드 GPU VM을 고를 때 저는 연산 성능보다 아래 항목을 먼저 확인합니다. 연산 성능이 높아도 메모리가 부족하거나 전력과 냉각이 받쳐 주지 않으면 성능을 쓸 수 없기 때문입니다.
| 항목 | 확인하는 이유 |
| GPU 메모리 | 올릴 모델과 정밀도가 들어가는지 |
| 메모리 대역폭 | LLM 토큰 생성 속도에 직접 영향 |
| GPU 간 연결 | 여러 장을 묶을 때 NVLink 지원 여부 |
| MIG 지원 | 한 GPU를 여러 워크로드로 나눠 쓸지 |
| 전력과 냉각 | H100 SXM은 최대 700W, 랙 전력과 냉각 용량 확인 |
| 드라이버와 CUDA | 프레임워크가 요구하는 CUDA 버전과 드라이버 호환 |
7. 정리
- GPU는 수천 개의 스레드를 동시에 실행하도록 설계되어, 행렬 곱셈이 대부분인 딥러닝에 잘 맞습니다.
- GPU는 여러 SM으로 이루어지고, SM 안의 Tensor Core가 낮은 정밀도의 행렬 연산을 빠르게 처리합니다.
- 모델이 GPU 메모리에 들어가는지가 먼저이고, 필요한 메모리는 파라미터 수와 정밀도로 어림합니다.
- 여러 장을 쓸 때는 NVLink 같은 GPU 간 연결을, 한 장을 나눠 쓸 때는 MIG를 확인합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [NVIDIA] AI 인프라 전력·냉각·네트워크 정리 (0) | 2026.09.26 |
|---|---|
| [NVIDIA] DGX와 HGX 사양 비교 (0) | 2026.09.26 |
