모델이 커지면 GPU 한 장에 다 올라가지 않아서 여러 GPU가 일을 나눠 맡습니다. 나누는 방법은 크게 데이터를 나누는 방식(DP), 레이어 하나를 쪼개는 방식(TP), 레이어를 순서대로 나눠 맡는 방식(PP)이고, 큰 MoE 모델과 긴 문맥을 위한 방식(EP, CP)이 더해집니다. 같은 방식이라도 학습에서는 "메모리에 다 들어가는가"가, 추론에서는 "답이 얼마나 빨리, 많이 나오는가"가 기준이라 쓰는 이유가 다릅니다.
1. 학습과 추론의 메모리
학습은 모델 가중치만 올리는 게 아니라, 가중치를 얼마나 고칠지 계산한 값(Gradient)과 고치는 방향을 기억해 두는 값(Optimizer 상태)도 함께 올려야 합니다. 흔히 쓰는 Mixed Precision과 Adam 조합이면 파라미터 하나에 약 16바이트가 필요하고, 계산 중간 결과(Activation)도 저장합니다. 추론은 가중치와 지금까지 읽은 문맥을 기억해 두는 KV Cache만 있으면 되어 파라미터 하나에 2바이트(FP16)나 1바이트(FP8)면 됩니다.
| 항목 | 학습 | 추론 |
| 가중치 | FP16 + FP32 사본 | FP16·FP8·FP4 |
| Gradient·Optimizer 상태 | 있음 | 없음 |
| 중간 값 | Activation(되짚어 계산할 때 필요) | KV Cache(생성 중인 문맥) |
| 70B 모델 예 | 약 1.1TB + Activation | 140GB(FP16) + KV Cache |
| 기준 | GPU당 메모리, Gradient 통신 | 토큰 지연, 처리량 |
같은 70B 모델도 학습은 Activation을 빼고도 80GB GPU 14장 이상이 필요하고, 추론은 2장(FP16)이나 1장(FP8)에 가중치를 올린 뒤 KV Cache 여유에 따라 GPU를 더합니다.
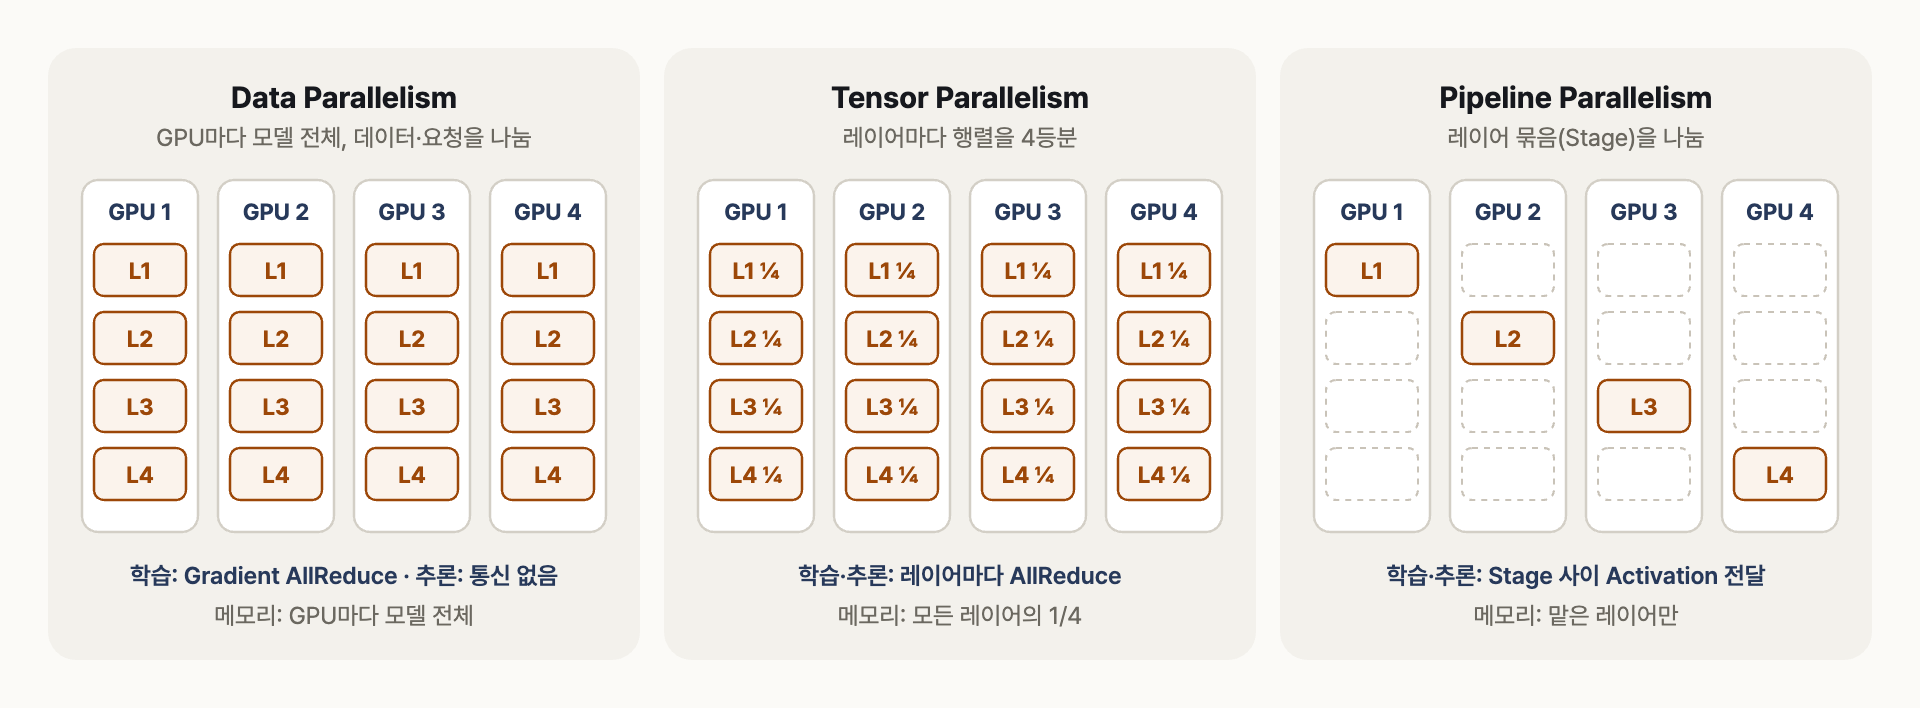
레이어 4개짜리 모델을 GPU 4개에 나누는 세 가지 기본 방식
GPU 구성과 통신 대역폭은 GPU 노드에서 랙까지 구성 정리와 GPU 랙에서 클러스터까지 구성 정리에서 다뤘고, 이 글은 그 위에서 모델을 어떻게 나누는지를 정리합니다.
2. Data Parallelism
Data Parallelism은 GPU마다 모델 전체를 똑같이 두고 처리할 데이터만 나눕니다. 같은 요리책을 가진 주방 여러 곳이 주문을 나눠 받는 것과 같습니다.
학습에서는 GPU마다 다른 데이터로 가중치를 어떻게 고칠지(Gradient)를 계산한 뒤, 단계가 끝날 때마다 모든 GPU의 결과를 더해 맞춥니다(AllReduce). 맞추는 통신이 단계마다 한 번뿐이라 서버 사이에 두어도 부담이 적지만, GPU마다 모델 전체가 들어가야 한다는 한계가 있습니다. 이 중복을 GPU끼리 나눠 갖게 한 것이 ZeRO이고, PyTorch의 FSDP가 ZeRO 3단계와 같은 방식입니다.
| 단계 | 나누는 것 | GPU당 메모리 | 통신량 |
| 기본 DP | 없음 | 약 1,120GB | 1배 |
| ZeRO 1 | Optimizer 상태 | 약 293GB | 1배 |
| ZeRO 2 | + Gradient | 약 155GB | 1배 |
| ZeRO 3·FSDP | + 가중치 | 약 17.5GB | 1.5배 |
70B 모델을 GPU 64개로 학습하는 경우를 Activation을 빼고 계산한 값이고, 통신량은 기본 DP를 1로 놓고 비교했습니다. 기본 DP는 GPU 한 장에 1TB가 넘게 필요해서 불가능하고, ZeRO 3에서야 80GB GPU에 들어갑니다. 대신 ZeRO 3은 Forward와 Backward마다 가중치를 AllGather로 모아야 해서 통신량이 1.5배가 됩니다.
추론에서는 같은 모델을 여러 벌(Replica) 띄워 두고 요청을 나눠 주는 것이 Data Parallelism입니다. 모델끼리 주고받을 것이 없어서 처리량을 늘리는 가장 쉬운 방법이지만, 모델 한 벌이 GPU 한 장에 들어가지 않으면 아래의 TP나 PP로 한 벌부터 만들어야 합니다. ZeRO는 학습에만 있는 Gradient와 Optimizer 상태를 나누는 방식이라 추론에는 쓰지 않습니다.
3. Tensor Parallelism
Tensor Parallelism은 레이어 하나의 큰 행렬 계산을 여러 GPU가 조각내서 동시에 합니다. 요리 한 접시를 요리사 여러 명이 재료를 나눠 동시에 손질하고 마지막에 합치는 식입니다. Megatron-LM 방식은 행렬을 한 번은 세로(Column)로, 한 번은 가로(Row)로 나누도록 배치해서 중간에는 통신 없이 계산하고 마지막에 결과를 한 번 합칩니다(AllReduce). Attention은 Head 단위로 나눕니다.
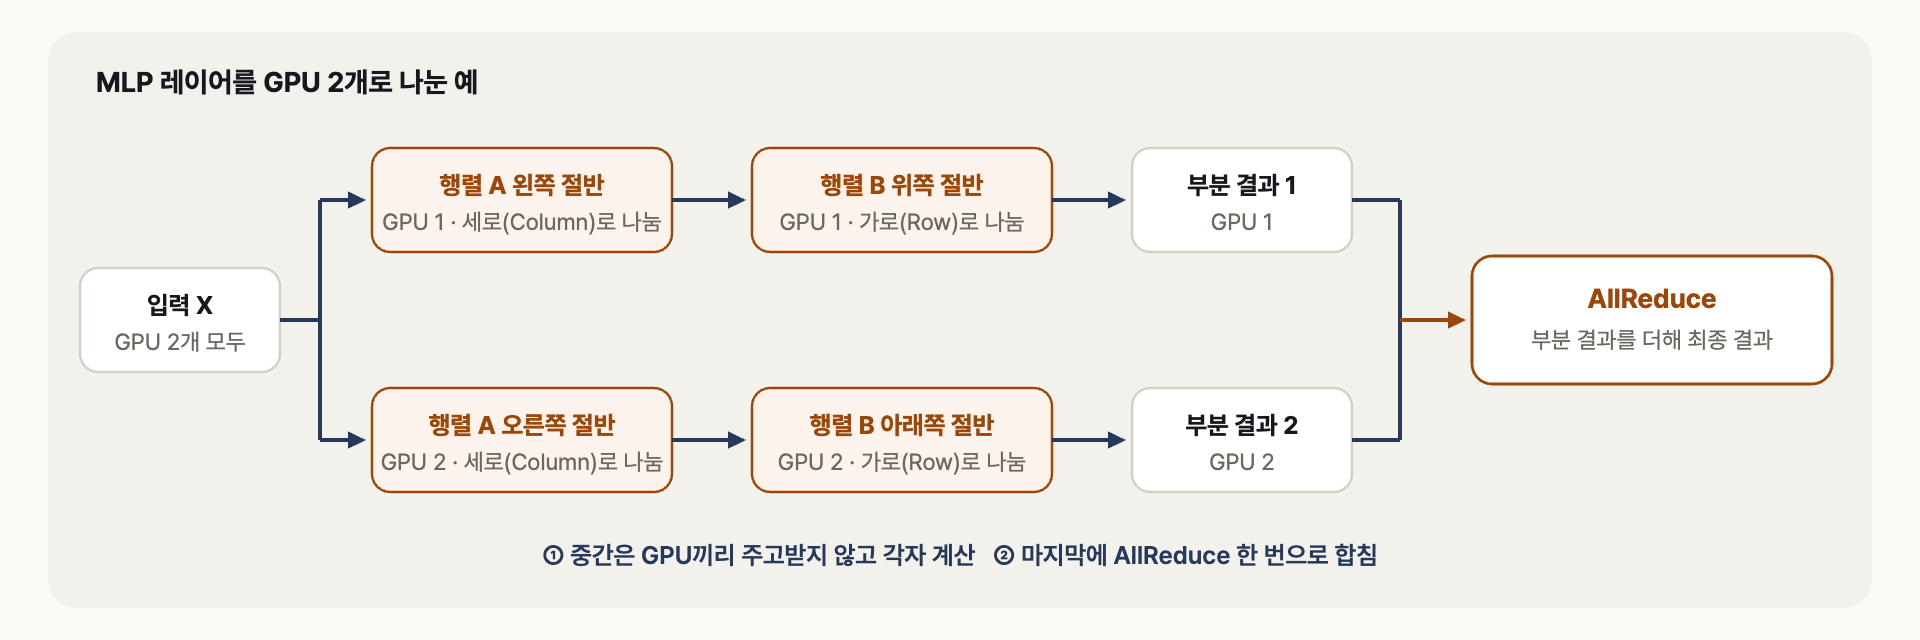
MLP 레이어를 GPU 2개로 나눈 Tensor Parallelism. 중간은 각자 계산하고 마지막에 AllReduce 한 번으로 합침
학습에서는 레이어마다 결과를 합쳐야 해서 레이어 하나에 앞으로 계산(Forward)할 때 2번, 되짚어 계산(Backward)할 때 2번 통신이 생기고, 한 번에 주고받는 양도 큽니다. GPU를 늘려도 통신이 줄지 않고 레이어마다 반복되므로 가장 빠른 연결인 NVLink 안에 두고, HGX 서버에서는 보통 GPU 8개까지 씁니다. Sequence Parallelism은 TP와 함께 쓰는 보조 방식으로, 문장 길이 방향으로 일부 계산을 나눠 중간 결과 메모리를 더 줄입니다.
추론에서는 앞으로 계산(Forward)만 하므로 레이어마다 2번입니다. 답을 한 토큰씩 만드는 Decode 단계는 계산보다 매번 가중치를 메모리에서 읽어 오는 속도가 병목인데, 가중치를 GPU N개에 나누면 N개의 메모리에서 동시에 읽는 셈이라 토큰이 빨리 나옵니다. 다만 작은 데이터를 자주 주고받아 지연이 중요하므로 추론에서도 TP는 NVLink 안에 둡니다.
4. Pipeline Parallelism
Pipeline Parallelism은 레이어를 앞에서부터 몇 구간(Stage)으로 나눠 GPU마다 한 구간씩 맡깁니다. 공장 컨베이어 벨트처럼 앞 GPU가 끝낸 결과를 다음 GPU로 넘기기만 하면 되어 통신이 적습니다.
학습에서는 데이터를 작은 묶음(Micro-batch)으로 잘라 연달아 흘려보내 모든 GPU가 동시에 일하게 합니다. 그래도 벨트가 처음 채워질 때와 마지막에 비워질 때는 노는 GPU가 생기는데, 이를 Bubble이라고 합니다. 구간 수를 p, 작은 묶음 수를 m이라고 하면 노는 시간은 대략 (p-1)/m 비율이라, p가 8이고 m이 64면 약 11%입니다. GPU 하나가 떨어진 구간을 여러 개 맡는 Interleaved 방식으로 줄일 수 있지만 그만큼 주고받는 횟수가 늘어납니다.
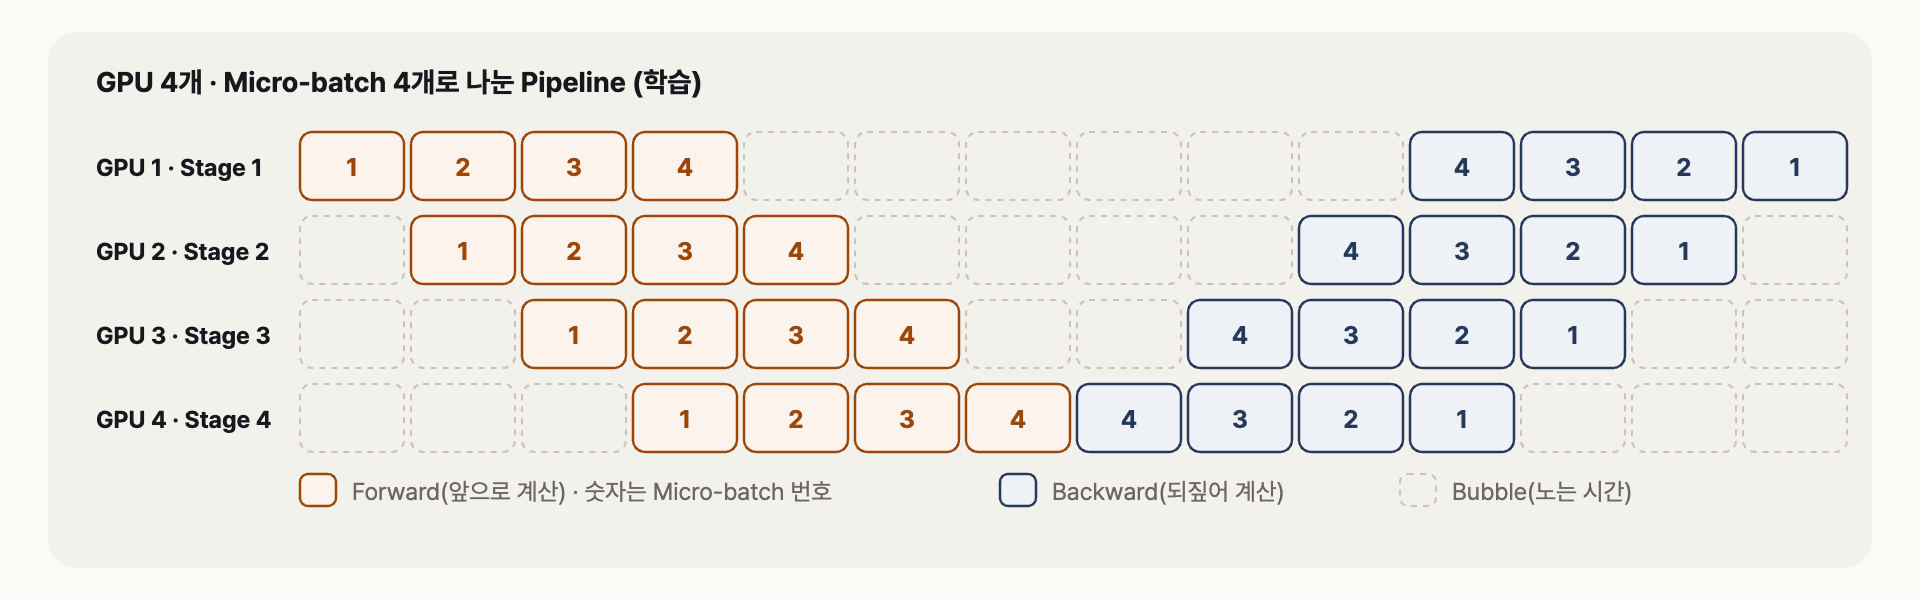
GPU 4개, Micro-batch 4개로 나눈 Pipeline. 점선 칸이 GPU가 노는 Bubble
추론에서는 요청을 연달아 넣으면 벨트가 쉬지 않아 처리량은 유지되지만, 요청 하나는 모든 GPU를 차례로 지나야 하므로 답이 빨라지지는 않습니다. 그래서 추론에서 PP는 모델이 서버 한 대에 다 들어가지 않을 때 서버 여러 대를 잇는 용도로 주로 씁니다. 예를 들어 서버 안에서는 TP 8, 서버 2대 사이는 PP 2로 묶습니다.
5. Expert와 Context Parallelism
MoE 모델은 분야별 전문가(Expert)를 여러 개 두고, 토큰마다 잘 맞는 전문가 몇 명에게만 일을 맡기는 구조입니다. Expert Parallelism은 이 전문가들을 여러 GPU에 나눠 두는 방식이라, MoE 레이어마다 토큰을 담당 전문가가 있는 GPU로 보냈다가 결과를 돌려받는 통신(All-to-All)이 생깁니다. 학습에서는 앞뒤 계산 모두에서 이 통신이 생기고, 특정 전문가에게 일이 몰리지 않도록 고르게 나누는 장치(Load Balancing Loss)를 둡니다. 추론에서는 토큰을 하나 만들 때마다 이 통신이 반복되어 답이 나오는 속도에 바로 영향을 주므로, GPU 72개가 NVLink로 이어진 NVL72 같은 구성이 큰 MoE 모델에 유리합니다.
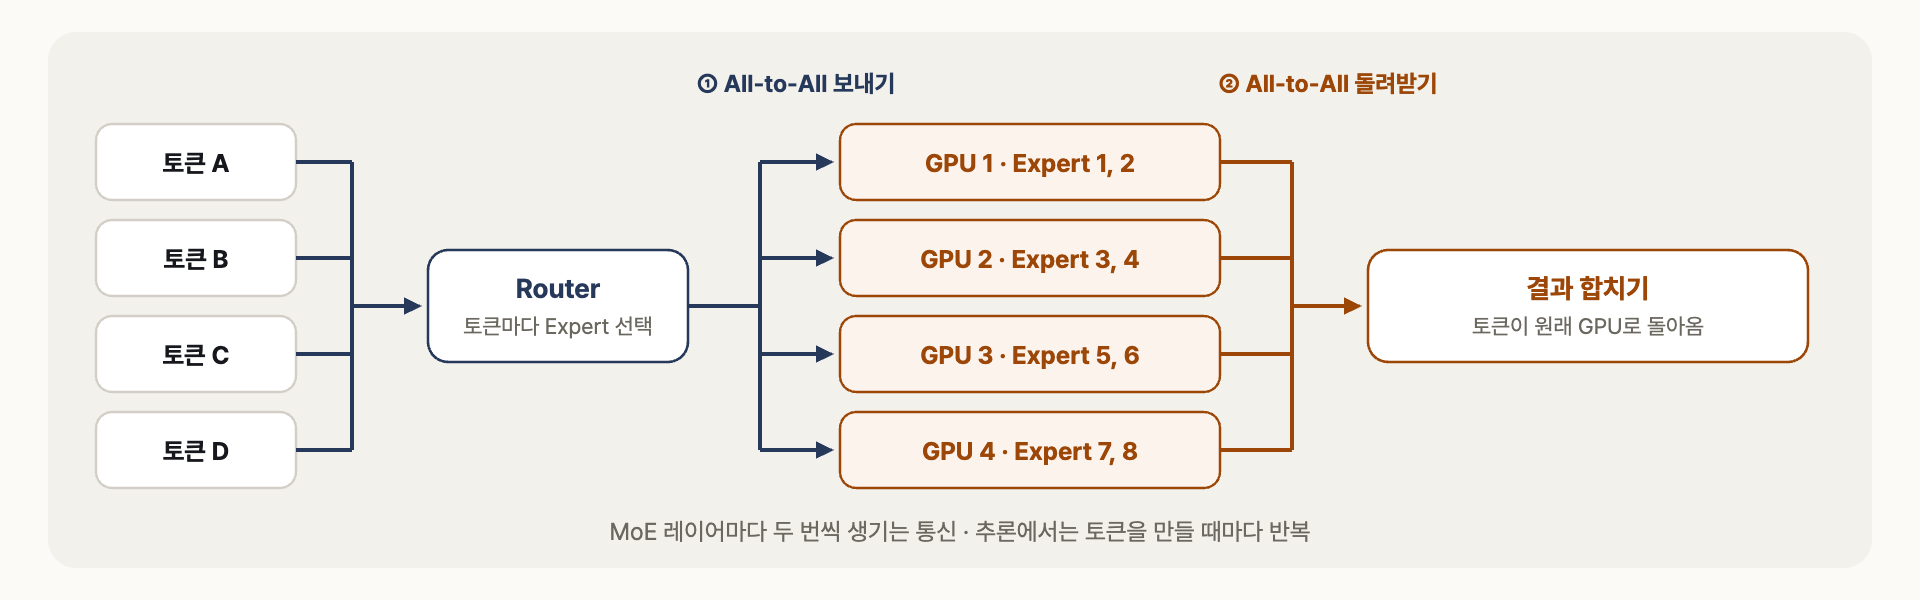
MoE 레이어에서 토큰이 담당 전문가(Expert)가 있는 GPU로 갔다가 돌아오는 두 번의 All-to-All
Context Parallelism은 아주 긴 입력을 구간별로 나눠 여러 GPU가 맡는 방식입니다. Attention은 모든 토큰을 서로 비교해야 하므로 GPU들이 자기 구간의 Key·Value를 고리처럼 돌려 가며 계산합니다(Ring Attention). 학습에서는 긴 문장의 중간 결과 메모리를 나누고, 추론에서는 긴 프롬프트를 처음 읽는 단계(Prefill)를 나눠 첫 답이 나올 때까지의 시간을 줄입니다.
6. 조합과 배치
실제로는 이 방식들을 겹쳐 씁니다. 전체 GPU 수는 TP × PP × CP × DP로 계산하고, EP는 MoE 레이어에서만 DP 쪽 GPU를 나눠 씁니다. 학습 예로 GPU 1,024개를 TP 8 × PP 8 × DP 16으로 나누면, 서버 안 8개가 레이어를 쪼개 계산하고, 서버 8대가 레이어 구간을 나눠 맡고, 이 64개짜리 한 세트를 16세트 돌리는 구조입니다. 추론 예로 70B 모델(FP16)을 GPU 2장에 TP 2로 한 벌 올리고, 이런 한 벌을 8벌 띄우면 GPU 16장으로 서비스합니다.
| 방식 | 학습 | 추론 | 배치 |
| DP | Gradient 계산 분산 | 복제본으로 처리량 확장 | 가장 바깥 |
| TP | 레이어 메모리·연산 분산 | 토큰 지연 단축 | NVLink 안 |
| PP | 레이어 묶음 분산 | 노드 한 대를 넘는 모델 | 노드 사이 |
| EP | MoE Expert 분산 | MoE 모델 서비스 | NVLink 도메인 안이 유리 |
| CP | 긴 시퀀스 Activation 분산 | 긴 프롬프트 Prefill 분산 | NVLink 안 |
추론에서는 프롬프트를 읽는 단계(Prefill)와 답을 한 토큰씩 만드는 단계(Decode)를 서로 다른 GPU에 나누는 방식(Disaggregated Serving)도 씁니다. Prefill은 계산량이, Decode는 메모리 읽기 속도가 병목이라 성격이 달라서, 나누면 각자에 맞게 병렬화를 따로 설정할 수 있습니다. 저는 학습이든 추론이든 병렬화 설정을 볼 때 TP가 NVLink로 묶인 GPU 수를 넘지 않는지부터 확인합니다.
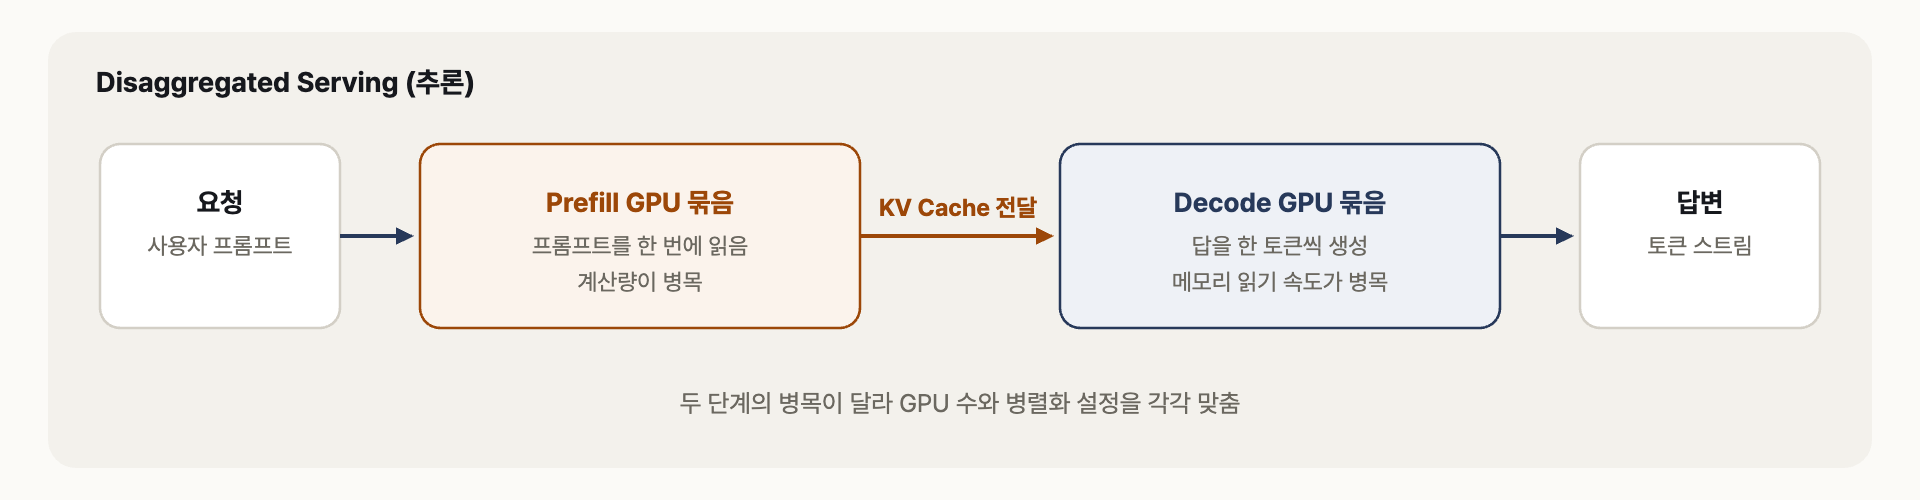
Prefill과 Decode를 서로 다른 GPU 묶음에 나누는 Disaggregated Serving
7. 정리
- 학습은 가중치에 Gradient와 Optimizer 상태까지(파라미터당 약 16바이트), 추론은 가중치와 KV Cache만 GPU에 나눠 올리면 됩니다.
- TP는 레이어마다 결과를 합쳐야 해서 NVLink 안에, PP는 다음 GPU로 넘기기만 하면 되어 서버 사이에 둡니다.
- DP는 학습에서는 데이터를, 추론에서는 요청을 나누고, MoE의 EP는 통신이 많아 NVLink로 묶인 GPU가 많을수록 유리합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [NVIDIA] NVLink와 NVSwitch 차이 정리 (0) | 2026.09.26 |
|---|---|
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] GPU 노드에서 랙까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] AI 인프라 전력·냉각·네트워크 정리 (1) | 2026.09.26 |
| [NVIDIA] DGX와 HGX 사양 비교 (0) | 2026.09.26 |
