GPU 클러스터는 GPU → 노드(서버) → 랙 → SU → 클러스터 순서로 커집니다. 1편은 GPU에서 랙까지를 다룹니다. 서버 안의 GPU 8개는 NVLink라는 전용 고속 도로로 한 방향 900GB/s로 이어지지만, 서버 밖으로는 GPU마다 붙은 800Gb/s(100GB/s) 네트워크 카드로 나가서 속도가 9배 차이 납니다. 이 차이가 클러스터 설계의 출발점입니다.
1. 전체 단계
NVIDIA 권장 구성(DGX SuperPOD B300)을 기준으로 GPU 한 개가 수천 개짜리 클러스터가 되는 과정을 두 편에 나눠 정리합니다. 1편은 NVLink로 묶이는 구간(Scale-up, GPU → 노드 → 랙)이고, 2편은 네트워크로 묶이는 구간(Scale-out, SU → 클러스터)입니다. 제품별 사양은 DGX와 HGX 사양 비교에서 다뤘습니다.
| 단계 | 규모 | 연결 | 비고 |
| GPU | GPU 1개 | GPU 메모리 288GB(HBM3e) | B300 |
| 노드 | GPU 8개 | NVLink Switch, GPU당 1.8TB/s | DGX B300 1대, 약 14.5kW |
| 랙 | GPU 32개 | 노드 사이는 네트워크 | DGX 4대, 50kW 이상 |
| SU | GPU 512개 | 스위치 24대 (Leaf 16, Spine 8) |
DGX 64대(랙 16개) |
| 클러스터 | GPU 2,048개 이상 | SU 여러 개를 상위 스위치로 연결 | 스토리지, 관리망, 작업 배치 도구 추가 |
2. GPU에서 노드까지
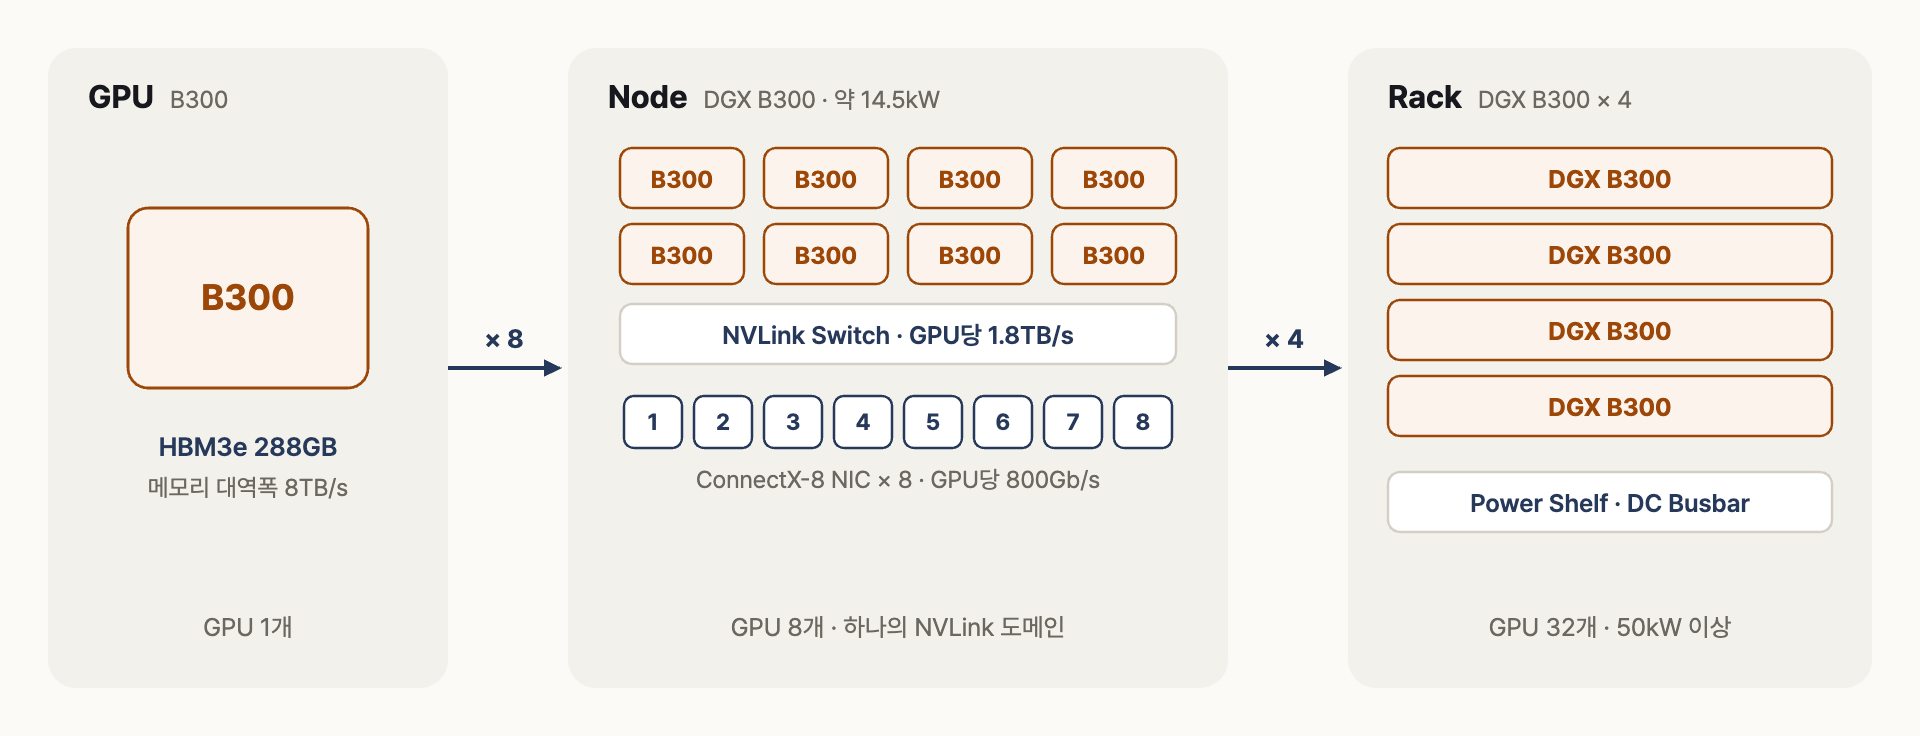
B300 GPU 8개가 NVLink Switch로 묶여 DGX B300 노드가 되고, 노드 4대가 랙 하나에 들어가는 구조
DGX B300 서버 안에서 GPU 8개는 NVLink Switch로 서로 연결됩니다. 서버 밖으로 나가는 포트는 용도별로 나뉘는데, GPU 하나마다 네트워크 카드(ConnectX-8)가 하나씩 짝지어 붙는 것이 핵심입니다. 1번 GPU의 데이터는 1번 카드로, 2번 GPU의 데이터는 2번 카드로 CPU를 거치지 않고 바로 나가며(GPUDirect RDMA), 이 짝이 2편에서 다룰 Rail의 기준이 됩니다.
| 포트 | 수량·속도 | 연결 |
| ConnectX-8 | 8개 × 800Gb/s | 서버 사이 GPU 통신 (Compute Fabric) |
| BlueField-3 DPU | 2개(각 2포트, 최대 400Gb/s) | 스토리지 연결, 사용자·관리 접속 |
| BMC | 1Gb/s | 장비 원격 관리(Out-of-band) |
GPU끼리 주고받는 속도는 서버 안(NVLink 한 방향 900GB/s)과 서버 밖(800Gb/s = 100GB/s)이 9배 차이 납니다. 서버 안이 9차선 고속도로라면 서버 밖은 1차선 도로인 셈이라, 통신이 많은 일은 최대한 서버 안에서 끝내도록 나눕니다. 예를 들어 레이어 하나를 여러 GPU가 쪼개 계산하는 Tensor Parallelism은 NVLink 안에 두고, 서버 사이에는 통신이 적은 Data Parallelism이나 Pipeline Parallelism을 둡니다.
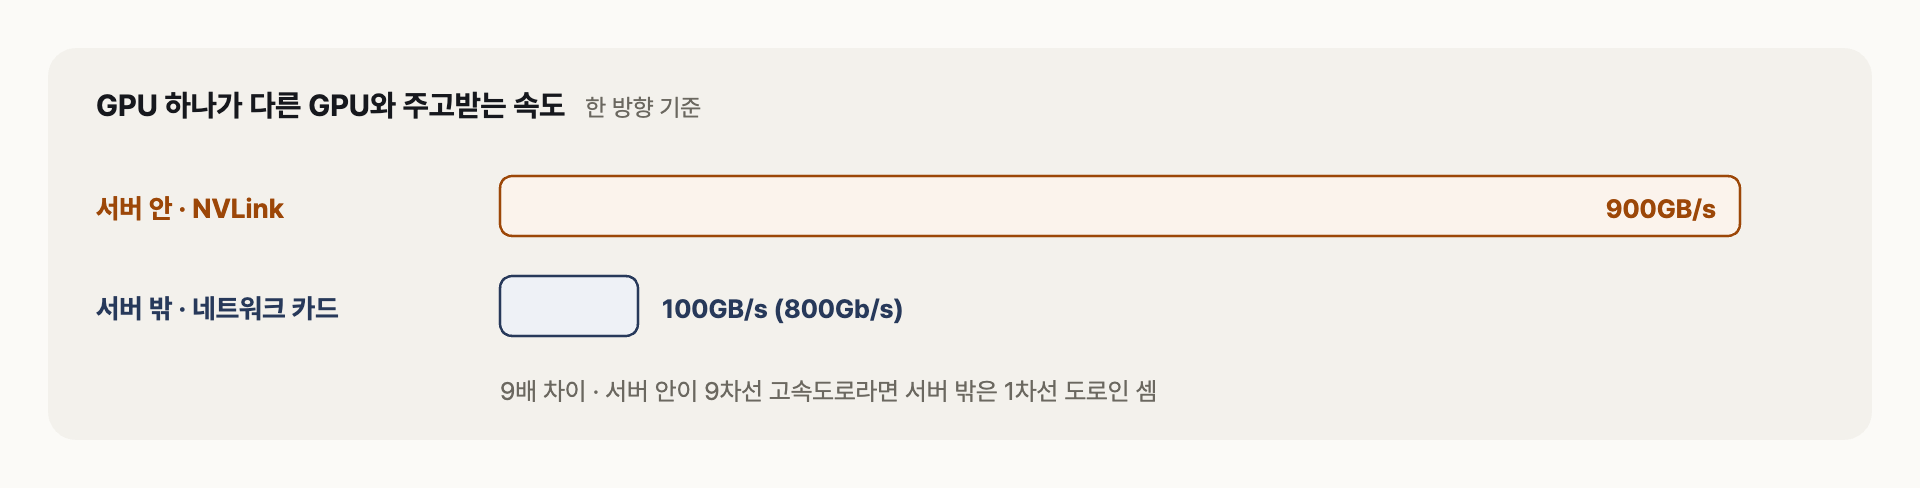
GPU 하나가 다른 GPU와 한 방향으로 주고받는 속도. 서버 안(NVLink)이 서버 밖(네트워크 카드)보다 9배 빠름
3. 노드에서 랙까지
NVIDIA 권장 구성은 DGX B300 4대를 랙 하나에 넣고 랙당 50kW 이상을 잡으며, 서버마다 전원 장치를 두는 대신 랙 단위 전원 장치(Power Shelf)와 전원 막대(Busbar)를 쓰는 MGX 랙을 씁니다. 여기서 중요한 점은 랙에 GPU가 32개 있어도 NVLink로 묶인 범위(NVLink 도메인)는 여전히 서버 한 대(GPU 8개)라는 것입니다. 같은 랙 안의 서버끼리도 네트워크 스위치를 거쳐 통신합니다.
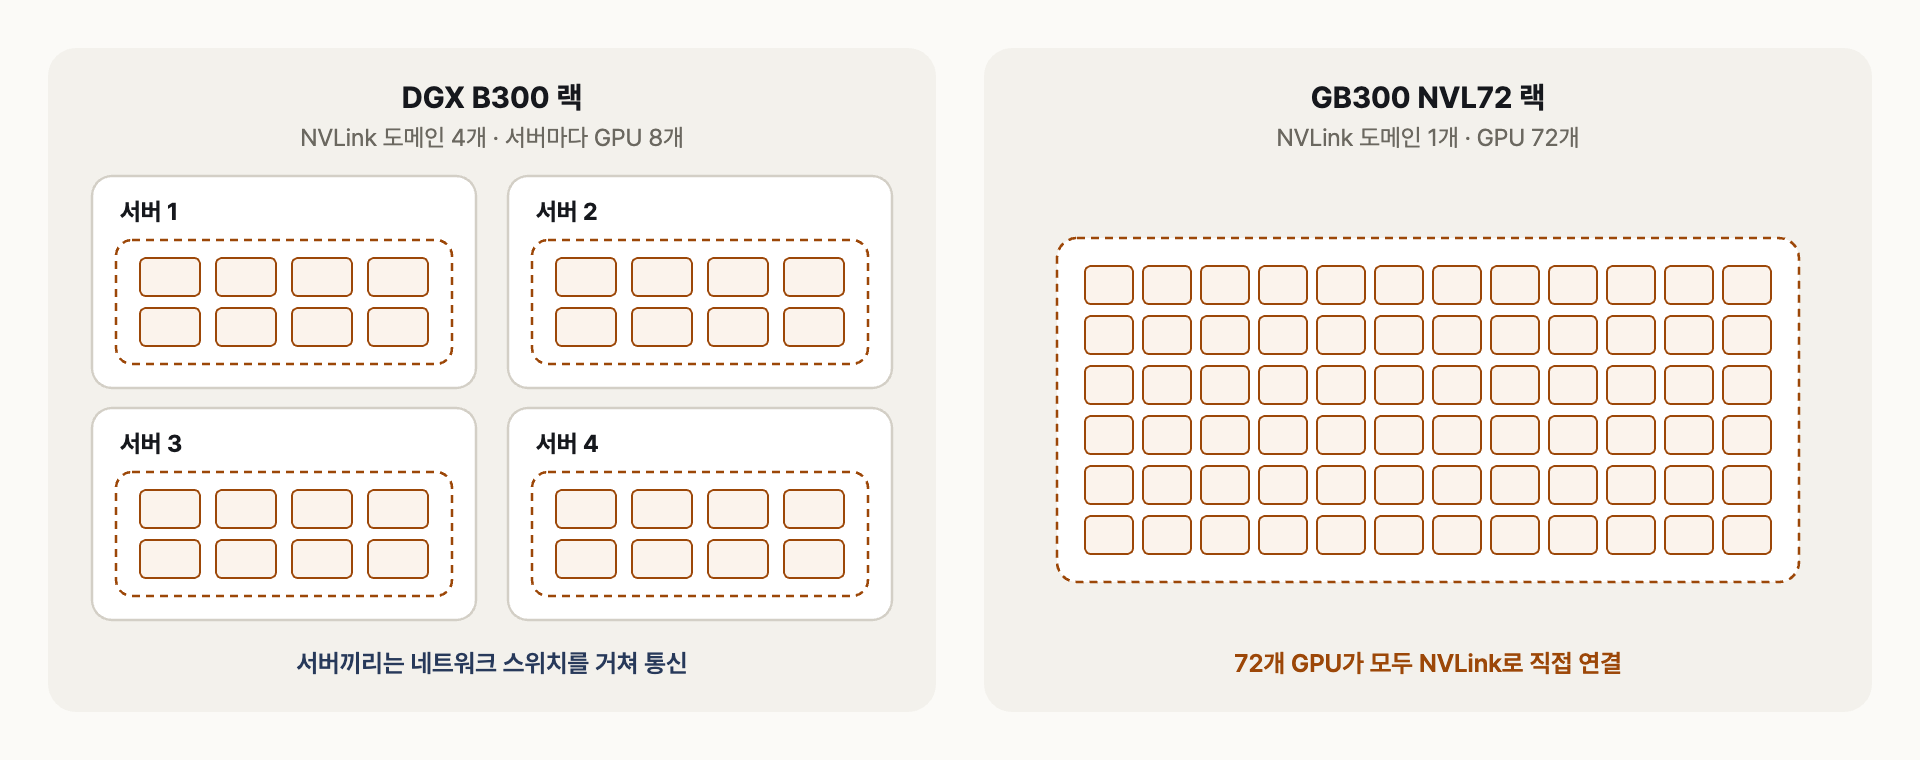
DGX B300 랙은 NVLink 도메인이 서버마다 나뉘고(GPU 8개씩), GB300 NVL72는 랙 전체가 하나의 NVLink 도메인(GPU 72개)
| 항목 | DGX B300 랙 | GB300 NVL72 랙 |
| GPU | 32개(DGX 4대) | 72개 |
| NVLink 도메인 | 노드 단위, GPU 8개 | 랙 단위, GPU 72개 |
| 랙 전력 | 50kW 이상 | 약 150kW (SU 8랙 1.2MW 기준) |
| 냉각 | 공랭 | 수냉 |
| SU 구성 | DGX 64대, GPU 512개 | 랙 8개, GPU 576개 |
GB300 NVL72는 이 경계를 랙 전체로 넓힌 구조입니다. GPU 72개가 한 NVLink 도메인이라 레이어를 쪼개는 계산(Tensor Parallelism)이나 MoE 모델의 전문가 간 통신을 72개 GPU 안에서 빠른 길로 끝낼 수 있습니다. 대신 랙 하나가 150kW 안팎을 쓰고 물로 식혀야 해서, 어느 쪽을 고를지는 모델 크기와 데이터센터 조건에 따라 정합니다.
4. 병렬화 방식과 통신
모델 하나를 여러 GPU에 나누는 방법은 크게 네 가지이고, 방식마다 주고받는 양과 횟수가 다릅니다. 앞에서 본 9배 속도 차이 때문에 자주 주고받는 방식은 NVLink 안에, 가끔 주고받는 방식은 서버 사이에 둡니다(방식별 자세한 설명은 학습과 추론의 GPU 병렬화 방식 정리에서 다뤘습니다).
| 방식 | 나누는 대상 | 통신 | 배치 |
| Data Parallelism | 학습 데이터(배치) | 학습 단계마다 결과 합치기(AllReduce) | 노드 사이 |
| Tensor Parallelism | 레이어 안의 행렬 | 레이어마다 결과 합치기, 가장 잦음 | NVLink 도메인 안 |
| Pipeline Parallelism | 레이어 구간(Stage) | 다음 구간으로 중간 결과 전달 | 노드 사이 |
| Expert Parallelism | MoE 모델의 전문가(Expert) | 토큰마다 전문가 GPU와 주고받기(All-to-All) | NVLink 도메인 안이 유리 |
큰 모델은 이 방식을 섞어 씁니다. 예를 들어 서버 안 GPU 8개가 레이어를 쪼개 계산하고(TP), 서버 여러 대가 레이어 구간을 나눠 맡고(PP), 그 묶음 전체를 여러 벌 복제합니다(DP). NVLink 도메인이 GPU 8개인 DGX는 TP를 보통 8까지만 쓰지만, GPU 72개가 한 도메인인 NVL72는 TP와 EP를 더 크게 잡을 수 있어 큰 MoE 모델에 유리합니다.
5. 정리
- 서버 안 GPU 8개는 NVLink(한 방향 900GB/s)로, 서버 밖은 GPU마다 붙은 800Gb/s 네트워크 카드로 연결되어 속도가 9배 차이 납니다.
- DGX B300 랙은 서버 4대(GPU 32개), 50kW 이상이지만 NVLink로 묶인 범위는 서버 한 대입니다.
- GB300 NVL72는 NVLink 도메인을 랙(GPU 72개)으로 넓힌 대신 랙당 150kW 안팎과 수냉이 필요합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (1) | 2026.09.26 |
|---|---|
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] AI 인프라 전력·냉각·네트워크 정리 (1) | 2026.09.26 |
| [NVIDIA] DGX와 HGX 사양 비교 (0) | 2026.09.26 |
| [AI] AI 인프라를 위한 GPU 개념 정리 (0) | 2026.09.26 |
