랙을 넘어서면 GPU는 네트워크로 연결됩니다. NVIDIA 권장 구성(DGX SuperPOD B300)은 서버 64대(GPU 512개)를 한 묶음(SU)으로 만들고, 모든 서버의 같은 번호 GPU를 같은 스위치에 모으는 Rail-optimized 방식으로 연결합니다. 묶음을 늘리면 스위치와 케이블도 같은 비율로 늘고, 여기에 스토리지, 관리망, 작업 배치 도구가 붙어야 클러스터가 완성됩니다.
1. SU와 Rail-optimized 구조
1편에서 GPU 8개가 서버가 되고 서버 4대가 랙이 되는 과정까지 봤습니다. 2편은 그다음 단계인 SU(Scalable Unit, 확장 단위)부터입니다. SuperPOD B300의 SU는 DGX B300 64대, 랙으로는 16개이고, GPU 512개가 서버 사이 네트워크(Compute Fabric) 하나로 묶입니다.
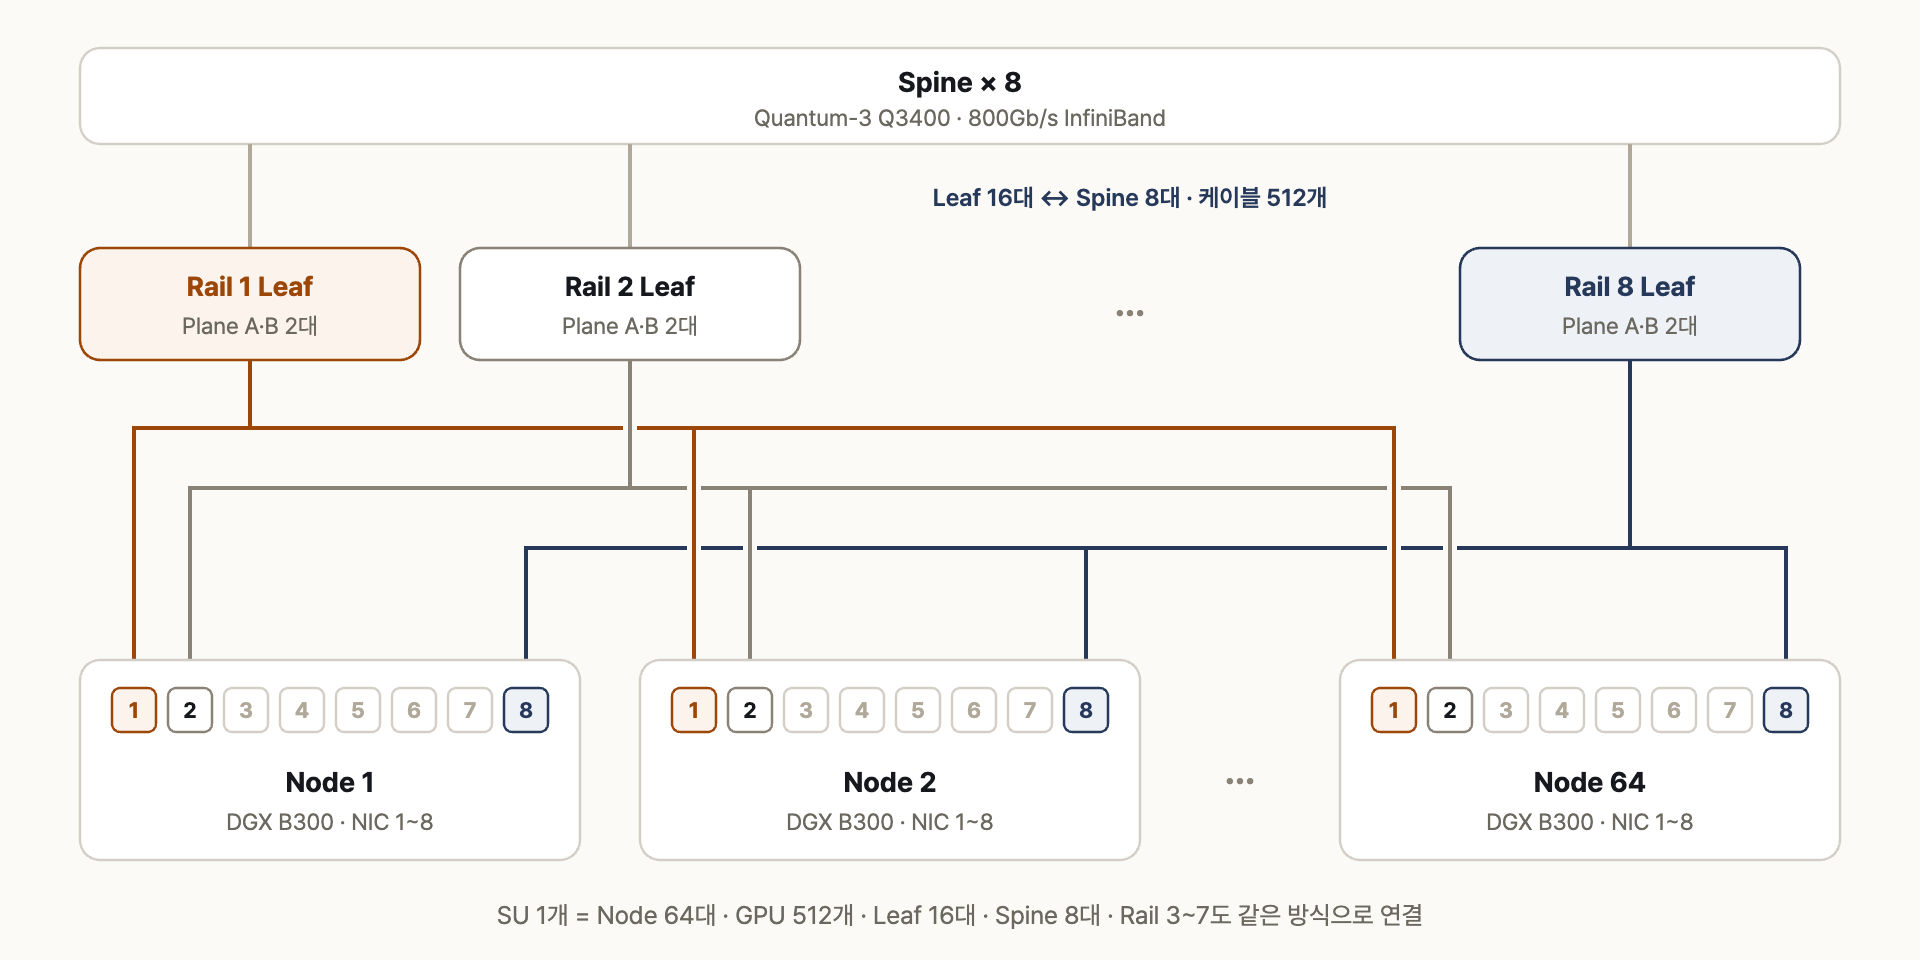
모든 노드의 NIC 1번은 Rail 1 Leaf로, NIC 8번은 Rail 8 Leaf로 모이고 Leaf는 Spine으로 연결되는 구조
Rail-optimized는 모든 서버의 1번 GPU 네트워크 카드를 Rail 1 스위치(Leaf)에, 2번 카드를 Rail 2 스위치에 모으는 방식입니다. 기차 선로(Rail)처럼 번호마다 전용 길을 까는 셈입니다. 분산 학습에서 결과를 합치는 통신(AllReduce)은 주로 같은 번호 GPU끼리 일어나기 때문에, 이 통신이 위층 스위치(Spine)까지 올라가지 않고 Leaf 한 단계에서 끝납니다. 다른 번호 GPU로 보낼 데이터는 서버 안에서 먼저 NVLink로 해당 번호 GPU에 옮긴 뒤 보냅니다(NCCL의 PXN 기능).
SuperPOD B300은 여기에 Twin-plane을 더합니다. GPU마다 400Gb/s 연결 두 개가 서로 다른 스위치 계층(Plane)으로 나가서, 스위치나 케이블 하나가 고장 나도 작업이 멈추지 않고 절반 속도로 계속 돌아갑니다. Rail 8개가 Plane마다 따로 있어서 SU 하나의 Leaf 스위치는 16대입니다.
2. SU를 늘릴 때
서버 사이 네트워크는 800Gb/s InfiniBand 스위치(Quantum-3 Q3400)로 만든 Non-blocking Fat Tree입니다. Non-blocking은 모든 서버가 동시에 최대 속도로 통신해도 중간에 막히는 곳이 없다는 뜻입니다. SU를 늘리면 스위치와 케이블이 SU 수에 비례해서 늘어납니다.
| SU | 서버 | GPU | Leaf | Spine | 서버-Leaf 케이블 | Leaf-Spine 케이블 |
| 1 | 64 | 512 | 16 | 8 | 512 | 512 |
| 2 | 128 | 1,024 | 32 | 16 | 1,024 | 1,024 |
| 4 | 256 | 2,048 | 64 | 32 | 2,048 | 2,048 |
| 8 | 512 | 4,096 | 128 | 64 | 4,096 | 4,096 |
| 16 | 1,024 | 8,192 | 256 | 128 | 8,192 | 8,192 |
서버-Leaf와 Leaf-Spine 케이블 수가 같은 것은 아래에서 들어오는 만큼 위로 올라가는 길을 똑같이 만들어 둔 Non-blocking 구조이기 때문입니다. GPU 2,048개(SU 4개)만 해도 서버 사이 네트워크 케이블이 4,096개라, 저는 이 규모에서는 GPU보다 케이블 설계와 포트 연결 검증이 더 큰 일이라고 봅니다. GB300 NVL72로 만든 SuperPOD는 랙 8개(GPU 576개)가 SU 하나이고 SU당 Leaf가 8대입니다.
3. 클러스터를 완성하는 나머지
서버 사이 네트워크만으로는 클러스터가 되지 않습니다. 학습 데이터와 중간 저장본(체크포인트)을 읽고 쓰는 스토리지 네트워크, 사용자와 작업 배치 도구가 쓰는 관리 네트워크, 장비 전원·상태를 원격으로 관리하는 네트워크(Out-of-band)가 따로 필요합니다.
| 구분 | 구성 | 용도 |
| Storage Fabric | QM9700 NDR 400Gb/s InfiniBand 또는 SN5610 Ethernet |
학습 데이터 읽기, 체크포인트 저장 |
| In-band 관리 | SN5610·SN5600D Ethernet | 작업 배치 도구(스케줄러), 공용 폴더(NFS), 사용자 접속 |
| Out-of-band 관리 | SN2201 1Gb/s Ethernet | 서버 원격 관리(BMC), 스위치 관리 포트 |
| 관리 노드 | 별도 관리 랙 | 스케줄러, InfiniBand 관리 도구(UFM), 모니터링 |
작업 배치는 대규모 학습이면 Slurm, 추론과 서비스 위주면 Kubernetes를 많이 씁니다. 여러 사람이 GPU를 나눠 쓰도록 작업 순서를 정하고 빈 GPU에 배치해 주는 도구입니다. DGX 기반 클러스터는 NVIDIA Mission Control로 서버 상태, 작업, 장애 복구를 함께 관리합니다.
4. AllReduce 알고리즘
AllReduce는 모든 GPU가 계산한 결과(Gradient)를 더한 뒤, 그 합계를 다시 모든 GPU에 나눠 주는 통신입니다. 반 학생 모두의 점수를 더해 합계를 모두에게 알려 주는 것과 같습니다. NCCL(GPU 통신 라이브러리)은 GPU 수와 데이터 크기에 따라 방법을 고르고, 스위치가 더하기를 대신해 주는 방법도 있습니다.
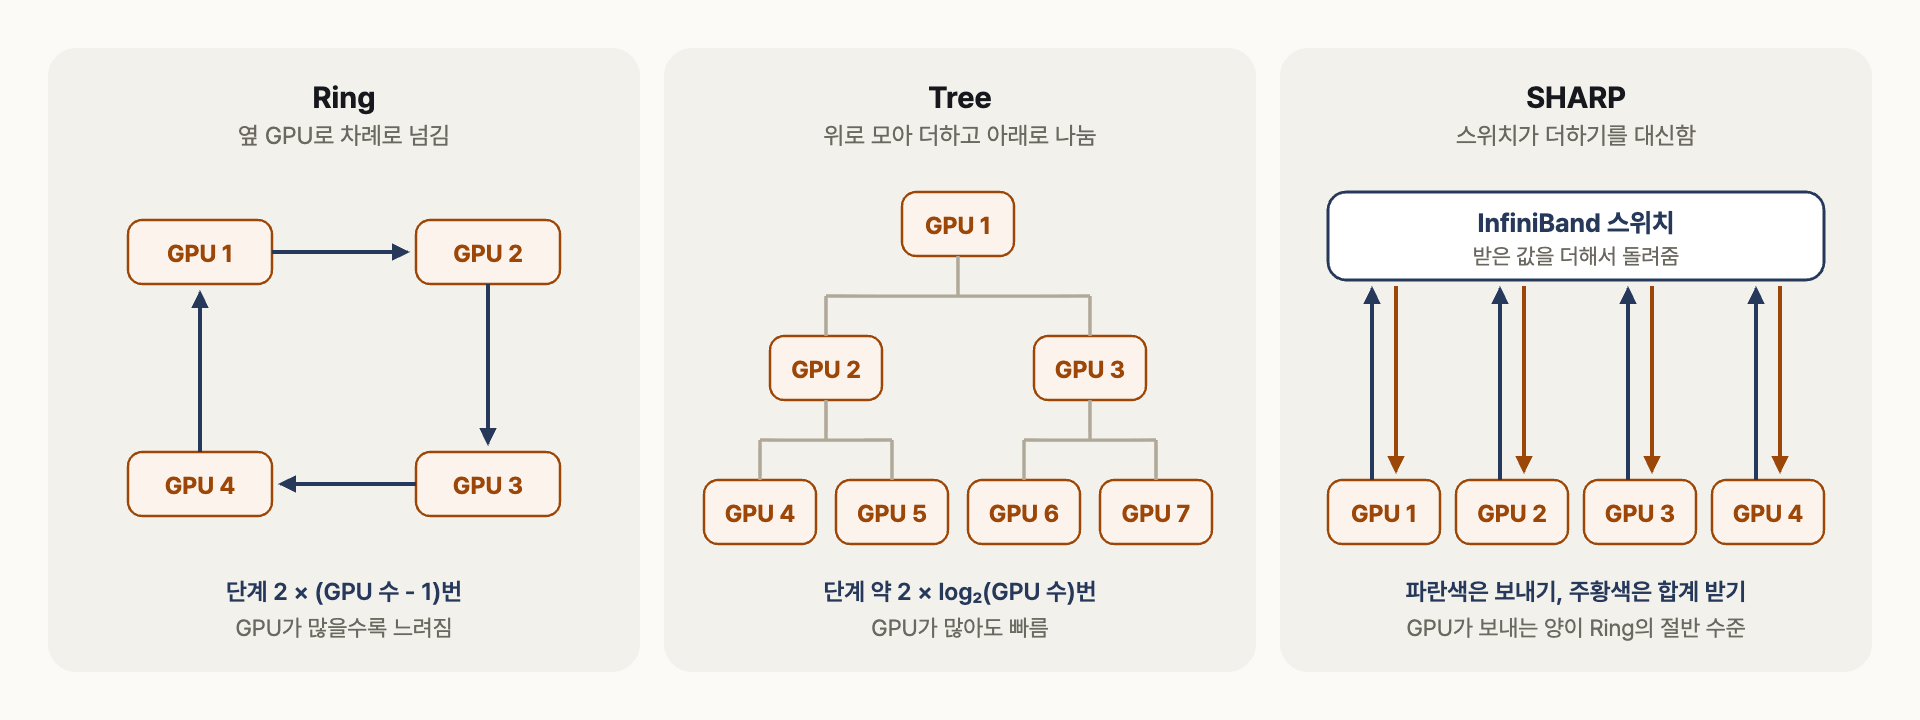
AllReduce를 하는 세 가지 방법. Ring은 옆 GPU로 차례로 넘기고, Tree는 위로 모아 더한 뒤 아래로 나눠 주고, SHARP는 스위치가 대신 더해 줌
| 방식 | 동작 | 특징 |
| Ring | GPU를 고리로 이어 데이터 조각을 차례로 넘김 | 대역폭 효율이 좋지만 GPU가 많으면 지연이 길어짐 |
| Tree | GPU를 트리로 묶어 위로 더하고 아래로 나눔 | 단계 수가 적어(GPU 1,024개도 약 10단계) GPU가 많아도 지연이 짧음 |
| SHARP | InfiniBand 스위치가 더하기를 직접 수행 | GPU가 한 번만 보내면 되어 네트워크 데이터가 Ring의 절반 수준 |
| NVLink SHARP | NVLink Switch가 서버·랙 안에서 더하기 수행 | NVLink로 묶인 GPU끼리의 AllReduce를 가속 |
Ring 방식에서 GPU 하나가 보내는 양은 GPU 수와 관계없이 전체 데이터의 약 2배로 일정해서 네트워크 속도는 잘 활용합니다. 대신 옆 GPU로 차례로 넘기는 단계가 GPU 수만큼 늘어나서(2 × (GPU 수 - 1)번), GPU가 수천 개가 되면 지연이 커지고 이때 Tree나 SHARP가 유리합니다. Rail-optimized 구조에서는 이 통신 대부분이 같은 Rail 안에서 끝나서 Spine까지 올라가지 않습니다.
5. 운영 시 주의점
| 항목 | 조치 |
| 포트 매핑 | 네트워크 카드 번호와 Rail 스위치가 어긋나게 꽂히면 성능이 크게 떨어지므로 설치 후 자동 검증 도구로 전수 확인합니다. |
| 증설 | SU 단위로 늘어나므로 처음부터 Spine 포트와 케이블 경로를 목표 규모에 맞춰 잡습니다. |
| 장애 | Twin-plane이라 링크 하나가 끊겨도 작업은 계속되지만, 대역폭이 절반이 되므로 알림을 걸어 둡니다. |
| 스토리지 | 학습 중간 저장(체크포인트)을 하는 동안 학습이 멈출 수 있으므로 GPU 수에 맞춰 스토리지 쓰기 속도를 계산합니다. |
6. 정리
- SuperPOD B300의 SU는 서버 64대(GPU 512개)이고, 같은 번호 GPU를 같은 스위치에 모으는 Rail-optimized 방식으로 Leaf 16대와 Spine 8대를 씁니다.
- 같은 번호 GPU끼리의 통신은 스위치 한 단계에서 끝나고, SU를 늘리면 스위치와 케이블이 비례해서 늘어납니다.
- 스토리지, 관리 네트워크, 작업 배치 도구까지 붙어야 운영할 수 있는 클러스터가 됩니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (1) | 2026.09.26 |
|---|---|
| [NVIDIA] GPU 노드에서 랙까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] AI 인프라 전력·냉각·네트워크 정리 (1) | 2026.09.26 |
| [NVIDIA] DGX와 HGX 사양 비교 (0) | 2026.09.26 |
| [AI] AI 인프라를 위한 GPU 개념 정리 (0) | 2026.09.26 |
