GPU 8개 서버는 한 대가 10~14kW, GB300 NVL72는 랙 하나가 130kW 안팎의 전력을 씁니다. 그래서 AI 인프라는 GPU를 고르기 전에 전기를 얼마나 끌어올 수 있는지, 열을 어떻게 뺄지, GPU끼리 어떻게 연결할지부터 확인해야 합니다. 바람으로 식히는 DGX B300은 랙당 4대(50kW 이상)가 NVIDIA 권장 구성이고, NVL72부터는 물로 식히는 수냉이 필요합니다.
1. 전력
GPU 서버가 쓰는 전력은 GPU 전력만 더한 값보다 큽니다. CPU, 네트워크 카드, NVLink Switch, 팬, 그리고 전기를 바꾸는 과정의 손실까지 더해지기 때문에, 전력 계획은 GPU가 아니라 서버 전체의 최대 전력을 기준으로 잡습니다(서버별 사양은 DGX와 HGX 사양 비교에서 다뤘습니다).
| 구분 | 최대 전력 | 전원 공급 |
| DGX H100·H200 | 10.2kW | 3.3kW 전원 장치(PSU) × 6 (2개가 고장 나도 동작) |
| DGX B300 | 약 14.5kW | 3.2kW PSU × 12 또는 랙 전원 막대(Busbar) |
| GB300 NVL72 | 랙당 약 130~140kW | 랙 전원 장치(Power Shelf)에서 한 번에 DC로 바꿔 Busbar로 공급 |
NVIDIA 권장 구성(DGX SuperPOD B300)은 DGX B300 4대를 랙 하나에 넣고 랙당 50kW 이상을 잡습니다. 계산하면 4 × 14.5kW = 58kW입니다. 보통 서버 랙이 10kW 안팎으로 설계되는 것을 생각하면, 기존 전산실에 GPU 서버를 들일 때는 랙당 1~2대씩 나눠 넣거나 전력 증설부터 검토해야 합니다.
2. 냉각
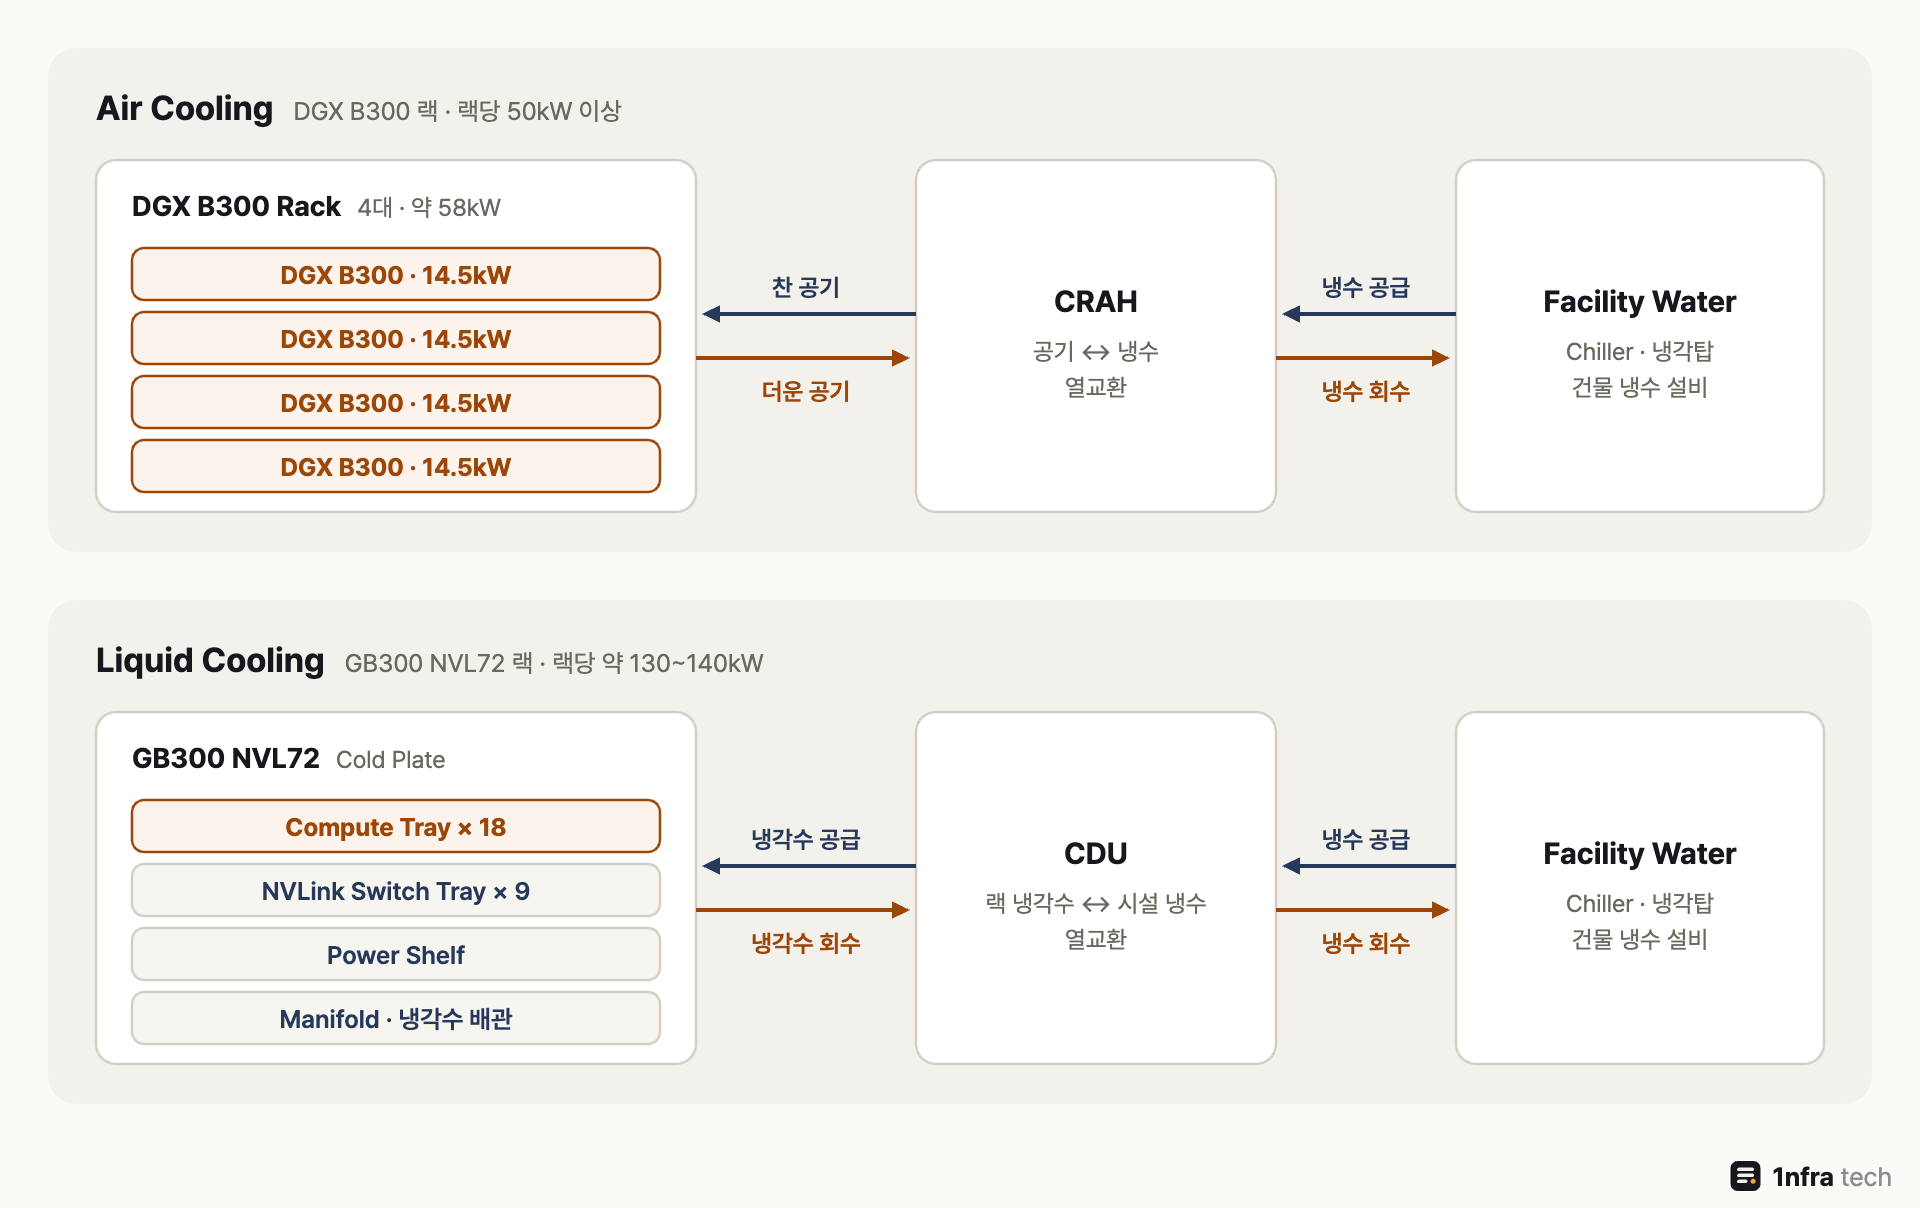
공랭 DGX B300 랙은 CRAH의 찬 공기로, 수냉 GB300 NVL72 랙은 CDU와 시설 냉각수로 열을 빼는 구조
| 방식 | 대상 | 특징 |
| 공랭 | DGX H100~B300 | 기존 전산실 구조를 그대로 쓰지만 랙 밀도가 낮아 공간을 많이 씀 |
| Rear Door Heat Exchanger | 고밀도 공랭 랙 | 랙 뒷문에 물이 흐르는 라디에이터를 달아 더운 공기를 바로 식힘 |
| Direct-to-Chip 수냉 | GB200·GB300 NVL72, Vera Rubin |
GPU·CPU 위에 붙인 금속판(Cold Plate)에 냉각수를 흘려 열을 뺌, CDU 필요 |
수냉은 자동차 라디에이터와 비슷합니다. CDU(Coolant Distribution Unit)는 랙 안을 도는 냉각수와 건물 쪽 냉각수 사이에서 열만 넘겨주는 장비로, 두 물이 섞이지 않게 열교환기로 나눠 둡니다. 랙 안에 넣기도 하고, 여러 랙이 함께 쓰는 CDU를 랙 줄 사이에 두기도 합니다. Vera Rubin NVL72는 45°C의 따뜻한 물로도 식힐 수 있게 설계되어, 전기를 많이 쓰는 냉동기(Chiller) 대신 냉각탑 위주로 운영할 여지가 커졌습니다.
3. 네트워크
GPU 클러스터 네트워크는 서버·랙 안에서 GPU를 묶는 빠른 길(NVLink, Scale-up)과 서버끼리 묶는 길(Compute Fabric, Scale-out)로 나뉩니다. 여기에 데이터를 읽고 쓰는 스토리지 네트워크와 관리용 네트워크가 따로 붙어, 서버 한 대에 용도가 다른 네트워크가 여러 개 연결됩니다.
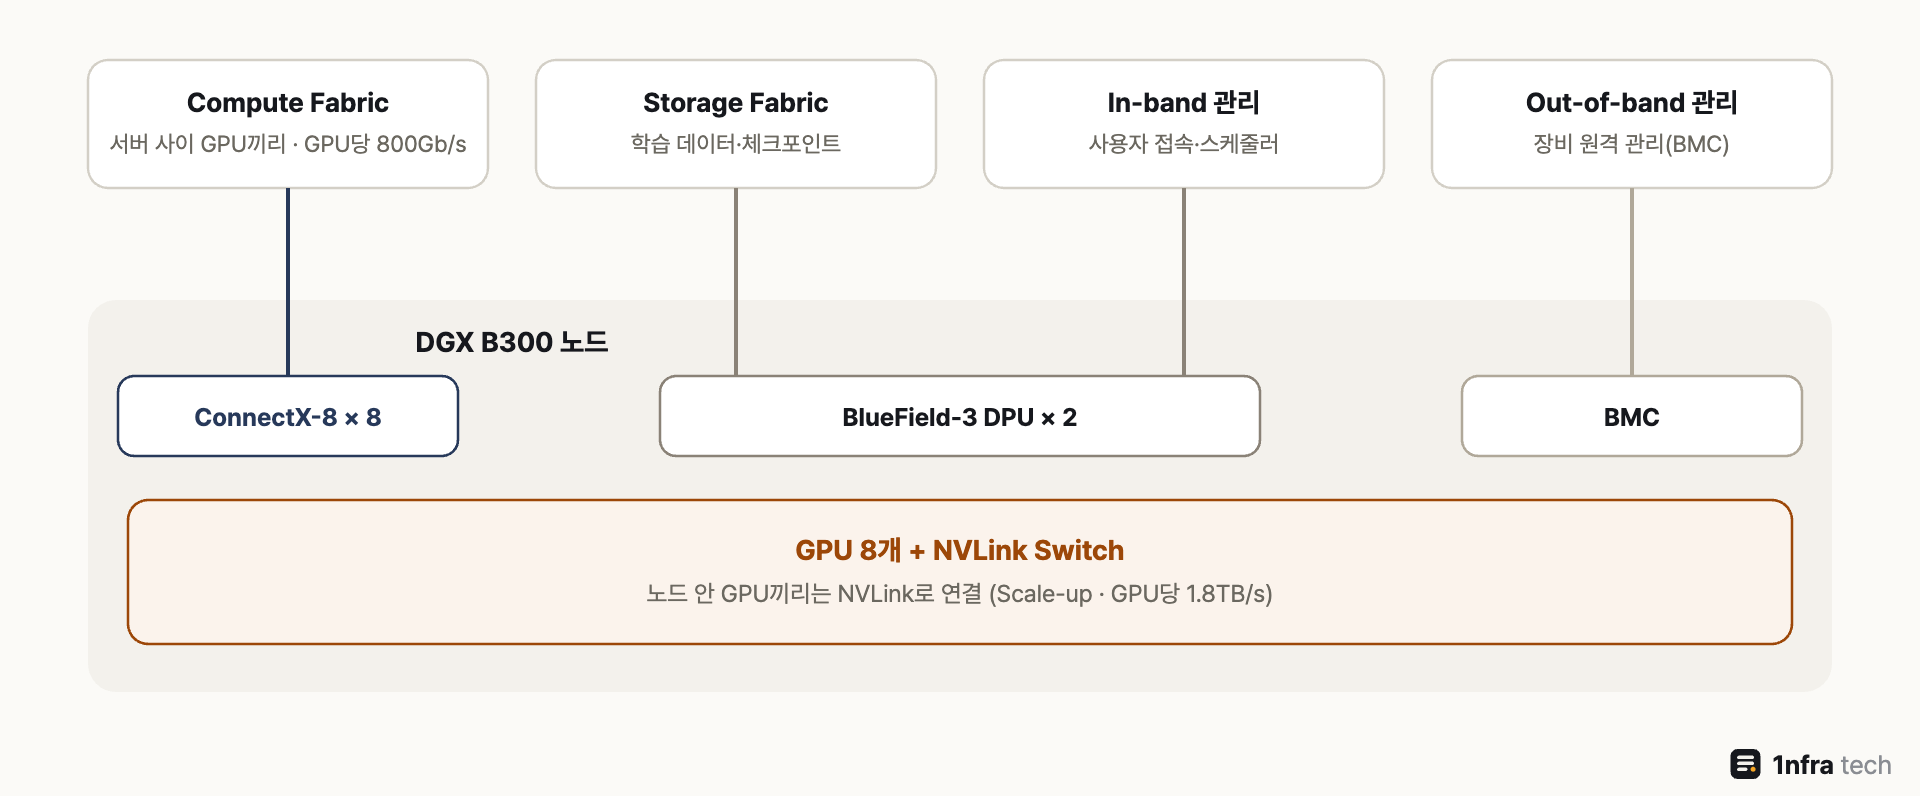
DGX B300 노드 한 대가 용도에 따라 네 가지 네트워크에 연결되는 구조
| 구분 | 연결 대상 | 기술 | 속도 |
| NVLink | 서버·랙 안 GPU끼리 | NVLink 5, NVLink Switch | GPU당 1.8TB/s |
| Compute Fabric | 서버 사이 GPU끼리 | Quantum-X800 InfiniBand, Spectrum-X Ethernet |
GPU당 800Gb/s |
| Storage Fabric | 서버 ↔ 스토리지 | BlueField-3 DPU, InfiniBand 또는 Ethernet |
포트당 400Gb/s |
| In-band 관리 | 클러스터 서비스, 사용자 접속 | Ethernet | 200Gb/s |
| Out-of-band 관리 | 장비 원격 관리(BMC), 스위치 관리 포트 |
Ethernet | 1Gb/s |
서버 사이 네트워크(Compute Fabric)는 Rail-optimized 구조로 연결합니다. 모든 서버의 1번 GPU 네트워크 카드는 1번 스위치에, 2번은 2번 스위치에 모으는 방식이라, 같은 번호 GPU끼리 주고받는 학습 통신이 스위치 한 단계 안에서 끝납니다. NVIDIA 권장 구성은 DGX B300 64대(GPU 512개)를 한 묶음(SU, Scalable Unit)으로 만들고 묶음을 늘려 확장합니다(자세한 구조는 GPU 랙에서 클러스터까지 구성 정리에서 다뤘습니다).
4. 전력 효율
데이터센터가 전기를 얼마나 알뜰하게 쓰는지는 PUE(Power Usage Effectiveness)로 봅니다. 건물 전체 전력을 IT 장비 전력으로 나눈 값이라 1.0에 가까울수록 냉각과 전원 변환에 새는 전력이 적다는 뜻입니다. 예를 들어 PUE 1.5면 서버가 100을 쓸 때 냉각 등에 50을 더 쓰는 것이고, GPU 랙은 서버 전력 자체가 커서 PUE가 조금만 나빠도 추가로 드는 전력이 크게 늘어납니다.
| 항목 | 공랭 | 수냉 |
| 열 전달 | 공기, 서버 팬 | 냉각수, Cold Plate |
| 랙 밀도 | 수십 kW가 현실적 한계 | 100kW 이상 |
| 팬 전력 | 큼 | 작음(남는 열만 공기로) |
| 냉각수 온도 | 낮은 온도의 냉수 필요 | 따뜻한 물(45°C급)도 가능 |
| 운영 | 기존 전산실 방식 | CDU, 배관, 누수 관리 필요 |
전원 쪽에서는 전기를 몇 번 바꾸느냐가 손실을 좌우합니다. 건물로 들어온 전기는 UPS, PDU, 서버 전원 장치(PSU)를 거치며 AC와 DC 사이를 여러 번 바뀌고, 바뀔 때마다 조금씩 열로 새어 나갑니다. MGX 랙은 서버마다 있던 PSU를 랙 단위 Power Shelf로 모아 효율이 높은 대용량 장치로 한 번에 DC로 바꾸고, 랙 뒤의 전원 막대(Busbar)로 서버에 나눠 줍니다.
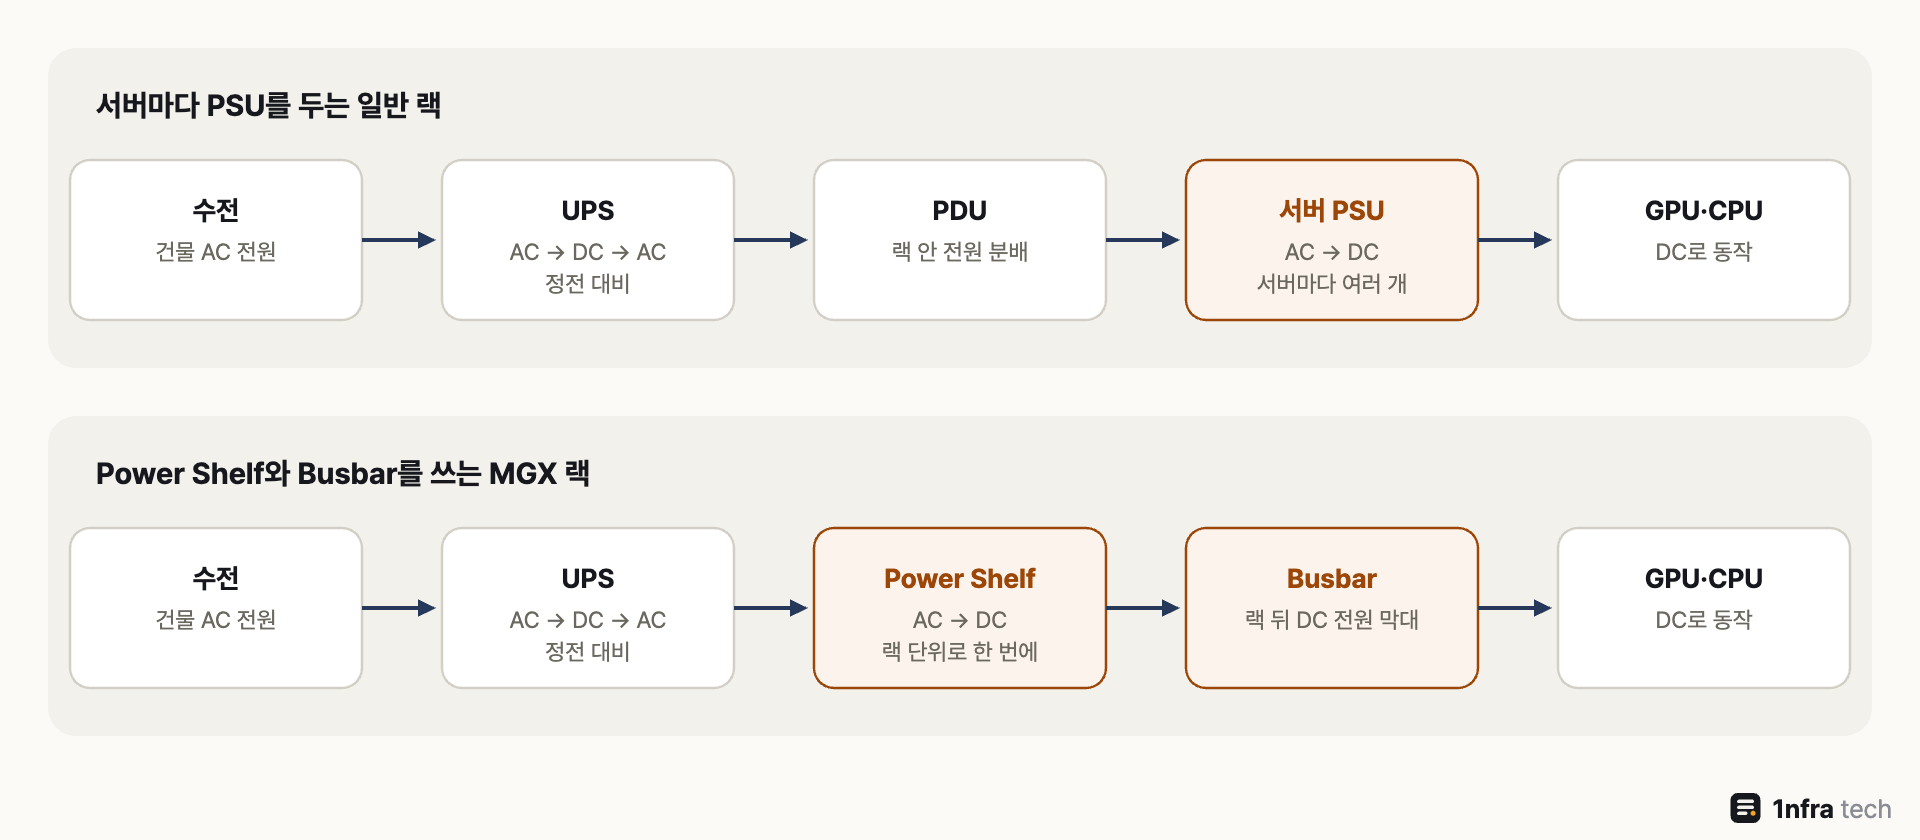
서버마다 PSU를 두는 일반 랙과, Power Shelf에서 한 번에 DC로 바꿔 Busbar로 나눠 주는 MGX 랙의 전원 경로
5. 도입 시 주의점
| 항목 | 조치 |
| 랙 전력 | 서버 최대 전력 기준으로 랙 전원 분배기(PDU)와 차단기 용량을 잡고, 전원 이중화까지 포함해 계산합니다. |
| 바닥 하중 | DGX B300 한 대가 최대 168kg이고 NVL72 랙은 훨씬 무거우므로 바닥 하중을 확인합니다. |
| 냉각 방식 | NVL72부터는 수냉이 필수이므로 CDU 위치, 배관, 냉각수 온도 조건을 먼저 확인합니다. |
| 케이블 | GPU마다 800Gb/s 케이블이 필요해 DGX 256대만 해도 서버와 스위치를 잇는 케이블이 2,048개입니다. |
6. 정리
- 전력은 시스템 최대 전력 기준으로 잡고, DGX B300은 랙당 4대에 50kW 이상이 참조 구성입니다.
- 바람으로 식히는 공랭은 DGX B300까지, GB200·GB300 NVL72부터는 칩에 냉각수를 직접 흘리는 수냉과 CDU가 필요합니다.
- 네트워크는 GPU끼리(NVLink, Compute Fabric), 데이터(Storage Fabric), 관리(In-band·Out-of-band)용으로 나눠 설계합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (0) | 2026.09.26 |
|---|---|
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] GPU 노드에서 랙까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] DGX와 HGX 사양 비교 (0) | 2026.09.26 |
| [AI] AI 인프라를 위한 GPU 개념 정리 (0) | 2026.09.26 |