HGX는 GPU 8개를 고속 연결 장치(NVLink Switch)와 함께 보드 하나에 올린 부품이고, DGX는 NVIDIA가 그 보드로 직접 만든 완성품 서버입니다. 같은 세대면 GPU 성능은 같고, 누가 서버를 만들고 지원하느냐가 다릅니다. GB300 NVL72부터는 GPU 72개를 한 덩어리로 묶어서 서버가 아니라 랙 하나가 한 단위가 됩니다.
1. DGX, HGX, NVL72 구분
AI GPU 자료를 보면 H100, HGX H100, DGX H100처럼 이름은 비슷한데 앞머리만 다른 제품이 계속 나옵니다. 컴퓨터 부품으로 비유하면 GPU는 그래픽 칩, HGX는 칩 8개를 올려 둔 메인보드, DGX는 그 메인보드로 조립한 완성품 PC, NVL72는 여러 대를 한 몸처럼 묶은 랙입니다. GPU 자체의 구조와 메모리는 AI 인프라를 위한 GPU 개념 정리에서 다뤘고, 이 글은 제품 구분과 사양을, 이어지는 AI 인프라 전력·냉각·네트워크 정리는 데이터센터에 필요한 조건을 다룹니다.
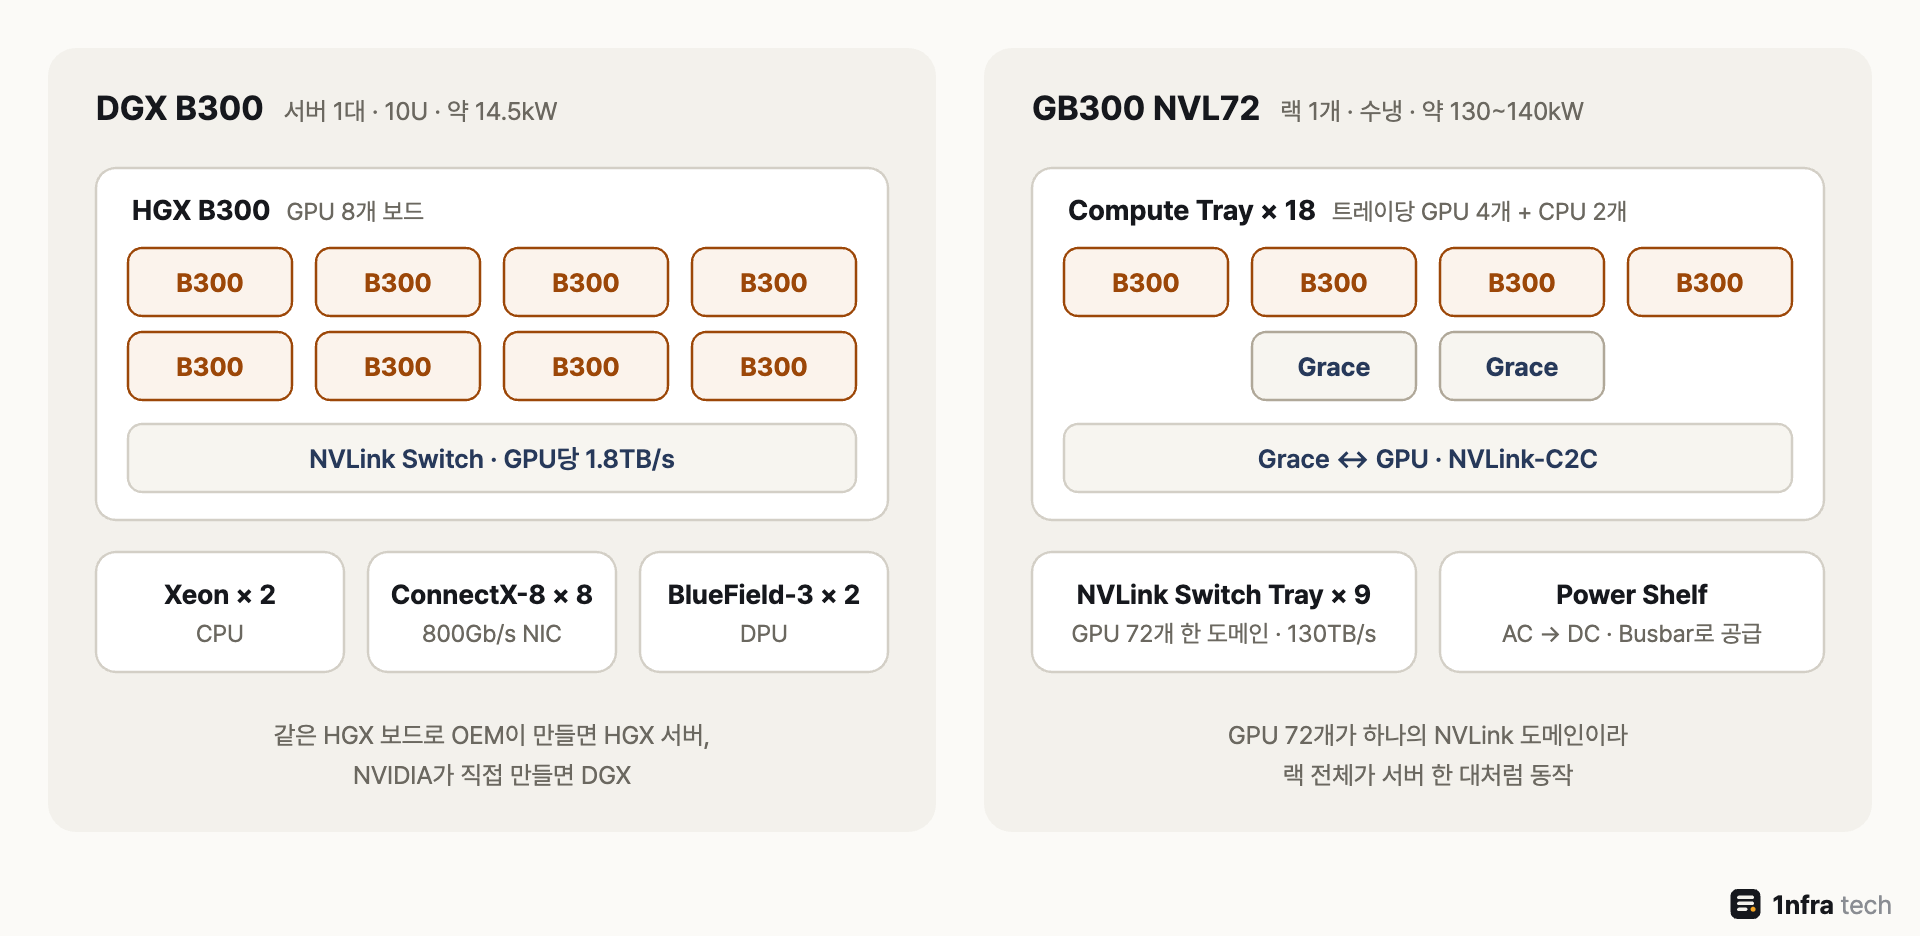
Blackwell Ultra 세대에서 GPU 칩이 HGX 보드와 DGX 서버, GB300 NVL72 랙으로 묶이는 구조
| 구분 | 단위 | 특징 |
| GPU | 칩(보드에 올리는 SXM 모듈) | H100, B200, B300처럼 GPU 하나 |
| HGX | GPU 8개 보드 | Dell, HPE, Supermicro 같은 서버 회사(OEM)가 CPU·네트워크 카드·전원을 붙여 서버로 판매 |
| DGX | 서버 1대 | NVIDIA가 HGX 보드로 만든 완성품, DGX OS와 소프트웨어·지원 포함 |
| NVL72 | 랙 1개 | GPU 72개와 Grace CPU 36개를 NVLink로 묶어 랙 전체가 한 대처럼 동작, 물로 냉각 |
| DGX SuperPOD | 클러스터 | DGX 여러 대와 네트워크, 스토리지, 관리 소프트웨어를 묶은 NVIDIA 권장 설계도 |
HGX 서버와 DGX는 같은 GPU 보드를 쓰므로 GPU 성능은 거의 같고, 차이는 완성품이냐 맞춤 조립이냐입니다. DGX는 NVIDIA가 부품, 펌웨어, 소프트웨어를 한 번에 검증하고 지원해 주는 대신 비싸고, HGX 서버는 CPU, 메모리, 스토리지를 원하는 대로 고를 수 있습니다. 저는 NVIDIA 권장 설계(SuperPOD)를 그대로 따를 때는 DGX, 기존에 쓰던 서버 회사와 운영 방식에 맞춰야 할 때는 HGX 서버가 맞다고 봅니다.
2. GPU 세대별 사양
| 항목 | H100 | H200 | B200 | B300 | Rubin |
| 세대 | Hopper | Hopper | Blackwell | Blackwell Ultra | Vera Rubin |
| GPU 메모리 | 80GB HBM3 |
141GB HBM3e |
180GB HBM3e |
288GB HBM3e |
288GB HBM4 |
| 메모리 대역폭 | 3.35TB/s | 4.8TB/s | 8TB/s | 8TB/s | 약 22TB/s |
| NVLink(GPU당) | 900GB/s | 900GB/s | 1.8TB/s | 1.8TB/s | 3.6TB/s |
| 최소 정밀도 | FP8 | FP8 | FP4 | FP4 | FP4 |
세대가 바뀔 때 가장 크게 늘어나는 것은 메모리입니다. LLM은 모델 가중치와 지금까지 읽은 문맥(KV Cache)을 GPU 메모리에 올려 두고 답을 만들기 때문에, 메모리가 크면 같은 모델을 더 적은 GPU로 서비스할 수 있습니다. 메모리 대역폭은 GPU가 메모리에서 1초에 읽어 올 수 있는 양으로 답이 나오는 속도와 바로 이어지고, 정밀도는 숫자 하나를 몇 비트로 저장하느냐입니다. FP4처럼 비트가 적을수록 정확도는 조금 떨어지지만 더 큰 모델을 더 빨리 돌릴 수 있습니다.
B300 메모리는 NVIDIA 제품 페이지가 8개 합계 2.1TB로, 사용자 가이드가 8 × 288GB = 2.3TB로 적고 있어 도입 전에 공급사에 실제 사용 가능한 용량을 확인하는 편이 정확합니다. Rubin은 NVIDIA가 예비 사양으로 공개한 값이라 바뀔 수 있습니다.
3. 시스템 사양과 전력
| 항목 | DGX H100·H200 | DGX B200 | DGX B300 | GB300 NVL72 |
| GPU | H100 또는 H200 × 8 | B200 × 8 | B300 × 8 | B300 × 72 + Grace × 36 |
| GPU 메모리 합계 | 640GB / 1,128GB |
1,440GB | 2.1TB | 20TB |
| FP8 성능 | 32 PFLOPS | 72 PFLOPS | 72 PFLOPS | 720 PFLOPS |
| 최대 전력 | 10.2kW | 약 14.3kW | 약 14.5kW | 랙당 약 130~140kW |
| 크기 | 8U | 10U | 10U | 랙 1개 |
| NIC | ConnectX-7 400Gb/s × 8 |
ConnectX-7 400Gb/s × 8 |
ConnectX-8 800Gb/s × 8 |
ConnectX-8 800Gb/s × 72 |
| 냉각 | 공랭 | 공랭 | 공랭 | 수냉 |
FP8 성능은 NVIDIA 표기대로 Sparsity(0이 많은 계산을 건너뛰는 기능)를 포함한 값이고, 1 PFLOPS는 1초에 1,000조 번 계산하는 속도입니다. GB300 NVL72 랙 전력은 NVIDIA가 따로 공개하지 않아 파트너 자료에 나온 범위로 적었습니다. GPU 8개 서버 한 대가 10~14kW를 쓰므로 보통 서버 랙 하나 분량의 전력을 서버 한 대가 쓰는 셈이고, GB300 NVL72는 이 전력이 랙 하나에 130kW 안팎으로 모여 바람으로는 식힐 수 없고 물로 식혀야 합니다. 전력과 냉각을 어떻게 준비하는지는 다음 글에서 이어서 정리했습니다.
4. NVLink와 PCIe
HGX와 DGX가 GPU를 일반 그래픽카드처럼 슬롯에 꽂지 않고 보드에 직접 올리는(SXM) 이유는 NVLink 때문입니다. 일반 슬롯(PCIe Gen5 x16)은 양방향 약 128GB/s인데, Blackwell의 NVLink 5는 GPU당 1.8TB/s로 14배 정도 빠릅니다. 보드 위의 NVLink Switch가 전화 교환기처럼 가운데에서 이어 줘서 GPU 8개가 서로 모두 같은 속도로 연결됩니다.
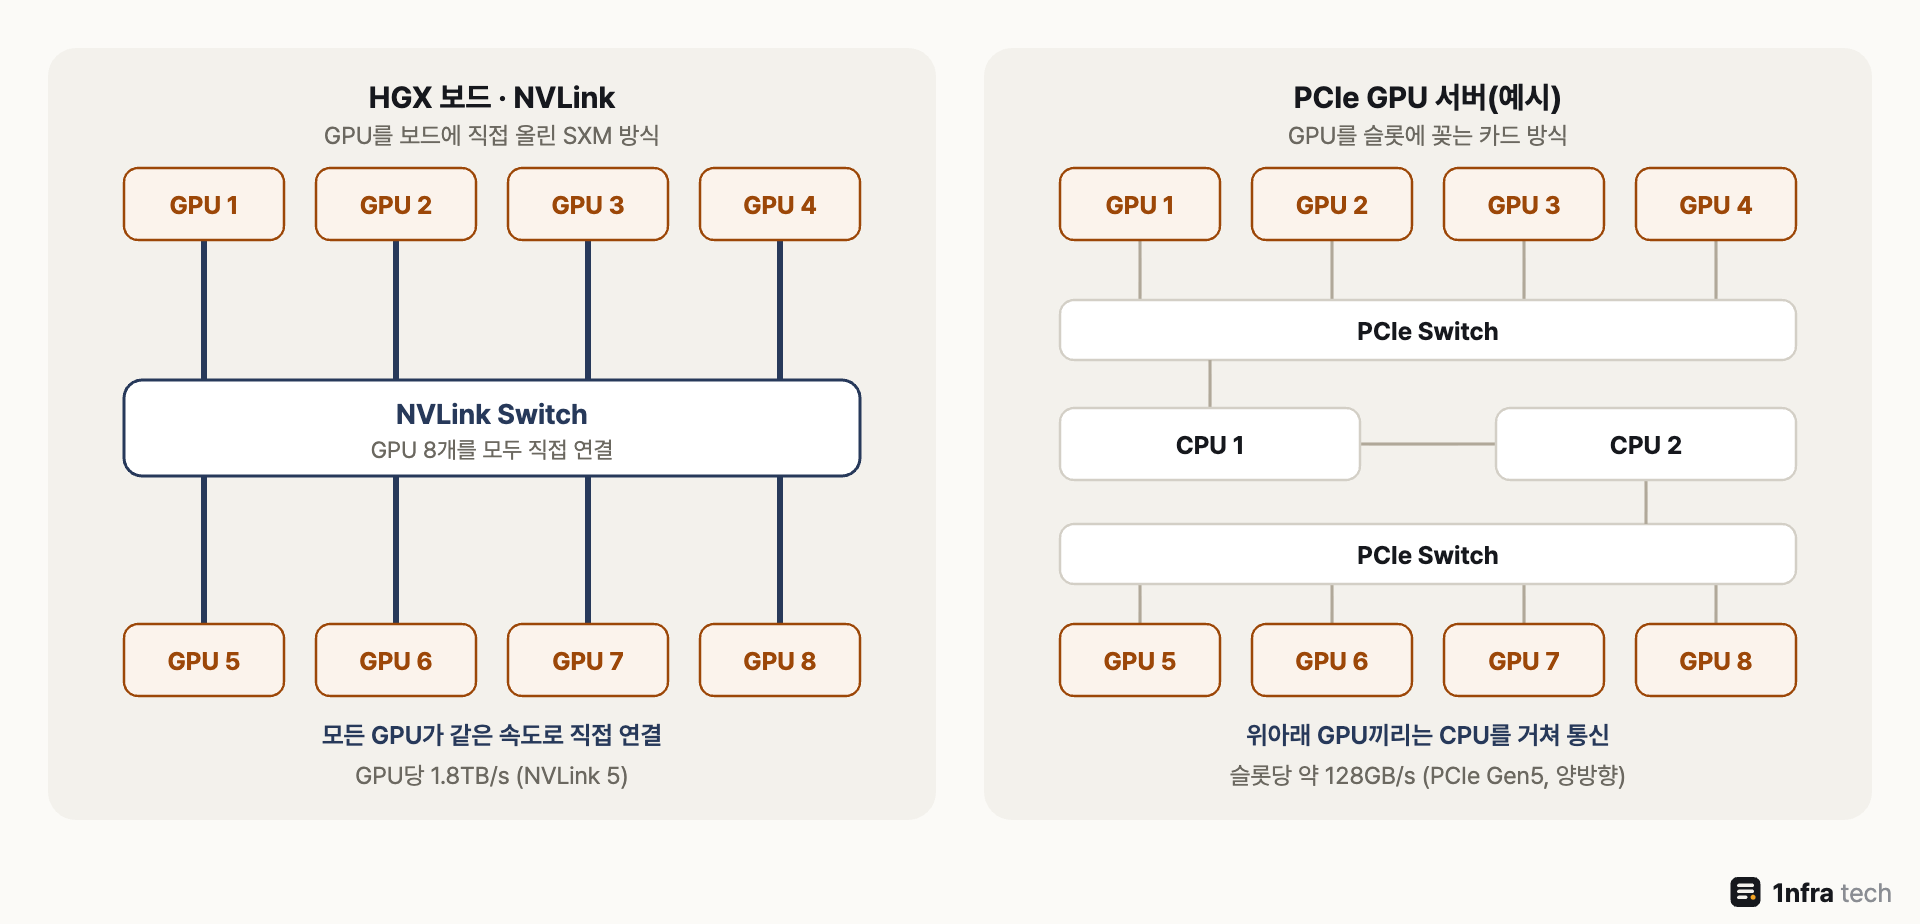
HGX 보드는 NVLink Switch로 GPU 8개를 모두 직접 연결하고, PCIe 서버는 PCIe Switch와 CPU를 거쳐 통신하는 구조
| 세대 | GPU | GPU당 대역폭 | NVLink 도메인 |
| NVLink 4 | Hopper | 900GB/s | GPU 8개(HGX) |
| NVLink 5 | Blackwell | 1.8TB/s | GPU 8개(HGX), 72개(NVL72) |
| NVLink 6 | Rubin | 3.6TB/s | GPU 72개(NVL72) |
PCIe 카드형 GPU는 NVLink Switch가 없어서 GPU끼리 PCIe로 통신하거나, NVLink Bridge로 2~4개만 묶습니다. 큰 모델을 여러 GPU에 나눠 올리면 계산 단계마다 GPU끼리 중간 결과를 주고받아야 해서, 빠른 길(NVLink)로 묶인 GPU가 몇 개냐가 한 번에 효율적으로 다룰 수 있는 모델 크기를 정합니다. 저는 이 점이 같은 GPU 칩이라도 HGX 서버와 PCIe 서버의 용도가 갈리는 가장 큰 이유라고 봅니다.
5. 도입 시 주의점
| 항목 | 조치 |
| 전력·냉각 | 서버 한 대가 10~14kW, NVL72는 랙당 100kW를 넘으므로 데이터센터가 수용할 수 있는지부터 확인합니다. |
| 네트워크 | GPU마다 400~800Gb/s 네트워크 카드가 붙으므로 GPU 전용 고속 네트워크(InfiniBand, Spectrum-X Ethernet)를 함께 설계합니다. |
| GPU 메모리 | 서비스할 모델 크기와 KV Cache를 기준으로 필요한 GPU 메모리와 GPU 수를 먼저 계산합니다. |
| 소프트웨어 | GPU 세대마다 필요한 드라이버와 CUDA·NCCL(GPU 계산·통신 라이브러리) 버전이 다르므로 컨테이너 이미지와 드라이버를 세대에 맞춥니다. |
6. 정리
- HGX는 GPU 8개 보드, DGX는 NVIDIA 완성품 서버, NVL72는 GPU 72개를 묶은 랙 단위 시스템입니다.
- 세대가 바뀌면 GPU 메모리와 GPU 사이 연결 속도(NVLink)가 크게 늘고, Blackwell부터 더 작은 숫자 형식(FP4)을 지원합니다.
- GPU 8개 서버는 10~14kW, NVL72는 랙당 130kW 안팎을 쓰므로 전력과 냉각을 먼저 확인합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (0) | 2026.09.26 |
|---|---|
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] GPU 노드에서 랙까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] AI 인프라 전력·냉각·네트워크 정리 (0) | 2026.09.26 |
| [AI] AI 인프라를 위한 GPU 개념 정리 (0) | 2026.09.26 |