NVLink는 GPU를 잇는 고속 연결(선과 포트)이고, NVSwitch는 NVLink 여러 개를 받아 모든 GPU를 같은 속도로 이어 주는 스위치 칩입니다. 네트워크로 치면 NVLink는 랜선과 포트, NVSwitch는 스위치입니다. GPU 2~4개는 NVLink만으로 직접 이을 수 있지만, 8개 이상을 모두 최대 속도로 묶으려면 NVSwitch가 필요하고, Blackwell부터는 이 스위치를 랙 단위로 키워 GPU 72개를 하나로 묶습니다.
1. 한눈에 보기
GPU 서버 자료에는 NVLink, NVSwitch, NVLink Switch가 섞여 나와서 같은 것처럼 보이기 쉽습니다. 둘은 역할이 다른 짝입니다. NVLink가 GPU에 달린 고속 포트와 선이라면, NVSwitch는 그 선들을 한곳에 모아 누구와 누구든 바로 이어 주는 교환기입니다. GPU 자체와 서버 구성은 DGX와 HGX 사양 비교에서 다뤘습니다.
| 항목 | NVLink | NVSwitch |
| 정체 | GPU끼리 데이터를 주고받는 연결 규격(링크) | NVLink를 여러 개 받는 스위치 칩 |
| 역할 | 두 지점을 직접 연결 | 여러 GPU를 모두 같은 속도로 연결 |
| 네트워크 비유 | 랜선과 포트 | 스위치 |
| 혼자 쓸 때 | GPU 2~4개는 직접 연결 가능 | NVLink 없이는 쓸 수 없음 |
| 대표 예 | 카드형 GPU의 NVLink Bridge | HGX·DGX 보드, NVL72 Switch Tray |
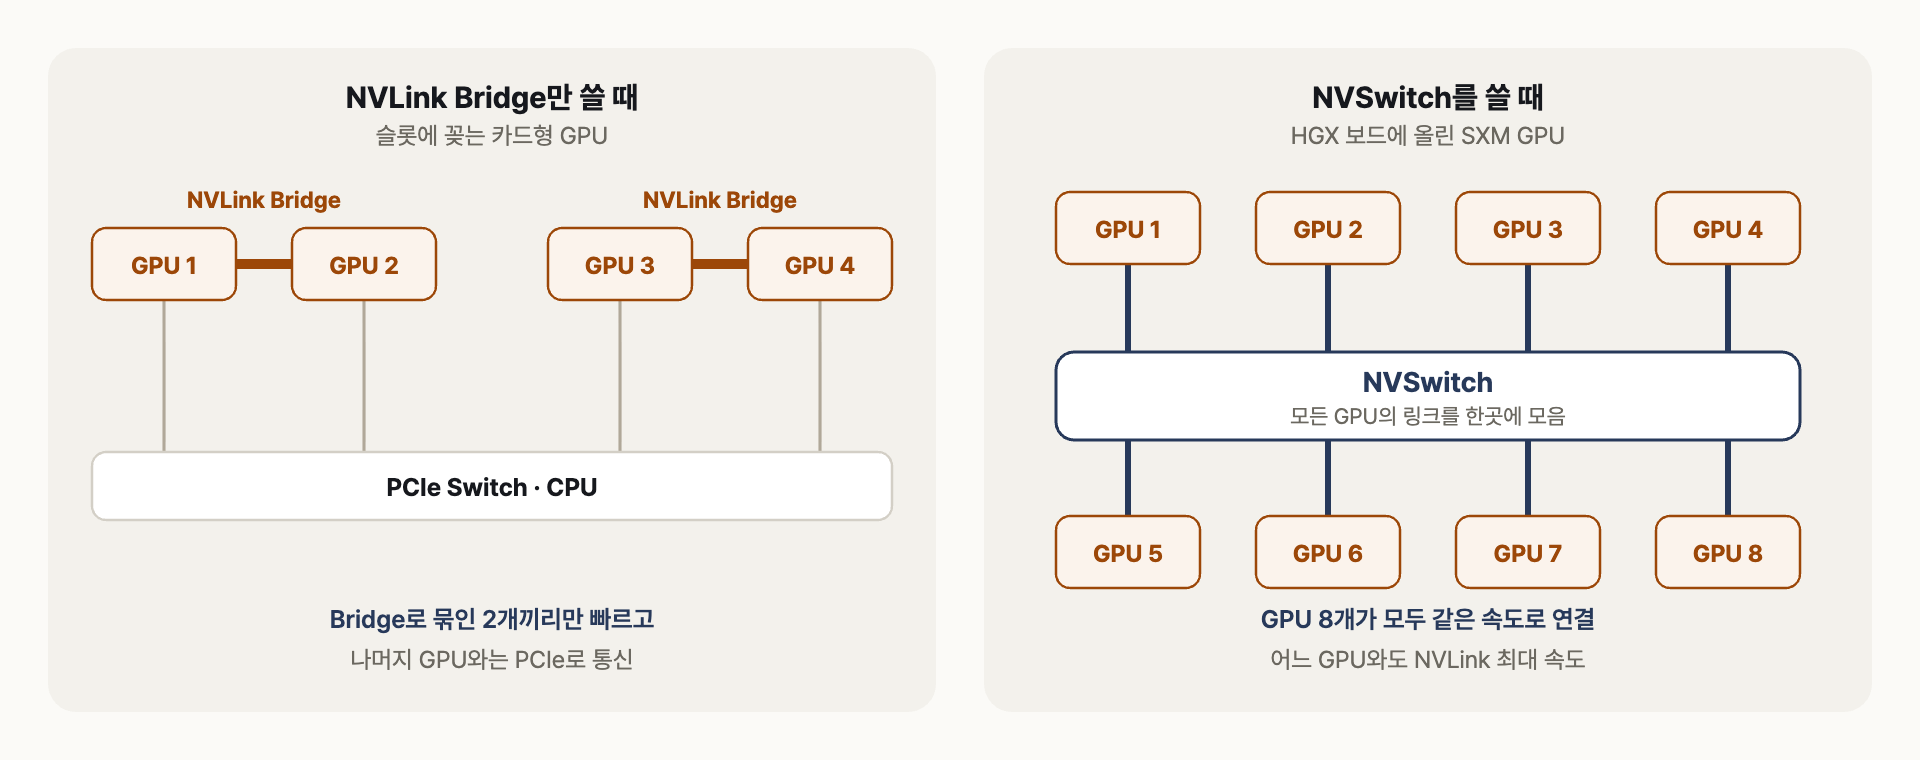
NVLink만 쓰면 GPU 2개씩만 빠르게 묶이고, NVSwitch를 쓰면 GPU 8개가 모두 같은 속도로 연결되는 구조
2. NVLink
NVLink는 GPU에 달린 고속 링크입니다. GPU 하나에 링크가 여러 개 있고, 링크 수 × 링크 하나의 속도가 GPU 하나가 낼 수 있는 NVLink 대역폭입니다. 예를 들어 Blackwell은 링크 18개 × 100GB/s = 1.8TB/s입니다. 세대가 바뀔 때마다 링크 속도나 링크 수가 늘어 대역폭이 대략 두 배씩 커졌습니다.
| 세대 | GPU | 링크 수 | GPU당 대역폭 |
| NVLink 3 | A100 | 12 | 600GB/s |
| NVLink 4 | H100·H200 | 18 | 900GB/s |
| NVLink 5 | B200·B300 | 18 | 1.8TB/s |
| NVLink 6 | Rubin | 36 | 3.6TB/s |
대역폭은 보내고 받는 양을 합친 양방향 값입니다. NVLink는 선만 있으면 GPU 두 개를 직접 이을 수 있어서, 슬롯에 꽂는 카드형 GPU는 NVLink Bridge라는 연결 부품으로 2~4개를 묶습니다. A100 PCIe 카드도 Bridge로 두 장을 600GB/s로 연결할 수 있습니다. 다만 Bridge로 묶인 GPU끼리만 빠르고, 나머지 GPU와는 PCIe를 거칩니다.
3. NVSwitch가 필요한 이유
GPU 8개를 NVLink로 직접 모두 이으려고 하면 문제가 생깁니다. GPU 하나의 링크는 18개로 정해져 있는데 상대가 7개라, 링크를 2~3개씩 나눠 줘야 합니다. 그러면 특정 GPU 하나와 주고받을 때는 전체 대역폭의 1/7 정도만 쓰게 됩니다. 도로 18차선을 7갈래로 나눠 한 방향에는 2~3차선만 남는 셈입니다.
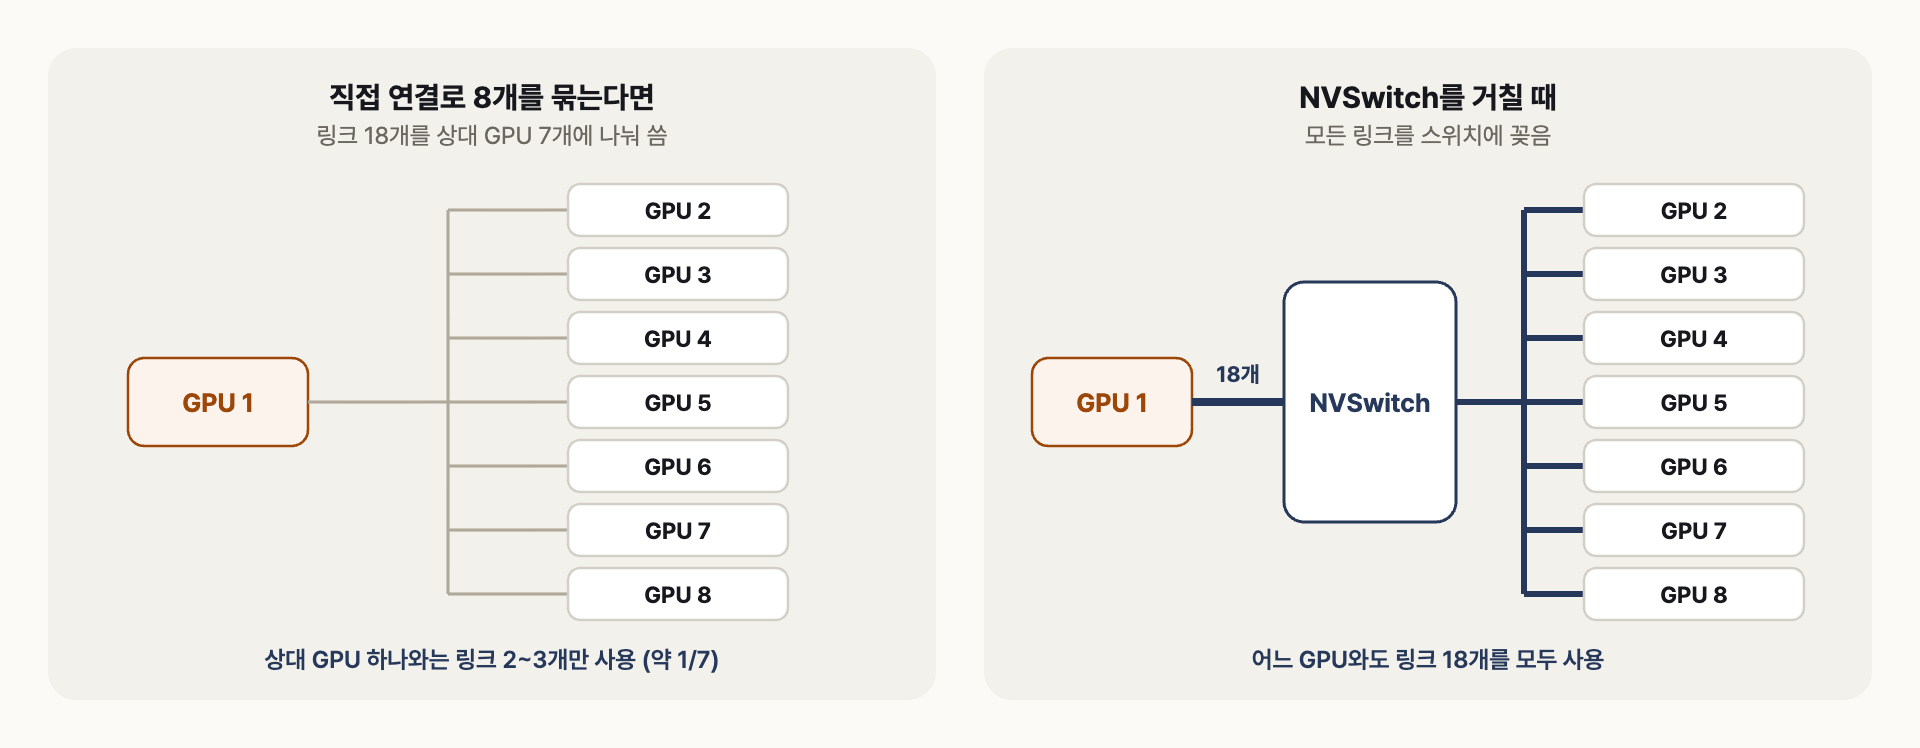
GPU 8개를 직접 이으면 링크 18개를 7개 GPU에 나눠 써야 하고, NVSwitch를 거치면 어느 GPU와도 링크 18개를 모두 쓰는 차이
NVSwitch는 이 문제를 교환기 방식으로 풉니다. 모든 GPU가 링크를 전부 NVSwitch에 꽂고, 스위치가 요청마다 길을 이어 주기 때문에 어떤 GPU와 통신하든 링크 18개를 모두 쓸 수 있습니다. 여러 GPU가 동시에 서로 주고받아도 속도가 떨어지지 않는 것이 핵심입니다. Hopper 세대부터는 NVSwitch가 받은 값을 직접 더해 주는 기능(NVLink SHARP)도 있어, GPU끼리 결과를 합치는 AllReduce가 더 빨라집니다.
| 세대 | 시스템 | 보드당 칩 수 | 연결 GPU |
| 1세대 | DGX-2(V100) | 6개 | 보드당 8개, 보드 2장으로 16개 |
| 2세대 | HGX A100 | 6개 | 8개 |
| 3세대 | HGX H100·H200 | 4개 | 8개 |
| 4세대 (NVLink Switch) |
HGX B200·B300 | 2개 | 8개 |
| 4세대 (NVLink Switch) |
GB200·GB300 NVL72 | Switch Tray 9개에 18개 | 72개 |
세대가 갈수록 칩 하나가 받는 링크가 늘어 보드당 칩 수는 줄었습니다. Blackwell부터 NVIDIA는 이 칩을 NVLink Switch라고 부르고, 서버 보드 안에만 두던 스위치를 랙 안의 별도 장비(Switch Tray)로 꺼냈습니다. 그래서 NVLink로 묶이는 범위가 서버 한 대(GPU 8개)에서 랙 하나(GPU 72개)로 넓어졌습니다.
4. NVL72의 연결 방식
GB200·GB300 NVL72는 GPU 72개와 NVLink Switch 칩 18개로 이뤄집니다. GPU 하나에 있는 링크 18개를 스위치 칩 18개에 하나씩 꽂고, 72개 GPU가 모두 같은 방식으로 연결됩니다. 그래서 어느 GPU끼리든 스위치 한 단계만 거쳐 GPU당 1.8TB/s로 통신하고, 랙 전체로는 130TB/s가 됩니다.
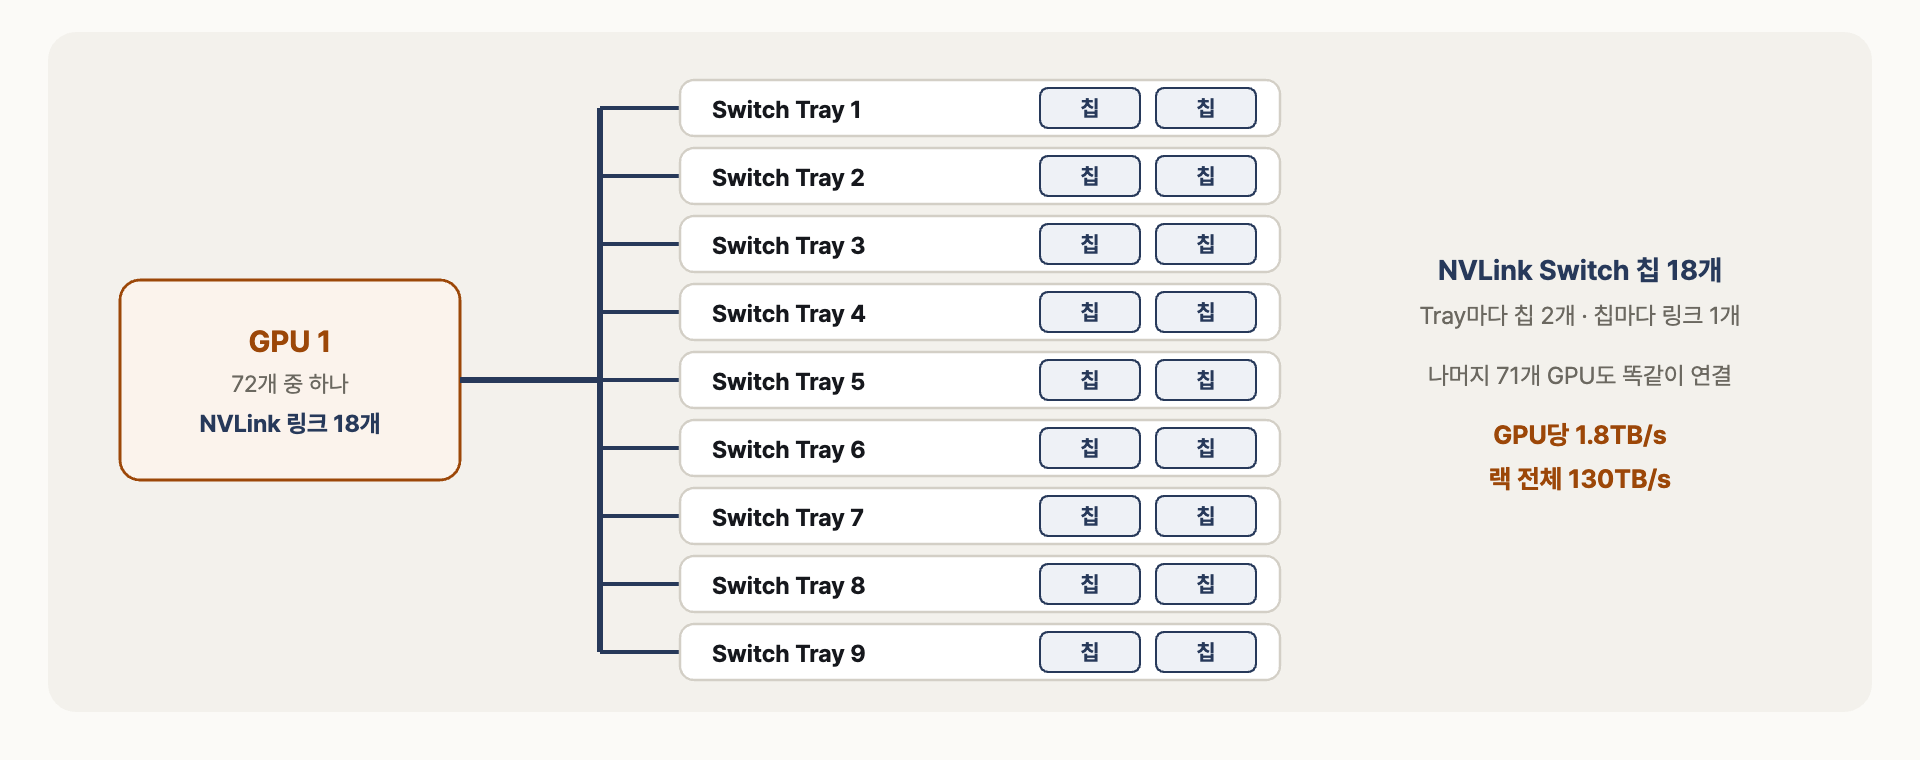
NVL72에서 GPU 하나가 링크 18개를 NVLink Switch 칩 18개(Switch Tray 9개)에 하나씩 연결하는 구조
이 구조 덕분에 NVL72는 GPU 72개가 한 서버처럼 서로의 메모리에 빠르게 접근할 수 있습니다. 모델을 여러 GPU에 쪼개 올리는 Tensor Parallelism이나 MoE 모델의 전문가 간 통신을 72개 안에서 끝낼 수 있어, 큰 모델일수록 효과가 큽니다(병렬화는 학습과 추론의 GPU 병렬화 방식 정리에서 다뤘습니다).
5. 설계 시 확인할 점
| 항목 | 조치 |
| NVLink 도메인 크기 | NVLink로 묶인 GPU 수가 모델을 쪼갤 수 있는 한계(TP 크기)를 정하므로 모델 크기에 맞춰 고릅니다. |
| 카드형 GPU | NVLink Bridge는 2~4개까지만 묶으므로, 8개를 모두 빠르게 묶어야 하면 HGX 보드 서버를 고릅니다. |
| Fabric Manager | NVSwitch가 있는 서버는 스위치를 설정하는 Fabric Manager 서비스가 있어야 GPU 프로그램이 실행되므로, 드라이버와 버전을 맞춰 설치합니다. |
| 파티션 | 여러 팀이 나눠 쓸 때는 NVLink 파티션으로 GPU 묶음을 나눠 서로의 통신을 분리합니다. |
6. 정리
- NVLink는 GPU끼리 잇는 고속 링크(선과 포트)이고, NVSwitch는 그 링크를 모아 모든 GPU를 같은 속도로 이어 주는 스위치 칩입니다.
- 직접 연결은 링크를 상대 수만큼 나눠 써야 해서 GPU가 많아지면 느려지고, NVSwitch를 거치면 어느 GPU와도 링크 전체를 씁니다.
- Blackwell부터 NVLink Switch를 랙 단위로 꺼내 NVL72에서는 GPU 72개가 하나의 NVLink 도메인이 됩니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (1) | 2026.09.26 |
|---|---|
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] GPU 노드에서 랙까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] AI 인프라 전력·냉각·네트워크 정리 (1) | 2026.09.26 |
| [NVIDIA] DGX와 HGX 사양 비교 (0) | 2026.09.26 |
