MIG(Multi-Instance GPU)는 GPU 한 장을 하드웨어 수준에서 최대 7개의 작은 GPU로 나누는 기능입니다. 나뉜 인스턴스마다 SM(연산 코어 묶음), 메모리, L2 캐시, 메모리 대역폭을 따로 갖기 때문에 한 인스턴스의 작업이 다른 인스턴스의 속도나 메모리에 영향을 주지 않습니다. A100 40GB는 1g.5gb부터 7g.40gb까지 정해진 프로필로만 나눌 수 있고, 작은 모델 추론이나 개발용 실험처럼 여러 작업이 GPU 한 장을 서로 방해 없이 나눠 써야 할 때 효과가 큽니다.
1. MIG란
A100 40GB 한 장을 작은 추론 서비스 하나가 쓰면 GPU 대부분이 놀게 됩니다. 여러 작업을 같이 올리면 이번에는 한 작업이 메모리를 다 차지하거나 연산을 몰아 써서 다른 작업이 느려집니다. MIG는 이 문제를 GPU 안에 칸막이를 세워서 해결합니다. 큰 사무실 하나를 벽으로 나눈 작은 사무실 여러 개로 만드는 것과 같아서, 옆 사무실이 아무리 바빠도 내 책상과 복도는 그대로 쓸 수 있습니다.
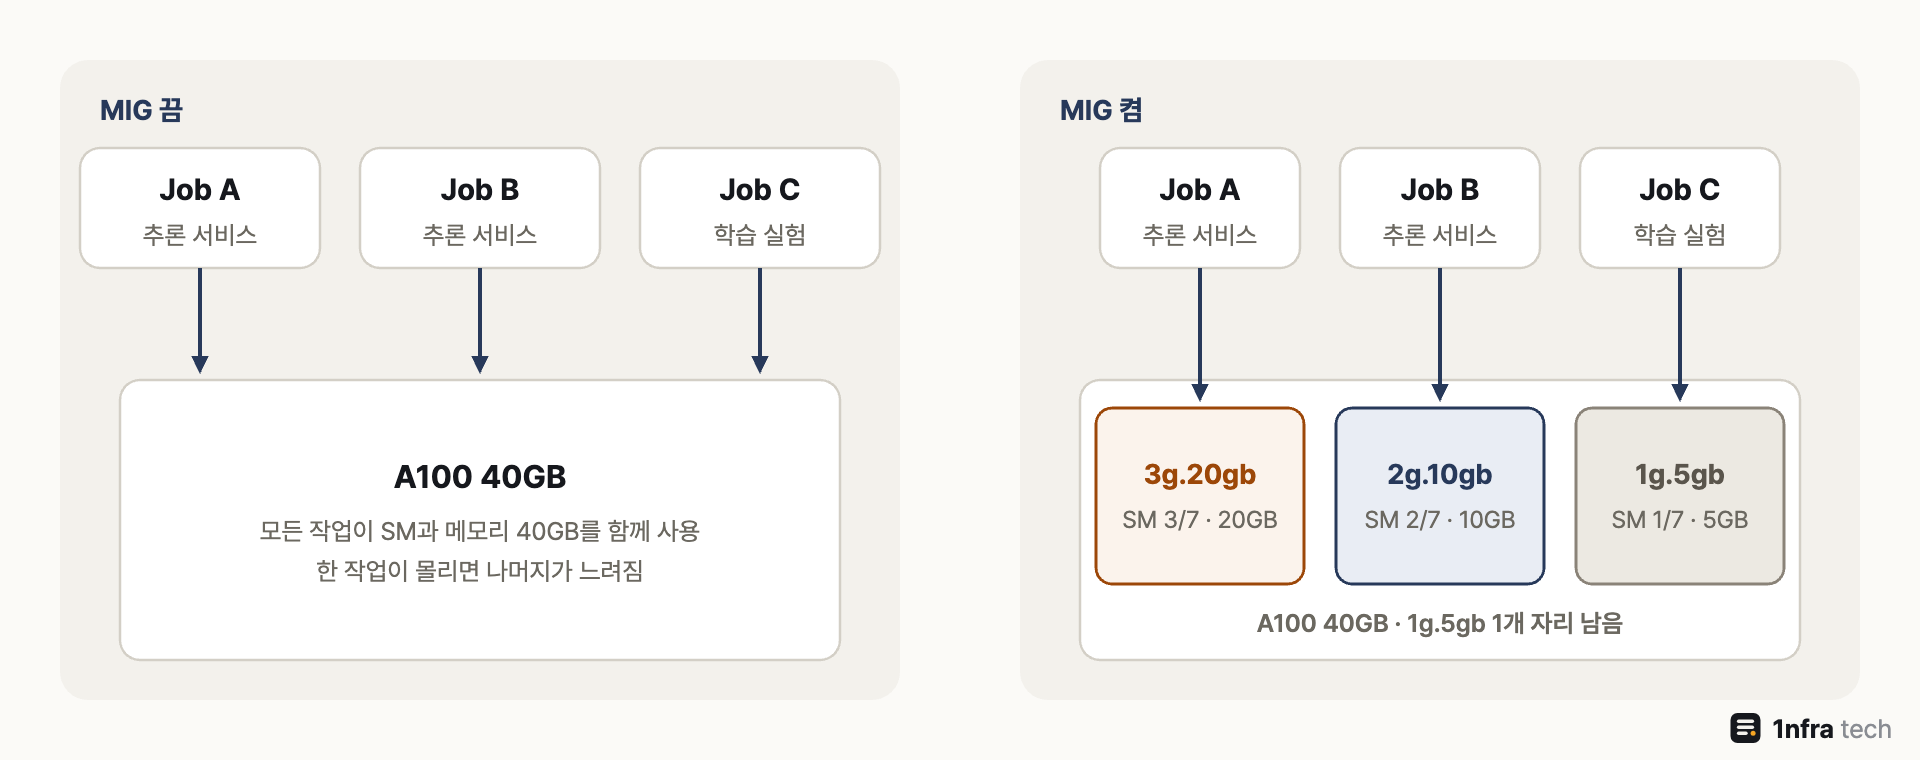
MIG를 끄면 모든 작업이 GPU 전체를 함께 쓰고, MIG를 켜면 작업마다 SM과 메모리가 나뉜 인스턴스를 따로 쓴다
MIG는 Ampere 세대(A100, A30)부터 지원하고 Hopper(H100, H200)와 Blackwell 세대로 이어집니다. 학습과 추론에서 쓰임새가 다릅니다.
| 구분 | MIG 활용 | 비고 |
| 추론 | 작은 모델 여러 개를 한 GPU에 나눠 올림 (예: 7B 이하 모델, 임베딩 모델) |
가장 흔한 용도 |
| 학습 | 개발자별 실험, Jupyter 노트북, 작은 Fine-tuning에 인스턴스를 하나씩 배정 | 큰 모델 학습은 MIG를 끄고 GPU 전체 사용 |
큰 모델 학습에 MIG를 쓰지 않는 이유는 여러 GPU를 묶어 통신하는 NCCL이 MIG 인스턴스에서 지원되지 않고, 인스턴스 하나의 메모리가 원래 GPU보다 작기 때문입니다(학습 병렬화는 학습과 추론의 GPU 병렬화 방식 정리에서 다뤘습니다).
2. 구조
2.1 Slice
MIG는 GPU를 두 종류의 조각으로 나눕니다. SM Slice는 연산 코어를 7등분한 조각이고, Memory Slice는 메모리와 그에 딸린 메모리 컨트롤러, L2 캐시를 8등분한 조각입니다. A100 40GB에서 Memory Slice 하나는 약 5GB입니다. 프로필 이름이 이 조각 수를 그대로 나타내서, 3g.20gb는 SM Slice 3개와 메모리 20GB(Memory Slice 4개)를 뜻합니다.
2.2 GPU Instance와 Compute Instance
나누는 단계는 두 층입니다. GPU Instance는 메모리, L2 캐시, Copy Engine까지 완전히 나눈 칸이고, Compute Instance는 GPU Instance 안의 SM을 다시 나눈 칸입니다. 같은 GPU Instance 안의 Compute Instance끼리는 메모리를 함께 씁니다. 사무실로 치면 GPU Instance는 벽으로 나눈 사무실, Compute Instance는 사무실 안의 책상입니다. 보통은 GPU Instance 하나에 Compute Instance 하나를 꽉 채워 만들고(-C 옵션), 같은 팀이 메모리를 나눠 써도 되는 경우에만 Compute Instance를 더 나눕니다.
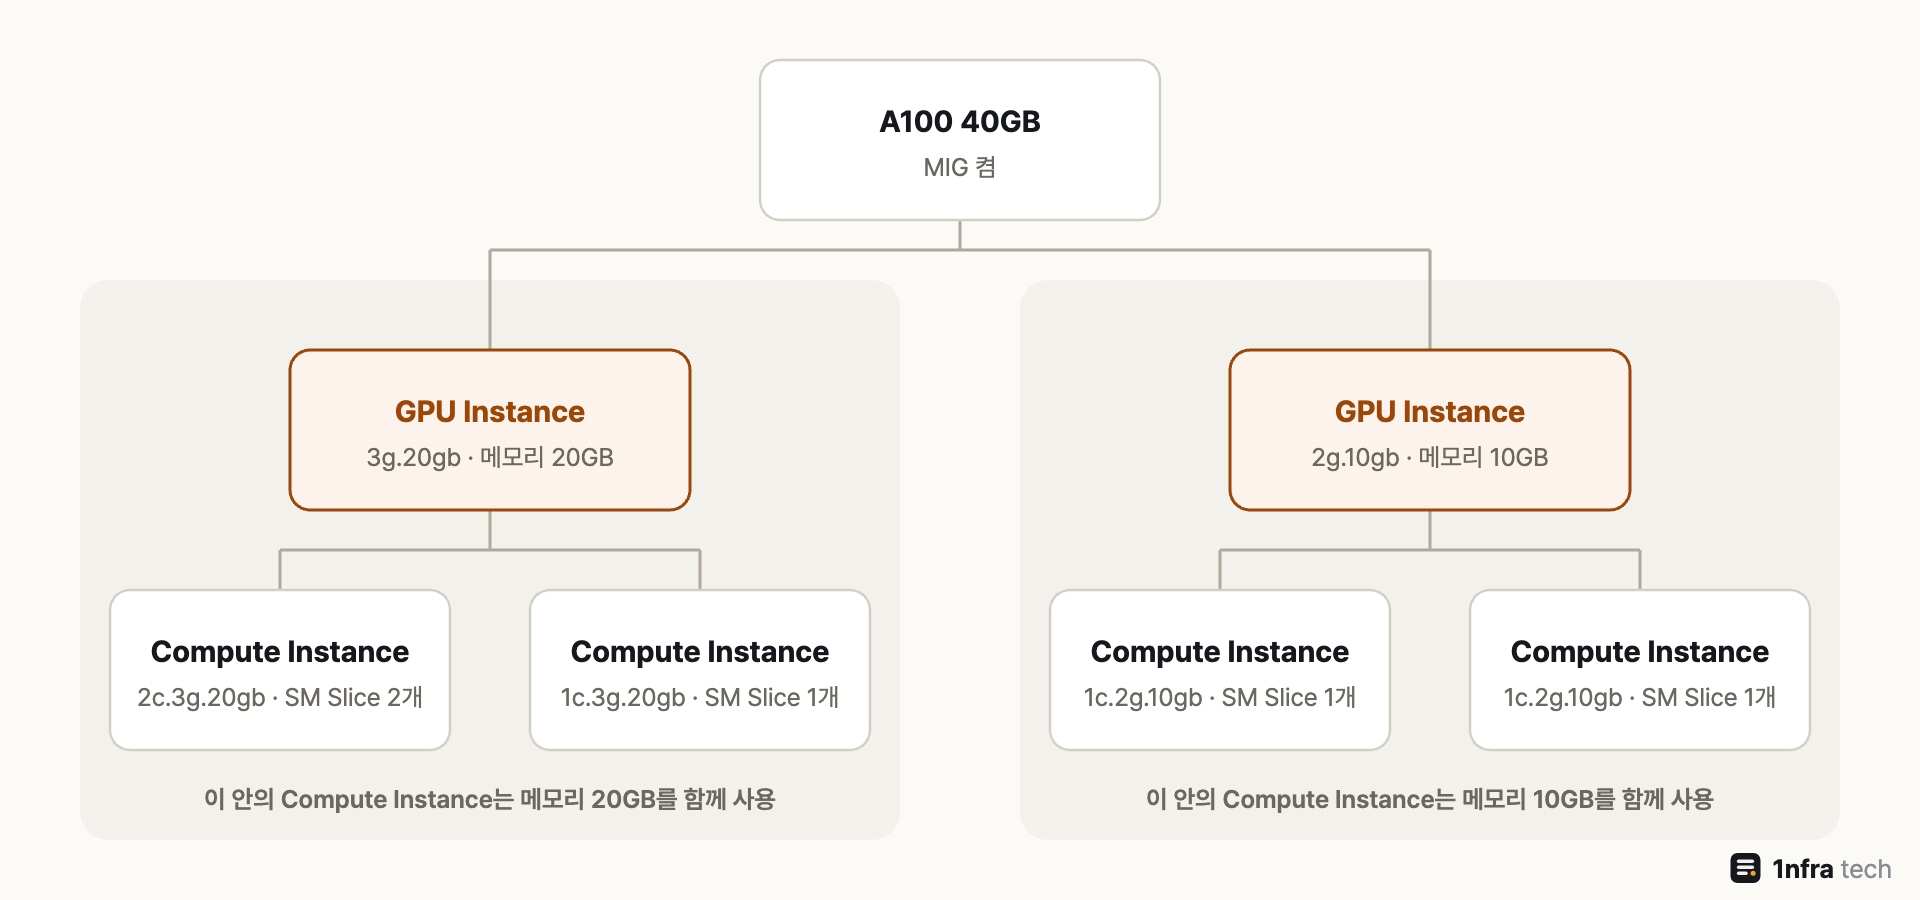
GPU를 GPU Instance로 나누고, 각 GPU Instance 안에 Compute Instance를 만드는 두 단계 구조
3. A100 40GB 프로필
MIG는 크기를 자유롭게 정할 수 없고 정해진 프로필 중에서 고릅니다. A100 40GB에서 쓸 수 있는 프로필은 다음과 같습니다.
| 프로필 | SM | 메모리 | 최대 개수 | 비고 |
| 1g.5gb | 1/7 | 1/8 | 7 | 가장 작은 단위 |
| 1g.5gb+me | 1/7 | 1/8 | 1 | 영상 디코더(NVDEC, JPEG) 포함 |
| 1g.10gb | 1/7 | 2/8 | 4 | R525 드라이버부터 |
| 2g.10gb | 2/7 | 2/8 | 3 | |
| 3g.20gb | 3/7 | 4/8 | 2 | |
| 4g.20gb | 4/7 | 4/8 | 1 | |
| 7g.40gb | 7/7 | 8/8 | 1 | GPU 전체 |
프로필은 SM Slice 7개와 Memory Slice 8개 안에서 정해진 자리에만 놓을 수 있습니다. 그래서 합이 맞아도 놓는 자리가 겹치면 만들 수 없습니다. 예를 들어 3g.20gb를 두 개 만들면 SM Slice가 하나 남지만 메모리가 모두 쓰여 1g.5gb를 더 만들 수 없습니다. 테트리스처럼 큰 블록부터 자리를 정하는 편이 좋고, 실제로 놓을 수 있는 자리는 nvidia-smi mig -lgipp로 확인합니다.
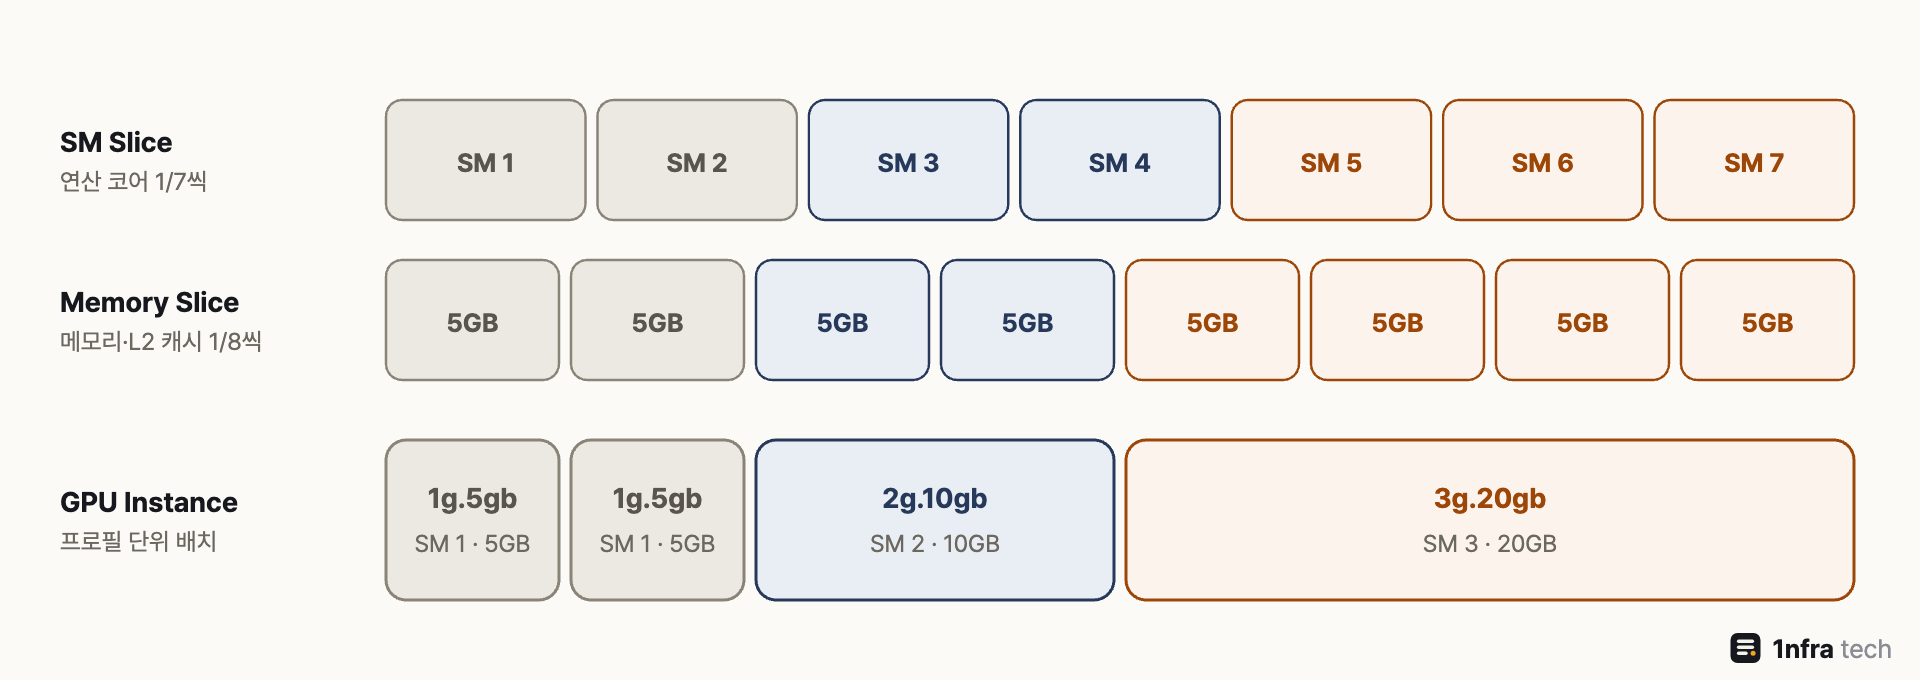
A100 40GB의 SM Slice 7개, Memory Slice 8개 위에 3g.20gb, 2g.10gb, 1g.5gb 2개를 배치한 예
4. MIG, Time-slicing, MPS 비교
GPU를 여러 작업이 나눠 쓰는 방법은 MIG 말고도 두 가지가 더 있습니다. Time-slicing은 작업들이 GPU 전체를 시간 단위로 번갈아 쓰는 방식이고, MPS(Multi-Process Service)는 여러 프로세스의 커널을 GPU 안에서 동시에 실행하는 방식입니다. 식당으로 비유하면 Time-slicing은 테이블 하나를 시간제로 돌려 쓰는 것, MPS는 큰 테이블에 합석하는 것, MIG는 칸막이 친 개별 테이블입니다.
| 항목 | Time-slicing | MPS | MIG |
| 나누는 방식 | 시간을 나눔 | SM을 동시에 나눠 씀 | SM, 메모리, 캐시를 하드웨어로 나눔 |
| 메모리 분리 | 없음 | 주소 공간만 분리, 용량 제한은 설정으로 |
있음(용량, 대역폭, L2 캐시) |
| 장애 격리 | 없음 | 제한적(한 프로세스 오류가 전체에 영향 가능) | 있음 |
| 성능 예측 | 낮음(다른 작업에 따라 변함) | 중간 | 높음(인스턴스 크기만큼 일정) |
| 나누는 개수 | 설정한 만큼 | 최대 48 클라이언트 | A100 기준 최대 7 |
| 지원 GPU | 대부분 | Volta 이후 | Ampere 이후 데이터센터 GPU |
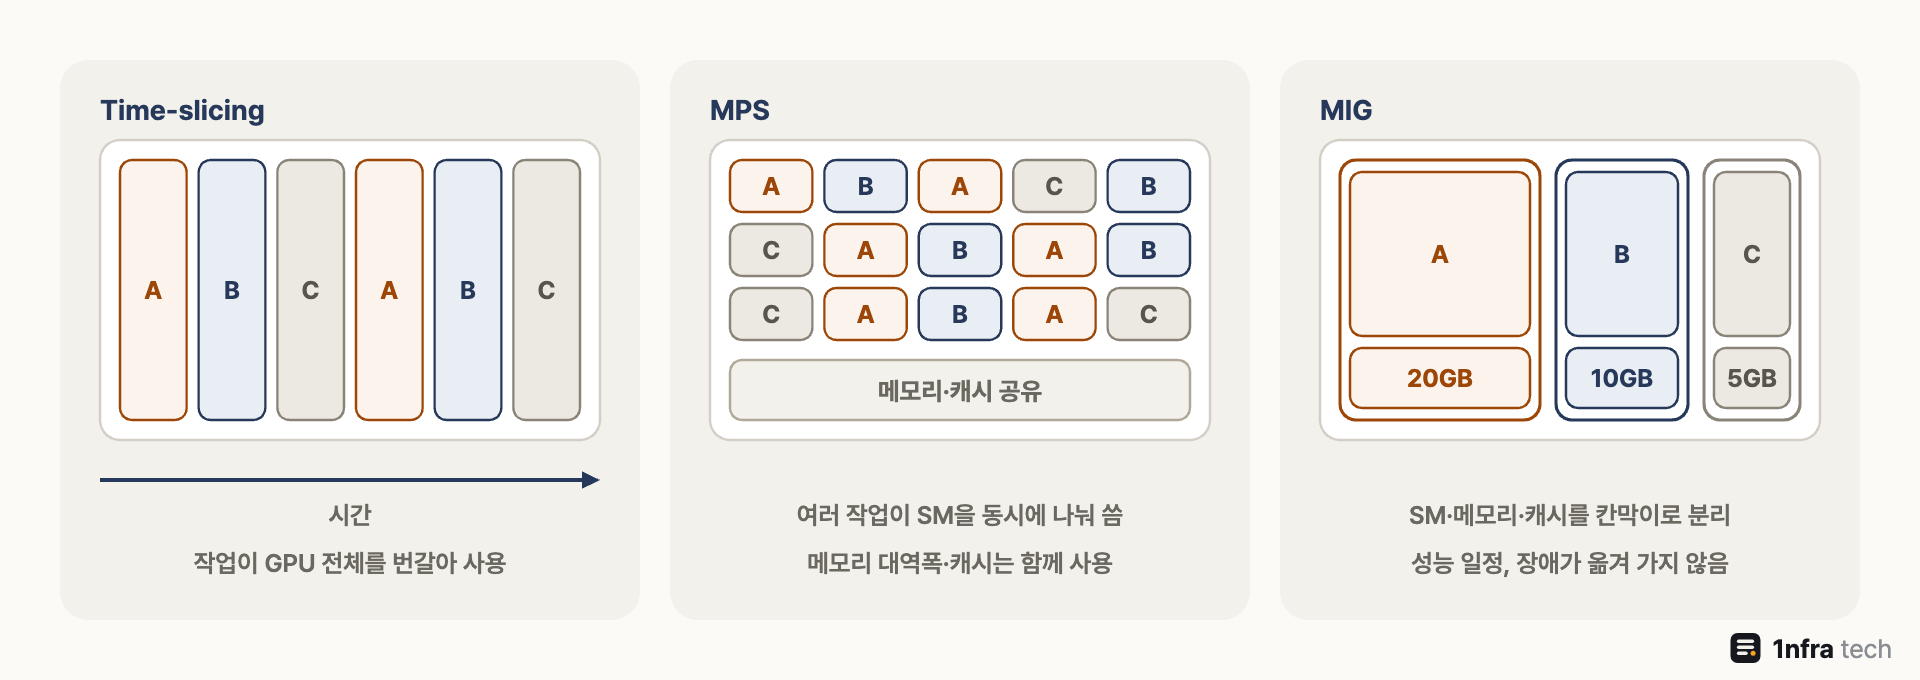
Time-slicing은 시간을, MPS는 SM을 나눠 쓰고, MIG는 SM과 메모리를 하드웨어 칸막이로 나눈다
여러 팀이나 여러 서비스가 한 GPU를 나눠 쓰고 서로 영향을 주면 안 되는 운영 환경은 MIG가 맞고, 같은 팀의 개발용 Pod처럼 격리보다 개수가 중요한 경우는 Time-slicing이 간편합니다. MPS는 MIG 인스턴스 위에서 함께 쓸 수도 있습니다.
5. 설정 방법
5.1 MIG 켜기
MIG를 켜려면 GPU를 쓰는 프로세스가 하나도 없어야 합니다. nvidia-persistenced나 DCGM 같은 모니터링 서비스가 GPU를 잡고 있으면 "In use by another client" 오류가 나므로 먼저 멈춥니다. A100은 MIG를 켤 때 GPU가 리셋되고, 켠 상태는 GPU 안(InfoROM)에 저장되어 재부팅해도 유지됩니다.
# GPU를 쓰는 프로세스 확인 (비어 있어야 함)
nvidia-smi --query-compute-apps=pid,process_name --format=csv

# GPU를 잡고 있는 서비스 중지 (DCGM 서비스 이름은 설치 방식에 따라 dcgm 또는 nvidia-dcgm)
sudo systemctl stop nvidia-persistenced nvidia-dcgm

# MIG 켜기 (A100은 이때 GPU가 리셋됨)
sudo nvidia-smi -i 0 -mig 1

# 상태 확인 (current가 Enabled면 완료, pending이 남아 있으면 재부팅)
nvidia-smi --query-gpu=mig.mode.current,mig.mode.pending --format=csv
5.2 인스턴스 만들기
먼저 만들 수 있는 프로필과 놓을 수 있는 자리를 확인한 뒤, 3장의 도식처럼 3g.20gb, 2g.10gb, 1g.5gb 2개로 나눕니다. -C 옵션을 붙이면 GPU Instance마다 Compute Instance를 꽉 채워 함께 만듭니다.
# 만들 수 있는 프로필과 남은 개수
nvidia-smi mig -lgip

# 프로필별로 놓을 수 있는 자리
nvidia-smi mig -lgipp

# GPU Instance 4개 생성 + 각각 Compute Instance 생성(-C)
sudo nvidia-smi mig -cgi 3g.20gb,2g.10gb,1g.5gb,1g.5gb -C

# 결과 확인
nvidia-smi mig -lgi
nvidia-smi -L
nvidia-smi -L을 실행하면 GPU 아래에 "MIG 3g.20gb Device 0"처럼 인스턴스가 한 줄씩 나오고, 각 줄에 MIG-로 시작하는 UUID가 붙습니다. 자리가 겹쳐 "Insufficient resources" 오류가 나면 -lgipp로 남은 자리를 다시 확인하고 구성을 조정합니다.
5.3 인스턴스 지정해서 쓰기
프로세스나 컨테이너에는 MIG UUID로 인스턴스를 지정합니다. CUDA 프로세스 하나는 MIG 인스턴스 하나만 볼 수 있어서, 인스턴스 여러 개를 묶어 한 프로세스에서 쓰는 것은 안 됩니다.
# 프로세스에 MIG 인스턴스 하나 지정
CUDA_VISIBLE_DEVICES=MIG-<UUID> python3 serve.py

# 컨테이너에 MIG 인스턴스 하나 지정
docker run --rm --gpus '"device=MIG-<UUID>"' <이미지> nvidia-smi
5.4 재부팅 후에도 같은 구성 유지
GPU Instance와 Compute Instance는 재부팅하면 사라집니다. NVIDIA의 mig-parted는 원하는 구성을 YAML로 적어 두고 한 번에 적용하는 도구라, 부팅 때 실행하도록 걸어 두면 매번 같은 구성으로 돌아옵니다.
version: v1
mig-configs:
  a100-mixed:
    - devices: all
      mig-enabled: true
      mig-devices:
        "3g.20gb": 1
        "2g.10gb": 1
        "1g.5gb": 2
sudo nvidia-mig-parted apply -f mig-config.yaml -c a100-mixed5.5 원래대로 되돌리기
# Compute Instance → GPU Instance 순서로 삭제
sudo nvidia-smi mig -dci
sudo nvidia-smi mig -dgi

# MIG 끄기
sudo nvidia-smi -i 0 -mig 0

# 멈췄던 서비스 다시 시작
sudo systemctl start nvidia-persistenced nvidia-dcgm
6. 운영 시 주의점
| 항목 | 조치 |
| 재부팅 후 인스턴스 | MIG 모드는 유지되지만 GPU Instance와 Compute Instance는 재부팅하면 사라집니다. mig-parted나 systemd 서비스로 부팅 때 다시 만듭니다. |
| 변경 시 작업 중단 | 인스턴스를 지우거나 다시 나누려면 그 인스턴스를 쓰는 프로세스를 모두 멈춰야 합니다. |
| 프로필 고르기 | 모델 메모리를 먼저 계산하고 여유가 있는 프로필을 고릅니다(LLM 추론 GPU 메모리 계산 정리 참고). |
| 지원 안 되는 기능 | NCCL, GPU Instance 사이의 CUDA IPC, OpenGL·Vulkan 같은 그래픽 API는 쓸 수 없습니다. |
| Kubernetes | NVIDIA Device Plugin의 MIG Strategy를 single(nvidia.com/gpu) 또는 mixed(nvidia.com/mig-1g.5gb)로 정합니다. AKS는 노드풀을 만들 때 --gpu-instance-profile로 지정하고 나중에 바꿀 수 없습니다(AKS GPU 노드풀 구성 정리 참고). |
| 모니터링 | DCGM Exporter는 MIG 인스턴스별 지표를 따로 수집하므로, 인스턴스 단위로 사용률을 봅니다. |
7. 정리
- MIG는 GPU 한 장을 SM Slice 7개, Memory Slice 8개 단위로 나눠 최대 7개의 독립된 GPU처럼 쓰게 합니다.
- 인스턴스마다 메모리, 캐시, 대역폭이 분리되어 성능이 일정하고 장애가 옮겨 가지 않으며, 정해진 프로필과 자리 안에서만 나눌 수 있습니다.
- 작은 모델 추론과 개발용 실험에 잘 맞고, 여러 GPU를 묶는 큰 학습은 MIG를 끄고 GPU 전체를 씁니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [AI] LLM 추론 GPU 메모리 계산 정리 (0) | 2026.09.27 |
|---|---|
| [NVIDIA] NVLink와 NVSwitch 차이 정리 (0) | 2026.09.26 |
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (1) | 2026.09.26 |
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
| [NVIDIA] GPU 노드에서 랙까지 구성 정리 (0) | 2026.09.26 |
