양자화(Quantization)는 모델의 숫자를 더 적은 비트로 줄여 저장하는 기술입니다. 이 글에서는 FP16, INT8, INT4, FP8이 어떻게 다른지, GPTQ와 AWQ 같은 방식이 오차를 어떻게 줄이는지, 그리고 A100 40GB 1장에 7B 모델을 올릴 때 메모리와 속도가 얼마나 달라지는지를 계산으로 정리합니다.
1. 양자화란
LLM의 가중치(Weight, 학습으로 정해진 숫자)는 보통 FP16이나 BF16으로 저장해서 숫자 하나에 2바이트를 씁니다. 7B 모델이면 가중치만 약 15GB입니다. 양자화는 이 숫자를 8비트나 4비트 같은 더 작은 형식으로 바꿔 저장하는 것입니다. 1mm 눈금 자 대신 5mm 눈금 자로 재는 것과 비슷해서, 적어 둘 칸은 줄지만 눈금 사이 값은 가장 가까운 눈금으로 반올림됩니다.
추론에서 양자화의 효과가 큰 이유는 토큰을 하나 만들 때마다 가중치 전체를 GPU 메모리에서 한 번씩 읽어야 하기 때문입니다. 동시 요청이 적을 때는 계산 속도보다 이 읽기 속도(메모리 대역폭)가 전체 속도를 정하므로, 읽을 바이트가 줄면 그만큼 빨라집니다. 줄어든 메모리는 KV Cache(지금까지 읽은 문맥을 기억해 두는 값)에 쓸 수 있어 동시 요청도 늘어납니다. 추론 메모리를 계산하는 방법은 [AI] LLM 추론 GPU 메모리 계산 정리에서 다뤘습니다.
| 타입 | 크기 | 특징 | 비고(A100) |
| FP32 | 4바이트 | 학습할 때 기준이 되는 정밀도 | 지원 |
| FP16 · BF16 | 2바이트 | 추론 기본 형식 BF16은 표현 범위가 넓어 학습에 많이 씀 |
Tensor Core 연산 지원 |
| INT8 | 1바이트 | 정수로 저장하고 scale을 곱해 실수로 복원 | Tensor Core 연산 지원 |
| FP8 | 1바이트 | 8비트 실수, 정수보다 큰 값을 잘 다룸 | 연산 미지원 가중치 저장만 가능 |
| INT4 | 0.5바이트 | 대부분 가중치에만 쓰고, 그룹마다 scale을 둠 | 가중치 전용 커널로 사용 |
2. 숫자를 줄이는 원리
가장 기본적인 방식은 값들 중 가장 큰 절댓값을 기준으로 눈금 간격(scale)을 정하고, 각 값을 그 간격으로 나눠 반올림하는 것입니다. INT4는 -8부터 7까지 16개 눈금만 쓸 수 있습니다.
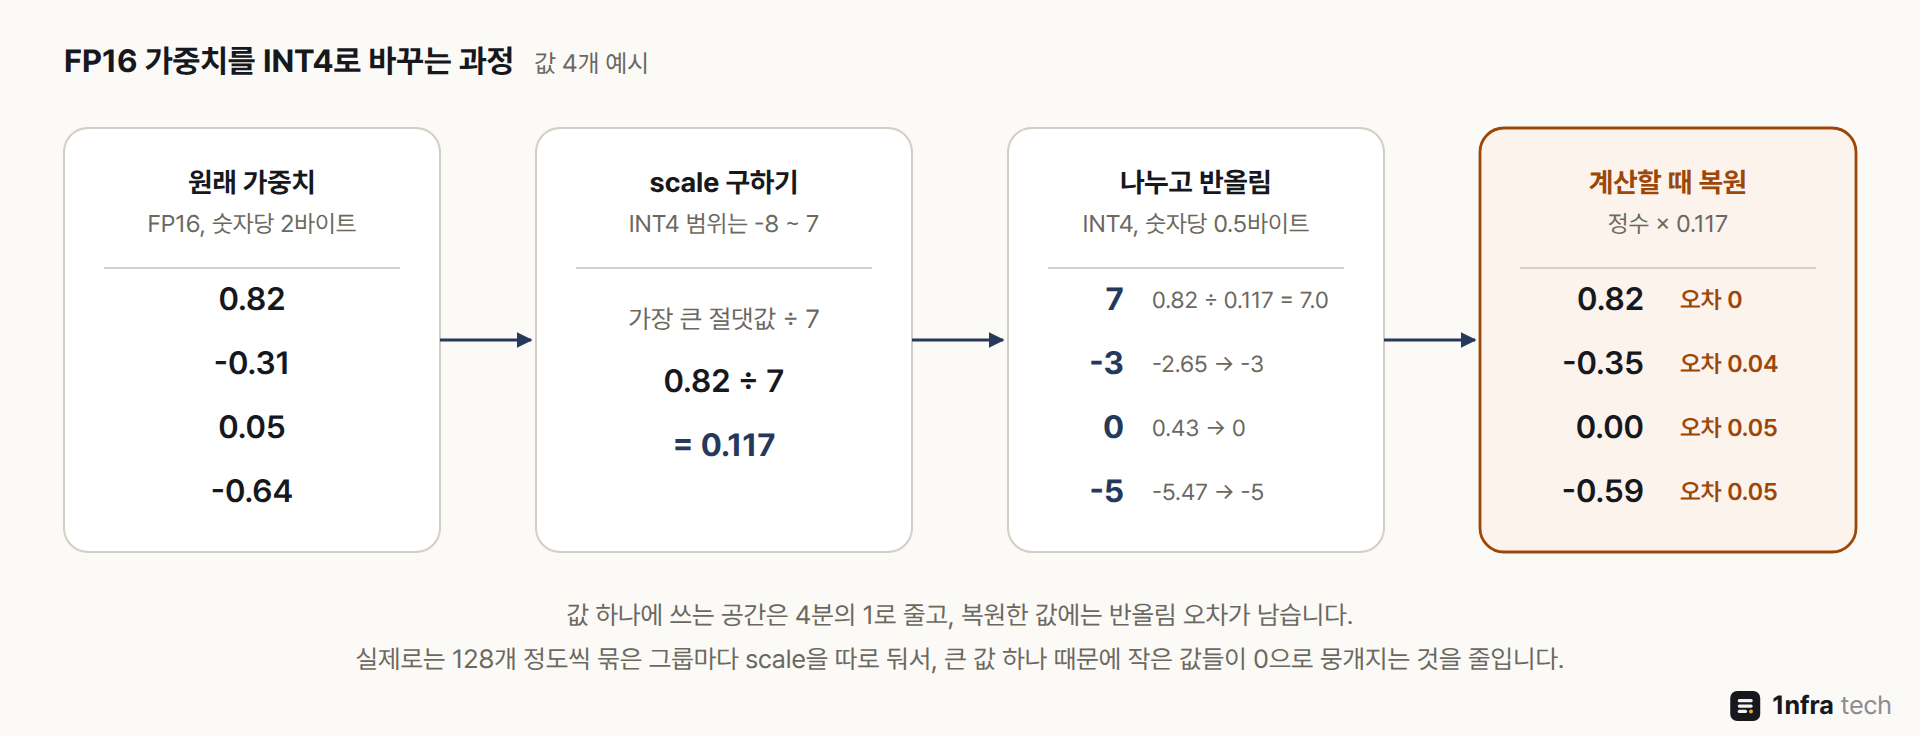
저장할 때는 정수와 scale만 두고, 계산할 때 정수에 scale을 곱해 원래 값에 가깝게 되돌립니다
문제는 큰 값(outlier) 하나가 섞여 있을 때입니다. 가장 큰 값에 맞춰 눈금 간격이 넓어지면 나머지 작은 값들은 대부분 0으로 반올림됩니다. 반 전체의 키를 1m 단위 자 하나로 재면 차이가 다 사라지는 것과 같아서, 128개 정도씩 묶은 그룹마다 scale을 따로 둡니다. 아래 방식들은 모두 이 반올림 오차를 줄이는 방법의 차이입니다.
| 항목 | 뜻 |
| scale | 정수 한 칸이 실제 값으로 얼마인지 나타내는 눈금 간격 |
| group size | scale 하나를 같이 쓰는 가중치 개수, 보통 128 |
| Activation | 입력이 레이어를 지나며 생기는 중간 값 |
| Calibration | 양자화할 때 활성값 분포를 보려고 넣는 샘플 문장 |
| W4A16 | 가중치(W)는 4비트, 활성값(A)은 16비트라는 표기 |
3. 방식 비교
3.1 무엇을 줄이는가
양자화는 가중치만 줄이는지, 활성값까지 줄이는지에 따라 효과가 달라집니다. 가중치만 줄이면 저장 공간과 읽는 양이 줄고, 계산 직전에 FP16으로 되돌려 계산합니다. 활성값까지 8비트로 줄이면 INT8이나 FP8 Tensor Core로 계산할 수 있어 동시 요청이 많을 때도 빨라집니다.
| 방식 | 동작 | 특징 | 비고(A100) |
| 가중치 전용 W8A16, W4A16 |
가중치만 저장할 때 줄이고 계산 직전에 FP16으로 복원 |
메모리 절약 동시 요청이 적을 때 빨라짐 |
사용 가능 |
| INT8 W8A8 | 가중치와 활성값 모두 INT8로 계산 | 동시 요청이 많을 때도 빨라짐 | 사용 가능 |
| FP8 W8A8 | 가중치와 활성값 모두 FP8로 계산 | INT8보다 큰 값을 잘 다룸 | W8A16으로만 동작 |
| KV Cache 양자화 | KV Cache를 8비트로 저장 | 긴 문맥과 동시 요청에 유리 | 모델별 품질 확인 |
3.2 어떻게 줄이는가
같은 4비트라도 오차를 줄이는 방법이 다릅니다. GPU 서빙에서 가장 많이 쓰는 GPTQ와 AWQ는 둘 다 학습이 끝난 모델을 Calibration 문장 수백 개로 변환하는 방식(PTQ)인데, 오차를 다루는 방향이 다릅니다.
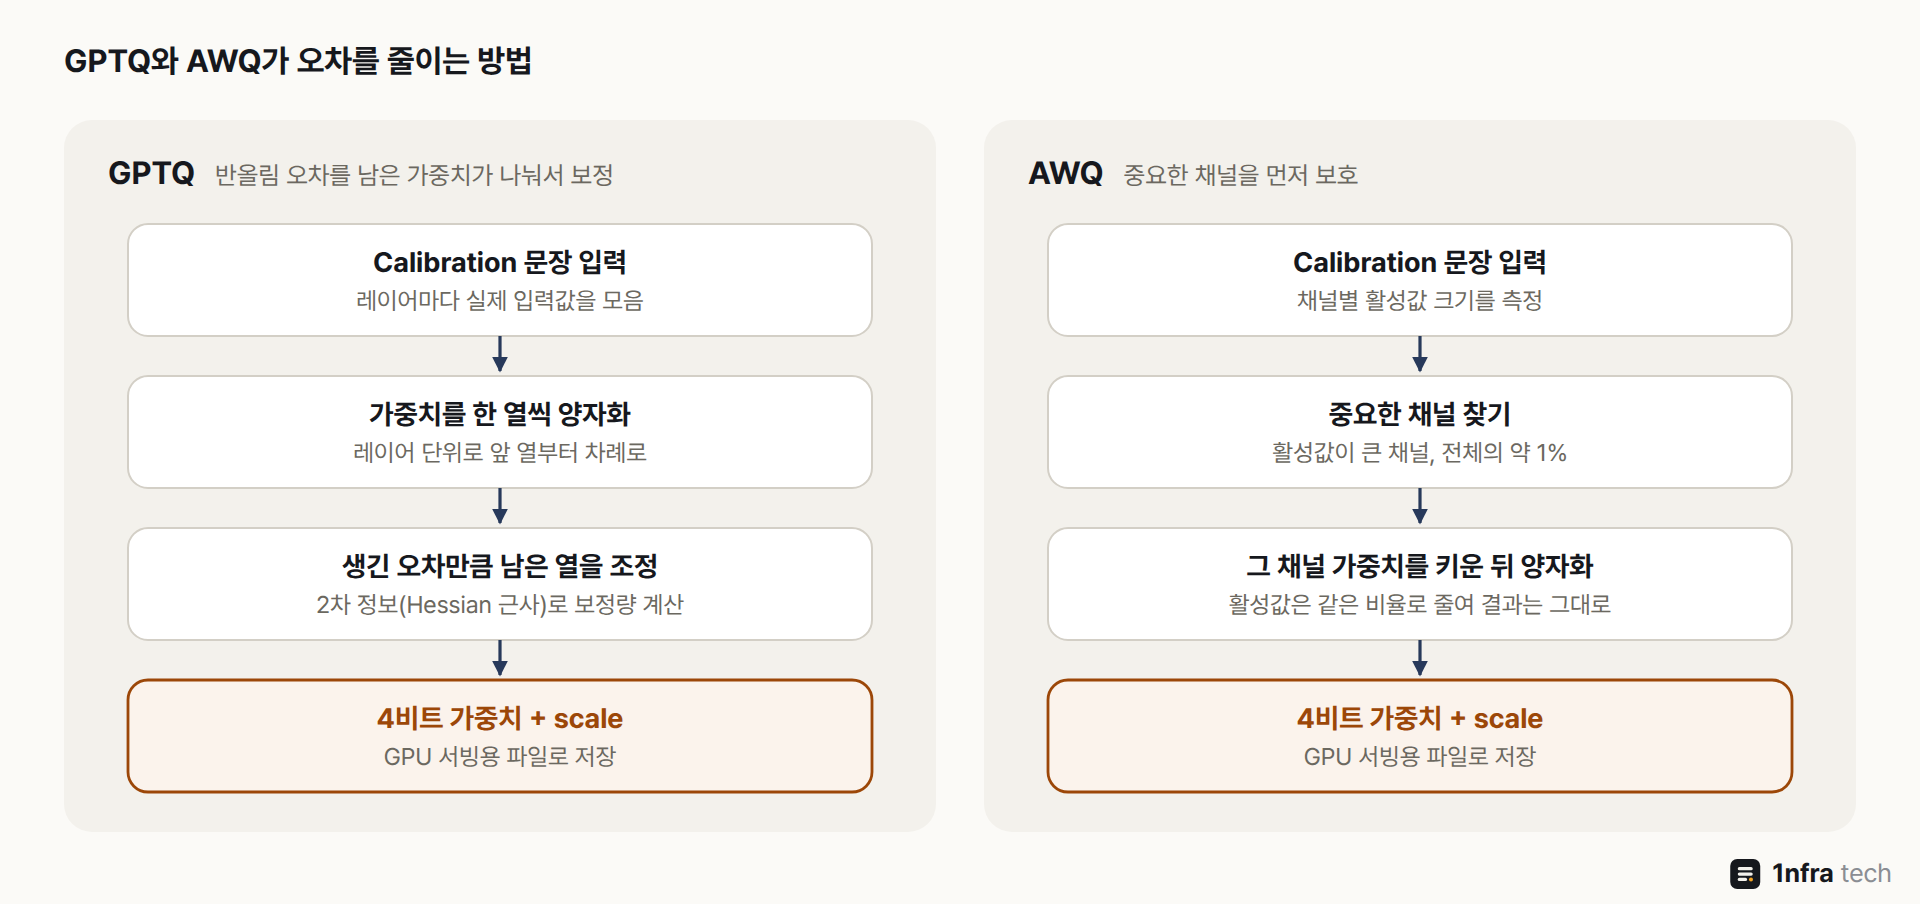
GPTQ는 생긴 오차를 뒤에서 메우고, AWQ는 중요한 부분에 오차가 생기지 않게 먼저 보호합니다
비유하면 GPTQ는 줄을 서서 반올림할 때 앞사람이 버린 만큼을 뒷사람들이 나눠 채우는 방식이고, AWQ는 이삿짐 중 깨지기 쉬운 몇 개만 골라 뽁뽁이로 한 번 더 싸는 방식입니다. 두 방식 모두 미리 변환한 파일을 받아 쓰고, 서빙할 때 속도는 비슷한 편이라 저는 모델 제작사가 공식으로 배포한 쪽을 먼저 고릅니다.
| 방식 | 동작 | 특징 | 용도 |
| GPTQ | 한 열씩 양자화하고 오차를 남은 열이 보정 |
Calibration 필요 4비트, 8비트 |
GPU 서빙 |
| AWQ | 활성값이 큰 채널을 찾아 키운 뒤 양자화 |
Calibration 필요 역전파가 없어 변환이 빠름 |
GPU 서빙 |
| SmoothQuant | 활성값의 큰 값을 가중치 쪽으로 옮긴 뒤 둘 다 INT8 |
W8A8을 가능하게 함 | 동시 요청이 많은 서빙 |
| bitsandbytes | 불러올 때 바로 양자화 큰 값은 FP16으로 따로 계산 |
Calibration 불필요 속도보다 메모리 절약이 목적 |
QLoRA 학습, 빠른 실험 |
| GGUF | llama.cpp의 파일 형식 Q4_K_M 같은 블록 단위 양자화 |
CPU와 Mac에서도 실행 | 로컬, 엣지 |
| FP8 | FP16 값을 scale 하나로 FP8 변환 | Calibration 없이도 가능 | H100 이후 GPU 서빙 |
3.3 학습과 추론에서의 양자화
추론에서는 학습이 끝난 모델을 변환하는 PTQ가 대부분이고, 학습에서는 메모리를 아껴 적은 GPU로 파인튜닝하는 데 양자화를 씁니다. 대표적인 예가 QLoRA로, 원본 모델은 4비트(NF4)로 얼려 두고 옆에 붙인 작은 LoRA 가중치만 학습합니다. 원본 요리책은 그대로 두고, 여백에 붙인 메모지만 고쳐 쓰는 셈입니다.
| 구분 | 학습 | 추론 |
| 기본 정밀도 | BF16 혼합 정밀도 (FP32 사본을 함께 보관) |
FP16 · BF16 |
| 양자화 시점 | QAT: 학습 중에 양자화 오차를 미리 반영 | PTQ: 학습이 끝난 모델을 변환 |
| 대표 방식 | QLoRA(NF4 + LoRA) | GPTQ, AWQ, INT8 W8A8, FP8 |
| 목적 | 적은 GPU로 파인튜닝 | 메모리 절약, 동시 요청, 속도 |
4. A100 40GB에서 계산해 보기
A100 40GB 1장에 Qwen2.5-7B-Instruct를 올리는 경우로 계산했습니다. Apache 2.0 라이선스이고, 제작사가 AWQ 4비트 버전을 같이 배포해서 원본과 비교하기 좋습니다. 크기는 GB(10억 바이트) 단위입니다.
4.1 가중치 크기
| 항목 | FP16 | INT8 | INT4 |
| Qwen2.5-7B | 15.2GB (배포 파일) |
약 8.7GB (계산) |
5.57GB (AWQ 배포 파일) |
| 70B급 모델 | 약 141GB | 약 71GB | 약 37GB 이상 A100 40GB 1장에는 부족 |
4비트면 7.6B개 × 0.5바이트로 3.8GB가 나와야 할 것 같지만 실제 파일은 5.57GB입니다. 입력 embedding과 마지막 출력 레이어(lm_head)의 약 10.9억 개는 품질 때문에 FP16으로 남겨 2.18GB를 차지하고, 128개마다 붙는 scale과 zero point도 함께 저장하기 때문입니다. 이 두 가지를 더해 계산하면 5.57GB로 배포 파일 크기와 맞습니다. 그래서 양자화 모델은 계산값보다 실제 파일 크기로 메모리를 잡는 것이 정확합니다.
4.2 KV Cache에 남는 공간
가중치가 줄어든 만큼 KV Cache를 더 둘 수 있습니다. 가중치를 4비트로 줄이면 같은 GPU에서 받을 수 있는 8K 토큰 요청 수가 44개에서 65개로 약 1.5배가 됩니다.
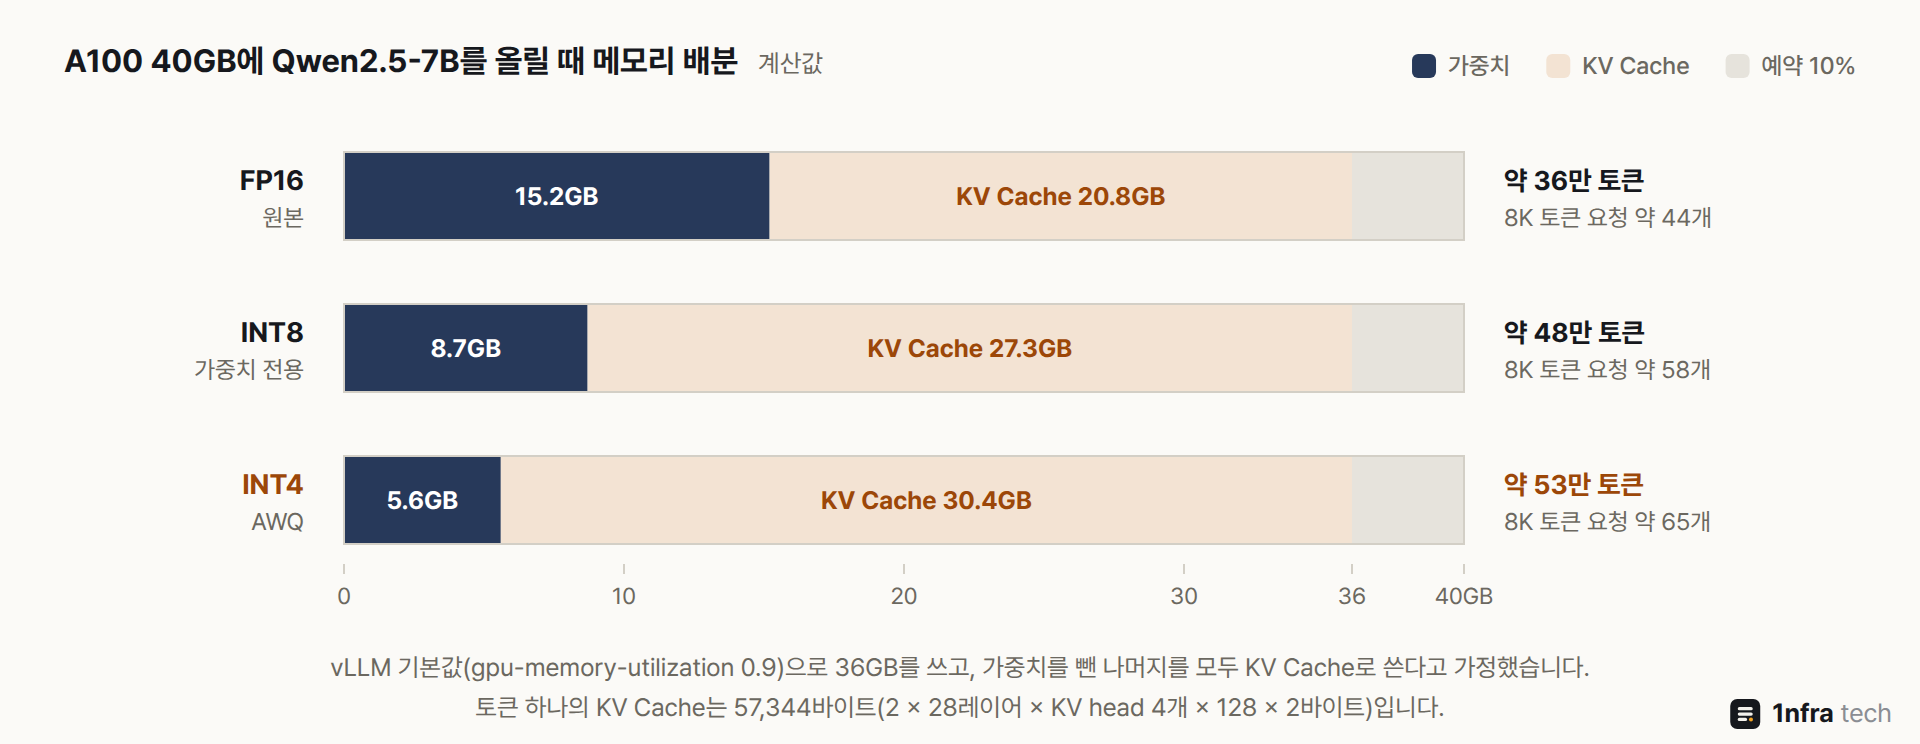
실제로는 활성값과 CUDA graph 등이 몇 GB를 더 쓰므로 여기서 조금 줄어듭니다
4.3 속도의 이론 상한
요청이 하나뿐일 때는 토큰 하나를 만들 때마다 가중치를 한 번 다 읽으므로, 메모리 대역폭을 가중치 크기로 나누면 초당 토큰 수의 상한이 나옵니다. A100 40GB의 메모리 대역폭은 1,555GB/s입니다.
| 항목 | FP16 | INT4(AWQ) |
| 토큰당 읽는 가중치 | 15.2GB | 5.57GB |
| 이론 상한(요청 1개) | 1,555 ÷ 15.2 = 약 102토큰/초 | 1,555 ÷ 5.57 = 약 279토큰/초 |
실제 속도는 KV Cache 읽기와 커널 효율 때문에 이보다 낮고, 4비트를 FP16으로 되돌리는 계산도 추가됩니다. 동시 요청이 많아져 계산이 병목이 되면 가중치 전용 양자화의 이득은 줄어들고, 이 구간에서는 INT8 W8A8처럼 활성값까지 줄여 INT8 Tensor Core로 계산하는 방식이 유리합니다.
4.4 vLLM으로 확인하기
vLLM은 모델의 config.json에 적힌 양자화 설정을 읽어서 자동으로 맞는 커널을 고르므로, 모델 이름만 바꿔 띄우면 됩니다.
# FP16 원본
vllm serve Qwen/Qwen2.5-7B-Instruct --max-model-len 8192

# AWQ 4비트
vllm serve Qwen/Qwen2.5-7B-Instruct-AWQ --max-model-len 8192
비교할 값은 시작 로그의 "Model loading took"(가중치 메모리)와 "Maximum concurrency for 8192 tokens per request"(동시 요청 수)입니다. nvidia-smi는 vLLM이 GPU 메모리의 90%를 미리 잡아 두기 때문에 두 경우 모두 비슷하게 보여서 비교에 쓸 수 없습니다.
FP8은 원본 모델에 옵션 하나로 켤 수 있습니다. 다만 A100은 FP8 연산을 하지 못해서, 가중치만 FP8로 저장하고 계산은 FP16으로 하는 W8A16으로 동작합니다. 메모리는 INT8 가중치 전용과 비슷하게 줄지만 FP8 연산으로 얻는 속도 이득은 없습니다.
vllm serve Qwen/Qwen2.5-7B-Instruct --quantization fp8 --max-model-len 81925. 운영 시 주의점
| 항목 | 조치 |
| 품질 확인 | 공개 벤치마크 점수만 보지 않고, 실제 업무 프롬프트 수십 개로 원본과 답을 나란히 비교 |
| 먼저 볼 영역 | 긴 문맥, 수학, 코드, 한국어처럼 차이가 드러나기 쉬운 작업을 따로 확인 |
| 메모리 비교 | nvidia-smi 대신 vLLM 로그의 가중치 크기와 동시 요청 수로 비교 |
| A100과 FP8 | FP8은 메모리 절약만 되고 연산 이득은 없음 A100에서는 AWQ · GPTQ 4비트나 INT8 W8A8이 현실적 |
| 동시 요청이 많을 때 | 가중치 전용 4비트는 이득이 줄거나 FP16보다 느릴 수 있으므로 실제 부하로 측정 |
| 모델 출처 | 모델 제작사가 배포한 양자화 버전을 우선 사용 개인이 올린 모델은 설정과 라이선스를 확인 |
| 직접 양자화 | AutoAWQ는 deprecated되어 vLLM 프로젝트의 llm-compressor로 옮겨감 |
| MIG와 함께 쓸 때 | 4비트 7B 모델도 5.57GB라 1g.5gb에는 올라가지 않음 2g.10gb 이상 인스턴스 필요 |
MIG 인스턴스 크기는 [NVIDIA] A100 MIG 구성 정리에서 정리했습니다.
6. 정리
- 양자화는 가중치를 적은 비트로 저장해 메모리와 읽는 양을 줄이고, 남은 메모리를 KV Cache에 돌려 동시 요청을 늘립니다.
- GPTQ는 오차를 뒤에서 보정하고 AWQ는 중요한 채널을 먼저 보호하며, 둘 다 A100에서 쓸 수 있는 4비트 가중치 전용 방식입니다.
- A100은 FP8 연산을 지원하지 않으므로, 메모리는 4비트로 줄이고 동시 요청이 많으면 INT8 W8A8을 검토합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [NVIDIA] A100 MIG 구성 정리 (0) | 2026.09.27 |
|---|---|
| [AI] LLM 추론 GPU 메모리 계산 정리 (0) | 2026.09.27 |
| [NVIDIA] NVLink와 NVSwitch 차이 정리 (0) | 2026.09.26 |
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (0) | 2026.09.26 |
| [NVIDIA] GPU 랙에서 클러스터까지 구성 정리 (0) | 2026.09.26 |
