Ollama는 내 PC나 GPU 서버에서 오픈 웨이트 LLM을 내려받아 실행하고 API로 제공하는 도구이고, Open WebUI는 그 API에 붙는 ChatGPT 형태의 웹 화면입니다. 둘을 함께 쓰면 데이터를 외부로 보내지 않는 사내용 챗봇을 몇 개의 명령으로 만들 수 있습니다. 다만 작은 모델은 질문이 모호하면 엉뚱하게 답하고, 버전과 설정에 따라 동작이 달라지므로 모델 크기와 설정을 직접 확인하며 쓰는 것이 중요합니다. 이 글에서는 Ollama와 Open WebUI의 구성을 정리하고, M1 Pro 맥북에서 gemma4와 qwen3.5를 실행해 속도, 메모리, API 호출, 웹 화면까지 확인합니다.
1. 로컬 LLM을 쓰는 이유
ChatGPT나 Claude 같은 서비스는 성능이 가장 좋지만, 입력한 데이터가 외부 서버로 나갑니다. 사내 로그나 설정 파일을 넣기 어려운 환경, 인터넷이 막힌 폐쇄망, 반복 호출 비용이 부담되는 자동화 작업에서는 내 장비에서 직접 모델을 돌리는 방법이 대안이 됩니다.
| 구분 | 장점 / 한계 |
| 데이터 | 입력과 대화 기록이 내 장비 밖으로 나가지 않음 / 장비 자체의 보안은 직접 책임져야 함 |
| 비용 | 호출당 과금 없음 / GPU 장비와 전기, 운영 인력 비용 |
| 성능 | 요약, 분류, 간단한 질의응답에는 충분 / 복잡한 추론과 긴 작업은 상용 최신 모델에 크게 못 미침 |
| 운영 | 모델과 버전을 직접 고정할 수 있음 / 모델 교체, 업데이트, 장애 대응을 직접 해야 함 |
생성형 AI에 어떤 데이터를 넣으면 안 되는지는 생성형 AI 업무 활용 시 보안 주의점 정리에서 다루었는데, 로컬 LLM은 그 제약을 상당 부분 덜어 주는 선택지입니다.
2. Ollama와 Open WebUI의 역할
Ollama는 모델 파일을 내려받아 GPU나 메모리에 올리고, 11434 포트로 API를 제공하는 서버입니다. Open WebUI는 사용자 관리, 대화 기록, 문서 검색(RAG) 같은 기능을 갖춘 웹 화면이며, 모델 실행은 Ollama에 맡깁니다.
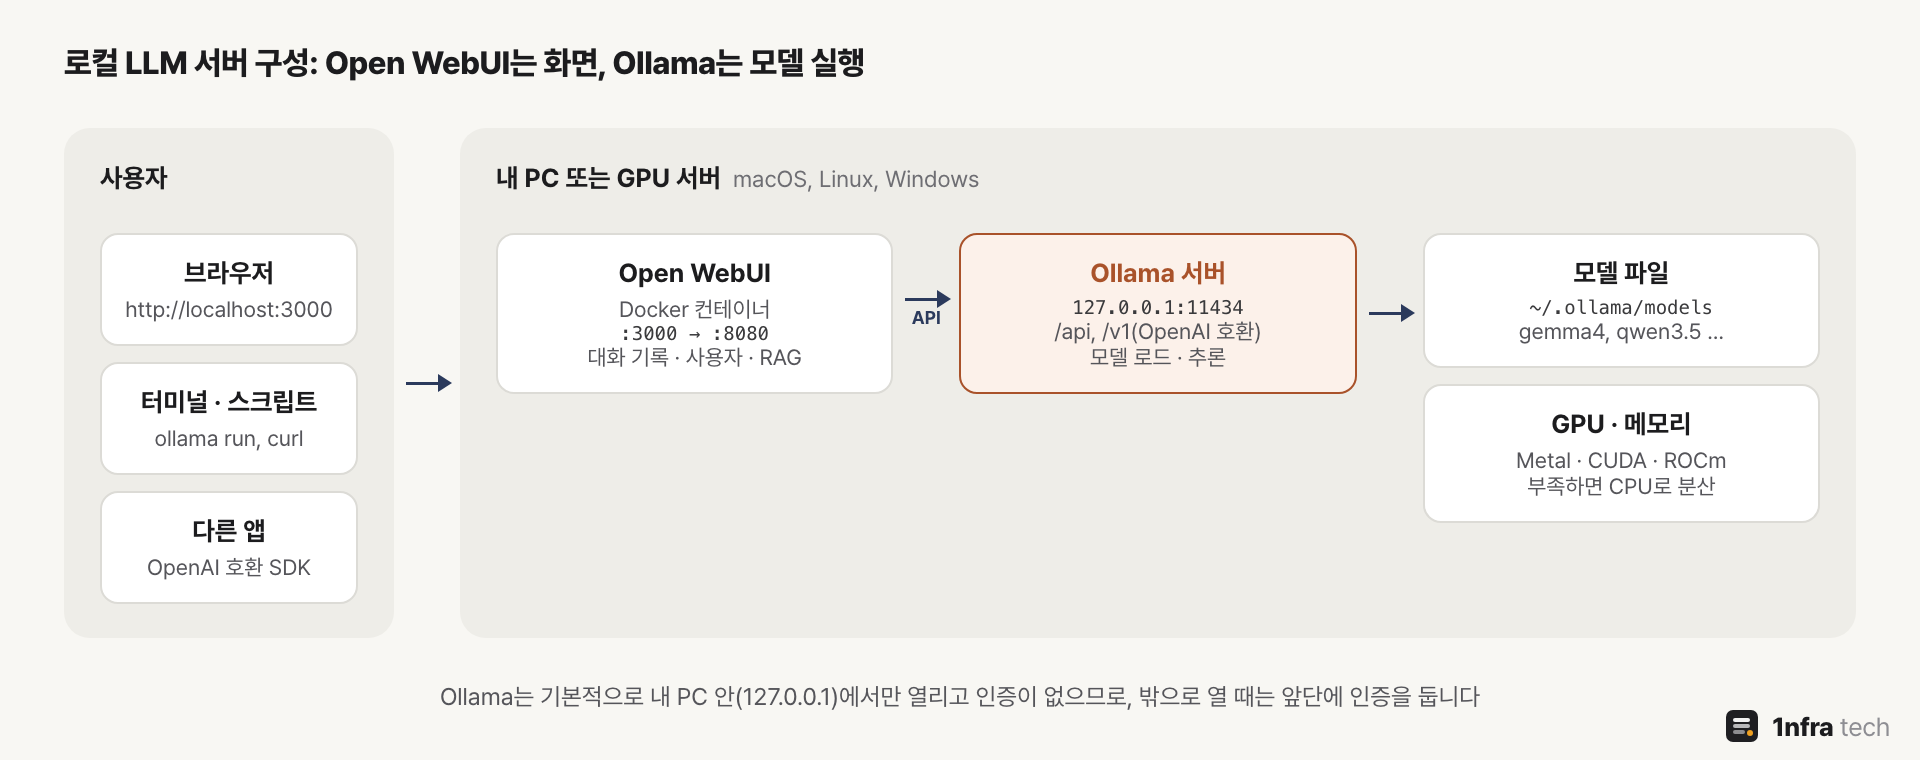
Open WebUI는 화면과 사용자 관리를, Ollama는 모델 실행과 API를 맡습니다
| 구성 요소 | 역할 |
| Ollama | 모델 다운로드와 실행, 자체 API(/api)와 OpenAI 호환 API(/v1) 제공, 기본적으로 127.0.0.1:11434에서만 열림 |
| 모델 파일 | macOS는 ~/.ollama/models에 저장, OLLAMA_MODELS로 위치 변경 |
| Open WebUI | 웹 화면, 사용자와 권한, 대화 기록, RAG, Docker 컨테이너로 실행 |
Ollama 공식 FAQ는 로컬 서버의 인증 기능을 따로 설명하지 않습니다. 기본 설정인 127.0.0.1 바인딩을 유지하면 내 PC에서만 접근할 수 있지만, 다른 PC에서 쓰려고 OLLAMA_HOST=0.0.0.0으로 열면 같은 네트워크의 누구나 모델을 호출할 수 있습니다. 여러 사람이 쓰는 서버라면 Ollama는 내부에만 두고 인증이 있는 Open WebUI나 리버스 프록시를 앞에 두는 구성이 안전합니다.
3. 모델 크기와 장비 고르기
모델이 필요로 하는 메모리는 파라미터 수와 양자화 방식, 컨텍스트 길이로 정해집니다. 계산 방법은 LLM 추론 GPU 메모리 계산 정리와 LLM 양자화 방식 비교 정리에서 다루었고, 여기서는 실제로 받은 모델의 크기를 확인합니다.
실습 장비는 Apple M1 Pro, 통합 메모리 32GB인 맥북입니다. Apple Silicon은 CPU와 GPU가 메모리를 함께 쓰기 때문에, 32GB 중 운영체제와 다른 프로그램이 쓰는 몫을 빼고 남는 만큼 모델을 올릴 수 있습니다. 처음에는 각 모델의 기본 태그(gemma4는 e4b, qwen3.5는 9b)를 받으려 했지만 다운로드 속도가 느려, 같은 계열의 작은 모델인 gemma4:e2b와 qwen3.5:4b로 바꿨습니다.
| 모델 | 특징과 실측 크기 |
| gemma4:e2b | Google의 Gemma 4 소형 모델, 이미지와 도구 사용, 사고(thinking) 지원, 파일 7.5GB, 실행 시 메모리 7.4GB |
| qwen3.5:4b | Alibaba의 Qwen 3.5 4B 모델, 이미지와 도구 사용, 사고 지원, 파일 4.0GB, 실행 시 메모리 4.1GB |
4. 실습: Ollama 설치와 모델 실행
macOS는 Homebrew나 공식 설치 파일로, Linux는 공식 스크립트로 설치합니다. 이 PC에는 예전에 설치한 Ollama 0.23.1이 있었는데, 최신 모델을 받으려 하자 다음 오류가 났습니다.
ollama pull gemma4Error: pull model manifest: 412:
The model you are attempting to pull requires a newer version of Ollama.
Please download the latest version at:
https://ollama.com/download새 모델은 새 버전의 Ollama가 있어야 실행되므로, 412 오류가 나면 Ollama부터 업데이트합니다. Homebrew로 설치했다면 다음과 같습니다.
brew upgrade ollama        # 0.23.1 -> 0.40.11
ollama serve               # 서버 실행 (Homebrew 서비스로 띄우려면 brew services start ollama)
ollama pull qwen3.5:4b
ollama pull gemma4:e2b
ollama list
NAME ID SIZE MODIFIED
gemma4:e2b 45d11505b91d 7.5 GB Less than a second ago
qwen3.5:4b 7f3251fa6878 4.0 GB 4 minutes ago같은 질문을 두 모델에 보내고 --verbose로 속도를 측정했습니다. 두 모델 모두 답하기 전에 생각하는 사고 기능이 있는데, 짧은 답을 비교하려고 --think=false로 껐습니다.
ollama run gemma4:e2b --verbose --think=false "쿠버네티스 Pod가 CrashLoopBackOff 상태일 때 확인할 순서를 3줄로 알려줘"쿠버네티스 Pod가 `CrashLoopBackOff` 상태일 때 확인해야 할 순서는 다음과 같습니다.
1. **Pod 로그 확인:** `kubectl logs <pod-name>`을 사용하여 애플리케이션이 왜 충돌하는지(예: 설정 오류, 코드 버그 등)를 확인합니다.
2. **컨테이너 이미지 및 설정 검토:** Dockerfile, 환경 변수, 볼륨 마운트 설정에 문제가 없는지 확인합니다.
3. **리소스 제한(CPU/메모리) 점검:** Pod가 할당된 리소스보다 부족하여 종료되는지 확인합니다.
total duration: 9.804655834s
load duration: 5.653540584s
prompt eval rate: 31.11 tokens/s
eval count: 132 token(s)
eval rate: 42.30 tokens/s(qwen3.5:4b)
먼저 `kubectl describe pod` 명령어로 해당 Pod 의 이력 (Events) 을 확인하고 관련 오류 로그를 파악합니다.
이어져서 해당 Pod 을 생성한 Deployment 이나 ReplicaSet 과의 차이점 등 상위 리소스를 함께 체크해 봅니다.
load duration: 4.513433542s
prompt eval rate: 12.88 tokens/s
eval count: 56 token(s)
eval rate: 32.64 tokens/s
| 항목 | gemma4:e2b / qwen3.5:4b |
| 답변 생성 속도 | 42.3 tokens/s / 32.6 tokens/s |
| 모델 로드 시간 | 5.7초 / 4.5초 (첫 호출에만 걸림) |
| 답변 품질 | 요청대로 3단계를 정확히 제시 / 2줄만 답하고 문장이 어색함 |
초당 30~40 토큰이면 사람이 읽는 속도보다 빠르므로 대화용으로는 충분합니다. 다만 이번 질문에서는 파일 크기가 더 큰 gemma4:e2b가 속도와 품질 모두 앞섰으므로, 모델은 파라미터 수만 보지 말고 실제 업무 질문으로 비교해 보고 고르는 것이 좋습니다.
모델이 메모리에 어떻게 올라갔는지는 ollama ps로 확인합니다.
ollama psNAME ID SIZE PROCESSOR CONTEXT RUNNER UNTIL
gemma4:e2b 45d11505b91d 7.4 GB 100% GPU 32768 mlx 4 minutes from now
| 열 | 의미 |
| PROCESSOR | 100% GPU면 모델 전체가 GPU에 올라간 상태, CPU 비율이 섞이면 메모리가 부족해 일부를 CPU로 돌리는 중이라 느려짐 |
| CONTEXT | 이번 환경에서는 32768 토큰, 공식 FAQ는 기본값을 4096으로 설명하므로 버전과 장비에 따라 다를 수 있어 직접 확인 필요 |
| RUNNER | Apple Silicon에서 mlx로 실행됨 |
| UNTIL | 마지막 호출 후 기본 5분 동안 메모리에 유지, OLLAMA_KEEP_ALIVE로 조정 |
5. 실습: API로 호출하기
Ollama는 자체 API와 OpenAI 호환 API를 함께 제공합니다. 기존에 OpenAI SDK로 만든 스크립트라면 주소만 http://localhost:11434/v1로 바꿔 그대로 쓸 수 있습니다.
curl -s http://localhost:11434/api/chat -d '{
  "model": "qwen3.5:4b",
  "messages": [{"role": "user", "content": "ConfigMap과 Secret의 차이를 한 문장으로"}],
  "stream": false, "think": false
}' | jq -r '.message.content'
ConfigMap 은 애플리케이션 설정 정보를 관리하는 데 사용되는 것으로, 민감한 정보는 포함하지 않은 반면, Secret 은 사용자 비밀번호나 인증 토크와 같이 기밀 데이터를 안전하게 저장하기 위해 사용됩니다.OpenAI 호환 API로 gemma4:e2b에 "PV와 PVC의 차이를 한 문장으로"라고 물었을 때는 예상과 다른 답이 나왔습니다.
curl -s http://localhost:11434/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "model": "gemma4:e2b",
  "messages": [{"role": "user", "content": "PV와 PVC의 차이를 한 문장으로"}]
}' | jq '{content: .choices[0].message.content, usage: .usage.completion_tokens}'
{
"content": "PVC(Polyvinyl Chloride)는 염소(Cl)를 포함하는 특정 폴리머이며, PV(Polyvinyl)는 이 폴리머 계열 전체를 포괄하는 더 넓은 용어라고 이해할 수 있습니다.",
"usage": 604
}쿠버네티스의 PV, PVC가 아니라 플라스틱 소재로 해석했습니다. 또 짧은 답인데 출력 토큰이 604개로 나왔는데, reasoning_effort를 none으로 지정해 사고를 끄자 같은 길이의 답이 27개 토큰으로 줄었습니다. /v1 호출에서는 사고 기능이 켜진 채로 동작해 생각한 토큰까지 함께 계산된 것으로 보입니다. 시스템 프롬프트로 "너는 쿠버네티스 운영을 돕는 인프라 엔지니어다"라고 역할을 줘도 "PV는 태양광 발전 시스템에 사용되고"라는 답이 나왔습니다. 질문에 "쿠버네티스의 PersistentVolume(PV)과 PersistentVolumeClaim(PVC)"처럼 전체 이름을 넣고 나서야 두 모델 모두 정확히 답했습니다.
(gemma4:e2b)
PersistentVolume(PV)은 클러스에서 제공하는 스토리지의 실제 용량과 종류를 나타내는 반면, PersistentVolumeClaim(PVC)은 사용자가 데이터를 저장하기 위해 원하는 스토리지의 요구사항을 명시하는 요청입니다.

(qwen3.5:4b)
PV(주요 저장소)는 클러스터 전체에서 할당 가능한 물리적 또는 가상 저장소를 정의하는 반면, PVC(클레임)는 특정 포드 (Pod) 가 필요로 할 공간과 속성을 명시하여 저장소 접근 권한을 요청하는 역할을 합니다.
작은 모델은 약어의 뜻을 문맥으로 추론하는 힘이 약합니다. 사내 업무에 붙일 때는 질문에 분야와 전체 용어를 넣거나, RAG로 관련 문서를 함께 넣어 주는 편이 결과가 안정적입니다. RAG 구성은 RAG 개념과 사내 문서 챗봇 구성 정리에서 다루었습니다.
6. 실습: Open WebUI 띄우기
Open WebUI는 Docker 이미지로 실행합니다. 공식 문서의 명령에서 포트를 127.0.0.1에만 열도록 바꿨습니다. -p 3000:8080처럼 쓰면 모든 네트워크 인터페이스에 열려 같은 네트워크의 다른 PC에서도 접속할 수 있기 때문입니다.
docker run -d -p 127.0.0.1:3000:8080 \
  --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data \
  -e WEBUI_SECRET_KEY=$(openssl rand -hex 32) \
  --name open-webui --restart always \
  ghcr.io/open-webui/open-webui:main
| 옵션 | 의미 |
| -p 127.0.0.1:3000:8080 | 내 PC에서만 http://localhost:3000으로 접속, 다른 PC에 열 때는 앞단에 HTTPS 리버스 프록시를 둠 |
| --add-host | 컨테이너 안에서 host.docker.internal로 호스트의 Ollama에 접속, 별도 설정이 없으면 이 주소의 11434 포트를 자동으로 찾음 |
| -v open-webui:... | 사용자, 대화 기록, 설정을 저장하는 볼륨, 업데이트 전에 백업 |
| WEBUI_SECRET_KEY | 로그인 세션 서명 키, 컨테이너를 다시 만들 때 바뀌면 모든 사용자가 로그아웃됨 |
처음 접속하면 관리자 계정을 만드는 화면이 나오고, 첫 계정이 관리자가 됩니다. 이 실습에서는 화면을 캡처하려고 -e WEBUI_AUTH=False로 로그인을 끈 단일 사용자 모드로 띄웠는데, 이 모드는 혼자 쓰는 PC에서만 쓰고 서버에서는 반드시 로그인을 켜 둡니다. 실습에 쓴 버전은 v0.12.4이고, 호스트의 Ollama에 받아 둔 두 모델이 별도 설정 없이 목록에 나타났습니다.
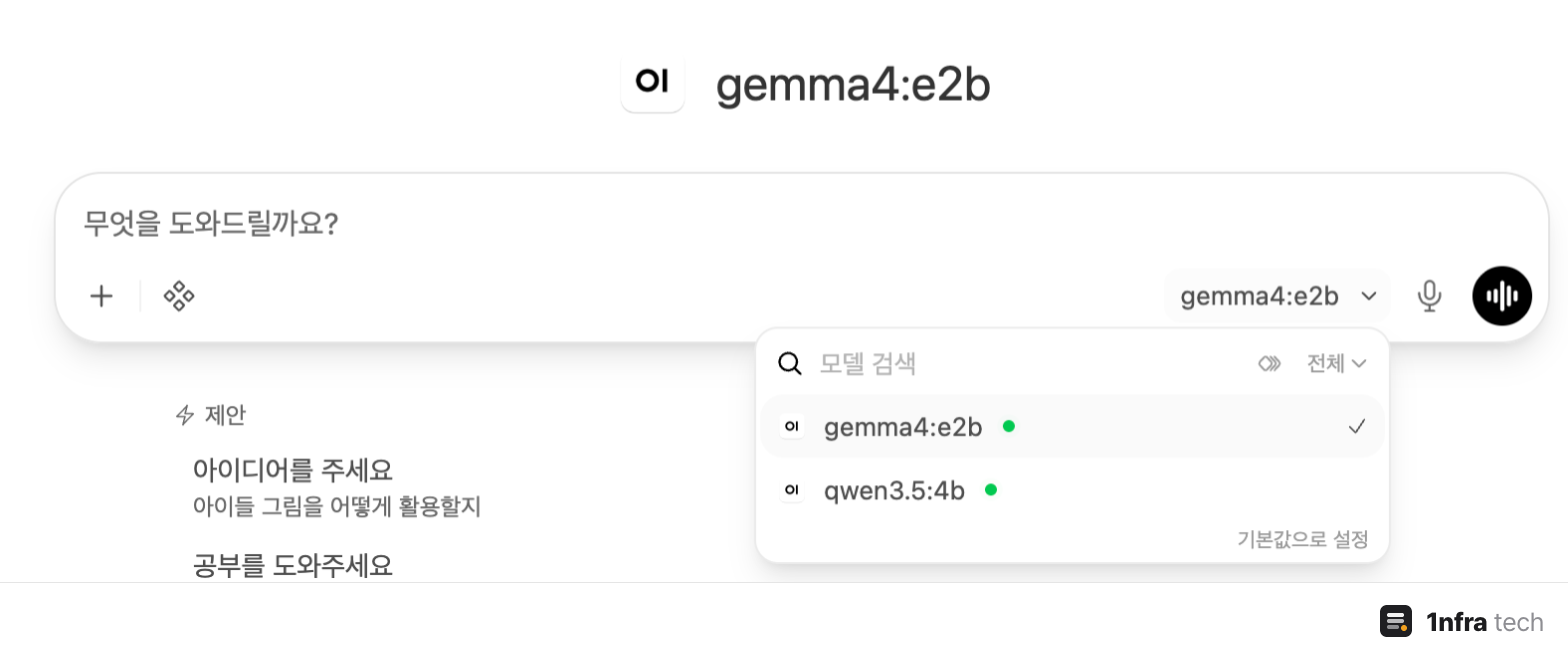
호스트의 Ollama에 받아 둔 모델이 별도 설정 없이 목록에 나타납니다
그런데 같은 CrashLoopBackOff 질문을 보내자 답변이 나오지 않았습니다. 모델이 Open WebUI의 내장 지식베이스 검색 도구(query_knowledge_bases, grep_knowledge_files)를 호출했다가 실패한 뒤, 본문 없이 후속 질문 제안만 남았습니다. 오른쪽 위 채팅 설정의 고급 매개변수에서 함수 호출을 기본값에서 레거시로 바꾸고 다시 묻자, 8초 동안 생각한 뒤 정상적으로 답했습니다.
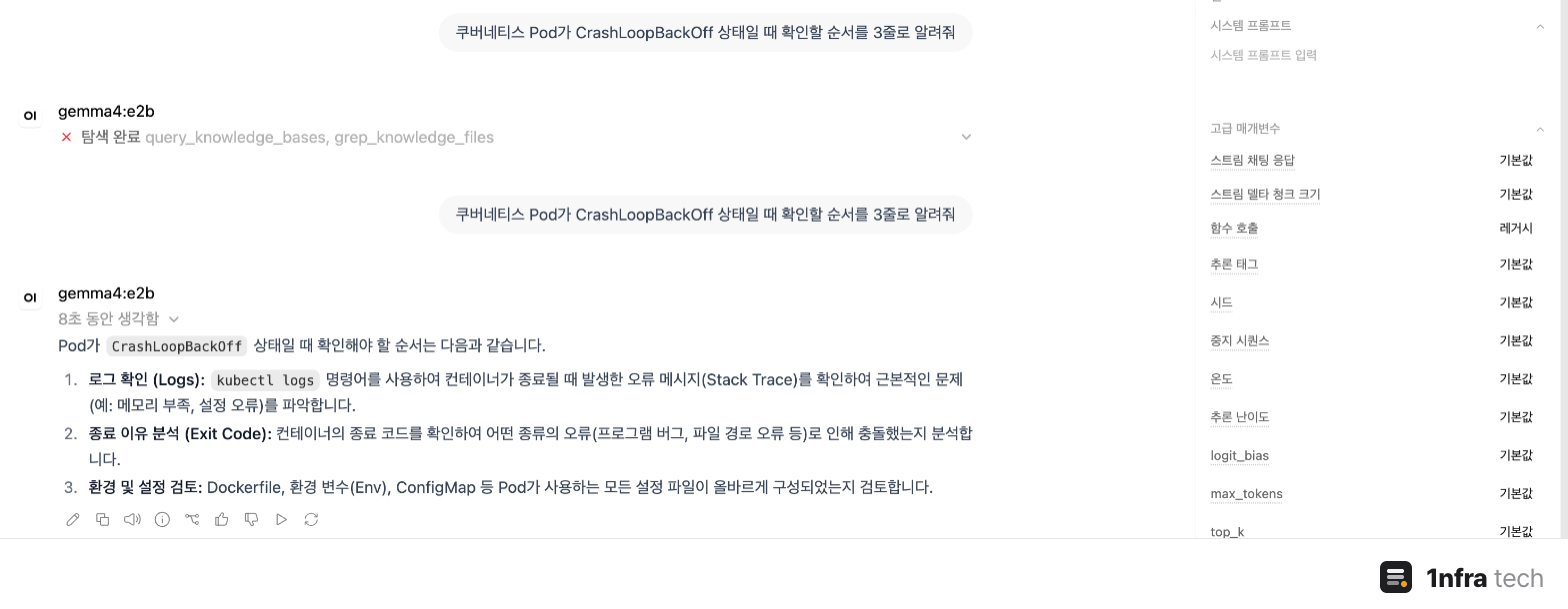
함수 호출이 기본값일 때는 도구 호출에 실패해 답이 비었고, 레거시로 바꾼 뒤 정상으로 답했습니다
함수 호출이 네이티브 방식이면 모델이 Open WebUI의 내장 도구를 직접 골라 호출하는데, 작은 모델은 이 도구 호출을 제대로 처리하지 못하는 경우가 있습니다. 작은 모델로 일반 대화를 할 때 답이 비어 있다면 함수 호출 설정부터 확인합니다.
7. 운영할 때 확인할 것
| 항목 | 확인할 내용 |
| 네트워크 | Ollama는 127.0.0.1 유지, 외부 접속은 인증이 있는 Open WebUI나 리버스 프록시를 거치게 함 |
| 인증 | Open WebUI 로그인 유지, 신규 가입은 관리자 승인 방식으로 |
| 버전 | 새 모델이 412 오류를 내면 Ollama 업데이트, Open WebUI는 업데이트 전 볼륨 백업 |
| 메모리 | ollama ps에서 100% GPU인지 확인, CPU 비율이 보이면 더 작은 모델이나 짧은 컨텍스트로 |
| 질문 방식 | 약어 대신 분야와 전체 용어를 넣고, 업무 문서는 RAG로 함께 전달 |
| GPU 서버 | 가상화 환경이면 GPU 패스스루로 VM에 GPU를 직접 할당 |
전용 GPU 서버로 옮길 때는 ESXi GPU 패스스루 설정에서 다룬 방식으로 VM에 GPU를 붙이고, 그 VM에 Linux용 Ollama를 설치하면 됩니다. 저는 처음에는 이번 실습처럼 개인 PC에서 업무 질문으로 모델을 비교해 보고, 쓸 만한 모델이 정해진 뒤에 서버를 마련하는 순서를 권합니다. 장비부터 사면 정작 필요한 모델 크기와 맞지 않는 경우가 생기기 때문입니다.
8. 정리
- Ollama는 모델 실행과 API를, Open WebUI는 웹 화면과 사용자 관리를 맡습니다.
- 새 모델을 받을 때 412 오류가 나면 Ollama를 먼저 업데이트합니다.
- M1 Pro 32GB에서 gemma4:e2b는 42.3 tokens/s, qwen3.5:4b는 32.6 tokens/s로 대화에 충분한 속도였고, 품질은 업무 질문으로 직접 비교해 고릅니다.
- 작은 모델은 약어를 엉뚱하게 해석하므로, 분야와 전체 용어를 질문에 넣거나 RAG로 문서를 함께 넣습니다.
- Ollama는 127.0.0.1에 두고 인증이 있는 화면을 앞에 두며, Open WebUI에서 답이 비면 함수 호출 설정을 확인합니다.
참고
'AI > 인프라' 카테고리의 다른 글
| [AI] LLM 양자화 방식 비교 정리 (0) | 2026.09.28 |
|---|---|
| [NVIDIA] A100 MIG 구성 정리 (0) | 2026.09.27 |
| [AI] LLM 추론 GPU 메모리 계산 정리 (0) | 2026.09.27 |
| [NVIDIA] NVLink와 NVSwitch 차이 정리 (0) | 2026.09.26 |
| [AI] 학습과 추론의 GPU 병렬화 방식 정리 (0) | 2026.09.26 |